
L1范数与L2范数
L1范数与L2范数
L1范数与L2范数在机器学习中,是常用的两个正则项,都可以防止过拟合的现象。L1范数的正则项优化参数具有稀疏特性,可用于特征选择;L2范数正则项优化的参数较小,具有较好的抗干扰能力。
1. 防止过拟合
L2正则项优化目标函数时,一般倾向于构造构造较小参数,一般认为,参数值较小的模型相对简单,能适应不同的数据集,在一定程度上避免过拟合的现象,参数较小,数据偏移带来的影响也会较小,从而说L2正则项具有较好的抗干扰能力,从而实现防止过拟合的现象。
L1正则项也可以防止过拟合现象,主要是利用了L1正则项优化参数的稀疏特性。一个简单的模型,配置参数越少,复杂度越小,而稀疏化的参数,模型的的很多参数都变为0,达到减少参数的目的,从而实现防止过拟合的现象。
例子1:
假设有数据点10个数据点,分别为:(0, -2), (10, 18), (20, 15), (30, 35), (40, 42), (50, 50), (60, 66), (70, 76), (80, 77), (90, 85),如图1(见代码1)。
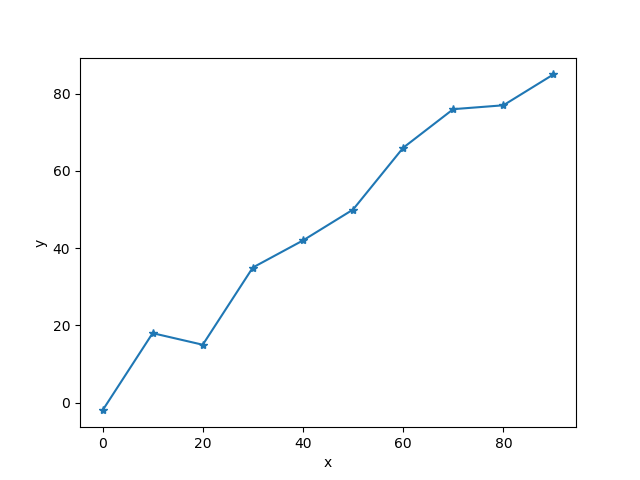
图1 样例数据点
假设该模型为线性模型,即 \(y=ax+b\) 。通过均方误差(MSE)的方式,求解参数\(a\)和\(b\)的值,设上面的10个点分别表示为 \((x_1,y_1),...,(x_{10},y_{10})\) ,目标函数表示为:
L &= \sum\limits_{i = 1}^{10} {{{\left( {{y_i} - \left( {a{x_i} + b} \right)} \right)}^2}}
\nonumber\\
&= \left( {Y - AX} \right){\left( {Y - AX} \right)^T}
\end{align}
\]
其中,\(Y = \left( {{y_1},...,{y_N}} \right) \in {R^{1 \times N}}\),\(A = \left( {a,b} \right) \in {R^{1 \times 2}}\),\(X = \left( {\begin{array}{*{20}{c}}
{{x_1}}& \cdots &{{x_N}}\\
1& \cdots &1
\end{array}} \right) \in {R^{1 \times N}}\)。
求解:
\\ A = Y{X^T}{\left( {X{X^T}} \right)^{ - 1}}
\\ A = \left( {\begin{array}{*{20}{c}}
{0.971}&{{\rm{2}}{\rm{.509}}}
\end{array}} \right)
\]
(结果见代码1)。
添加L2正则项,
\]
求解得到
\\ A = \left( {\begin{array}{*{20}{c}}
{{\rm{0}}{\rm{.985}}}&{{\rm{1}}{\rm{.623}}}
\end{array}} \right)
\]
(结果见代码2)。
# 代码1

import numpy as np

import matplotlib.pyplot as plt

from numpy.linalg import inv

if __name__ == '__main__':

    x = np.arange(0, 100, 10)

    np.random.seed(2019)

    y = x + np.random.randint(-10, 11, 10)

    data = list(zip(x, y))

    print(data)

    # [(0, -2), (10, 18), (20, 15), (30, 35), (40, 42), (50, 50), (60, 66),

    # (70, 76), (80, 77), (90, 85)]

    plt.plot(x, y, '-*')

    plt.xlabel('x')

    plt.ylabel('y')

    plt.show()

    X = np.vstack((np.array(x), np.ones(len(x))))

    Y = np.array(y)

    A = Y.dot(X.T).dot(inv(X.dot(X.T)))

    print(A)  # [0.97090909 2.50909091]
2. L1正则化的稀疏解释
首先阐述一下为什么需要稀疏。
假设有样本\(x \in R^m\), \(X=(x_1,...,x_N)\)是\(N\)个样本,\(x_i\)是列向量,这\(N\)个样本的类别表示为\(Y=(y_1,...,y_N)\),假设\(m>N\),现有一个线性模型\(Y=\theta X\), \(\theta \in R^m\), 由于\(m>N\),所以$ \theta $ 有无数个解,\(x_i\) 是 \(m\) 维的列向量,可能并不是所有的属性对构建模型都是有效的,此时需要筛选出一些有用的属。这里对于无用的属性,可以使用 $ \theta $ 筛选,在指定位置置零即可,除掉 \(X\) 中无用的属性,此时可能有 \(m_{new} < N\) 该线性模型可能得到唯一解。但是,如何寻找稀疏的 $ \theta $ 呢?
参考:https://vimsky.com/article/3852.html
L1范数与L2范数的更多相关文章
- L1范数与L2范数正则化
2018-1-26 虽然我们不断追求更好的模型泛化力,但是因为未知数据无法预测,所以又期望模型可以充分利用训练数据,避免欠拟合.这就要求在增加模型复杂度.提高在可观测数据上的性能表现得同时,又需要兼顾 ...
- L1范数和L2范数
给定向量x=(x1,x2,...xn)L1范数:向量各个元素绝对值之和L2范数:向量各个元素的平方求和然后求平方根Lp范数:向量各个元素绝对值的p次方求和然后求1/p次方L∞范数:向量各个元素求绝对值 ...
- 正则化的L1范数和L2范数
范数介绍:https://www.zhihu.com/question/20473040?utm_campaign=rss&utm_medium=rss&utm_source=rss& ...
- Lp距离, L1范数, 和L2范数(转载)
范式可以理解成距离 转载自: https://blog.csdn.net/hanhuili/article/details/52079590 内容如下: 由此可见,L2其实就是欧式距离.工程上,往往不 ...
- paper 126:[转载] 机器学习中的范数规则化之(一)L0、L1与L2范数
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数(转)
http://blog.csdn.net/zouxy09/article/details/24971995 机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http: ...
- L0/L1/L2范数的联系与区别
L0/L1/L2范数的联系与区别 标签(空格分隔): 机器学习 最近快被各大公司的笔试题淹没了,其中有一道题是从贝叶斯先验,优化等各个方面比较L0.L1.L2范数的联系与区别. L0范数 L0范数表示 ...
- L0、L1与L2范数、核范数(转)
L0.L1与L2范数.核范数 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化.我们先简单的来理解下常用的L0.L1.L2和核范数规则化.最后聊下规则化项参数的选择问题.这里因为篇幅比较庞大 ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数 非常好,必看
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
随机推荐
- yum 运行失败
https://stackoverflow.com/questions/47633870/rpm-lib64-liblzma-so-5-version-xz-5-1-2alpha-not-found- ...
- SQL SERVER-时间戳(timestamp)与时间格式(datetime)互相转换
SQL里面有个DATEADD的函数.时间戳就是一个从1970-01-01 08:00:00到时间的相隔的秒数.所以只要把这个时间戳加上1970-01-01 08:00:00这个时间就可以得到你想要的时 ...
- python迭代-如何对迭代器做切片操作
如何对迭代器做切片操作 问题举例 读取某个文件内容的100~300行内容,我们是否可以使用 类似列表切片的方式得到一个100~300行文件内容的生成器 分析 列表的切片操作其实是在重载方法__getI ...
- centos7.5 安装gaussian09和 gaussianview4
一.安装gaussian09 1. 解压安装包 $ mkdir Gaussian$ cd Gaussian$ tar xvf g09_linux.tar 2. 设置环境变量 #gaussian09 e ...
- Cocos Creator LabelAtlas(艺术数字的使用)
# 艺术数字资源 (LabelAtlas) **艺术数字资源** 是一种用户自定义的资源,它可以用来配置艺术数字字体的属性. ## 创建艺术数字资源 在 **资源管理器** 中右键,可以在如下菜单中找 ...
- JDK1.8 HashMap--treeifyBin()方法
/*树形化*/ final void treeifyBin(Node<K,V>[] tab, int hash) { int n, index; Node<K,V> e;// ...
- ELK+Filebeat 集中式日志解决方案详解
链接:https://www.ibm.com/developerworks/cn/opensource/os-cn-elk-filebeat/index.html?ca=drs- ELK Stack ...
- 阿里负载均衡,配置中间证书问题(在starcom申请免费DV ssl)
前提假如免费版相关证书都已经配置到位,但是微信小程序Android访问有问题,检测域名(https://www.myssl.cn/tools/check-server-cert.html)发现服务器缺 ...
- 18.11.20-C语言练习-根据输入统计字符类型
一.题目: 二.C程序:(注意:中文部分是程序注释,如果编译器不支持中文,需要把中文删掉) #include <stdio.h> int main() { ; //保存字母数量 ; //保 ...
- 已有的PHP安装gd扩展
第一步 安装依赖 1.安装xpm yum install libXpm-devel 2.安装zlib wget http://zlib.net/zlib-1.2.8.tar.gz tar -xzvf ...