
Scrapy_redis
简介
scrapy_redis是一个基于Redis的Scrapy组件,用于scrapy项目的分布式部署和开发
你可以启动多个spider对象,互相之间共享有一个redis的request队列,最适合多个域名的广泛内容的爬取
特点
分布式爬取
分布式数据处理
爬取到的item数据被推送到redis中,这意味着你可以启动尽可能多的item处理程序
scrapy即插即用
scrapy调度程序+过滤器,项目管道,base spidre
安装
pip install scrapy-redis
使用
首先创建scrapy的项目
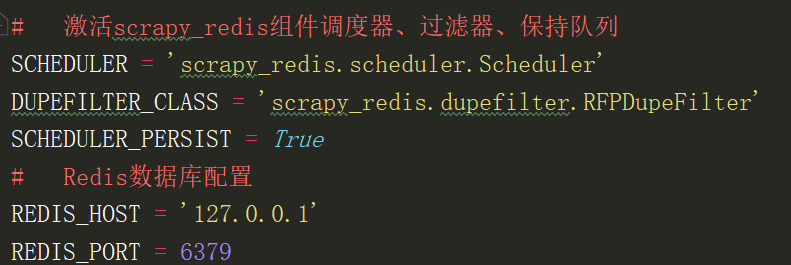
在settings修改默认的调度器和过滤
SCHEDULER = 'scrapy_redis.scheduler.Scheduler'
DUPEFILTER_CLASS = 'scrapy_redis.dupefilter.RFPDupeFilter'
SCHEDULER_PERSIST = True
在spider里面修改继承的类RedisSpider,属性redis_key

常用设置
# 启用调度将请求存储进redis SCHEDULER = "scrapy_redis.scheduler.Scheduler"
# 确保所有spider通过redis共享相同的重复过滤 DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"
# 不清理redis队列,允许暂停/恢复抓取 SCHEDULER_PERSIST = True
# 指定连接到Redis时要使用的主机和端口 REDIS_HOST = 'localhost'
REDIS_PORT = 6379
redis中存储的数据
spidername:items list类型,保存爬虫获取到的数据item内容是json字符串
spidername:dupefilter set类型,用于爬虫访问的URL去重,内容是40个字符的url的hash字符串
spidername:start_urls list类型,用于接收redisspider启动时的第一个url
spidername:requests zset类型,用于存放requests等待调度。内容是requests对象的序列化字符串
Scrapy_redis的更多相关文章
- scrapy分布式爬虫scrapy_redis二篇
=============================================================== Scrapy-Redis分布式爬虫框架 ================ ...
- scrapy分布式爬虫scrapy_redis一篇
分布式爬虫原理 首先我们来看一下scrapy的单机架构: 可以看到,scrapy单机模式,通过一个scrapy引擎通过一个调度器,将Requests队列中的request请求发给下载器,进行页 ...
- scrapy_redis 相关: 多线程更新 score/request.priority
0.背景 使用 scrapy_redis 爬虫, 忘记或错误设置 request.priority(Rule 也可以通过参数 process_request 设置 request.priority), ...
- scrapy_redis 相关: 查看保存的数据
0.参考资料 https://redis.io/topics/data-types-intro An introduction to Redis data types and abstractions ...
- scrapy_redis实现爬虫
1.scrapy_redis的流程 在scrapy_redis中,所有的带抓取的对象和去重的指纹都存在所有的服务器公用的redis中 所有的服务器公用一个redis中的request对象 所有的req ...
- scrapy_redis项目配置
一.创建普通scrapy项目 二.spiders爬虫文件中修改项 import scrapy from XX.items import XXItem import json # ----1 导入类 f ...
- scrapy和scrapy_redis入门
Scarp框架 需求 获取网页的url 下载网页内容(Downloader下载器) 定位元素位置, 获取特定的信息(Spiders 蜘蛛) 存储信息(ItemPipeline, 一条一条从管里走) 队 ...
- 定制起始url(scrapy_redis)
爬虫:(在这里不用配置start_url,直接可以取redis里面取start_url,可以多个) from scrapy_redis.spiders import RedisSpider # cla ...
- [置顶]使用scrapy_redis,自动实时增量更新东方头条网全站新闻
存储使用mysql,增量更新东方头条全站新闻的标题 新闻简介 发布时间 新闻的每一页的内容 以及新闻内的所有图片.项目文件结构. 这是run.py的内容 1 #coding=utf-8 2 from ...
- 使用scrapy_redis,实时增量更新东方头条网全站新闻
存储使用mysql,增量更新东方头条全站新闻的标题 新闻简介 发布时间 新闻的每一页的内容 以及新闻内的所有图片.东方头条网没有反爬虫,新闻除了首页,其余板块的都是请求一个js.抓包就可以看到. 项目 ...
随机推荐
- C++之typename和typedef关键字
1. typename的作用 template <typename Distance> class KDTreeIndex : public NNIndex<Distance> ...
- SpringCloud微服务实现生产者消费者+ribbon负载均衡
一.生产者springcloud_eureka_provider (1)目录展示 (2)导入依赖 <dependency> <groupId>org.springframewo ...
- 一文带你深入了解JVM性能调优以及对JVM调优的全面总结
目录 JVM调优 概念 基本垃圾回收算法 垃圾回收面临的问题 分代垃圾回收详述1 分代垃圾回收详述2 典型配置举例1 典型配置举例2 新一代的垃圾回收算法 调优方法 反思 一.JVM调优的一些概念 数 ...
- Jmeter 查看结果树之界面功能介绍 [8]
查看结果树显示所有请求响应的树,通过它可以查看任何请求的响应.除了显示响应之外,还可以查看获取响应所花费的时间以及一些响应代码.需要通过"查看结果树"来查看服务器处理请求之后的返回 ...
- 精通awk系列(6):awk命令结构和awk语法结构
回到: Linux系列文章 Shell系列文章 Awk系列文章 awk命令行结构和语法结构 awk命令行结构 awk [ -- ] program-text file ... (1) awk -f p ...
- 初窥R(基本说明、获取帮助、工作空间、输入输出、包)
本篇简要介绍使用R的一些基本概念,包括基本说明.获取帮助.工作空间.输入输出,每个知识点中都会通过一个例子来练习. 一.R基本情况说明 1.R是一种区分大小写的解释性语言. 2.控制台默认使用命令提示 ...
- C# FlagAttriute 的 小妙招
FlagAttriute ,指示可将枚举视为位域(即一组标志). 官网中文解说:https://docs.microsoft.com/zh-cn/dotnet/api/system.flagsattr ...
- 易优CMS:switch的基础用法
[基础用法] 名称:switch 功能:简单条件判断,比if判断标签少些不等于相同功能,视个人习惯而用. 语法: {eyou:switch name='$eyou.field.has_children ...
- HeadFirst设计模式<2>
HeadFirst设计模式<2> 1 装饰者模式 星巴克咖啡 饮料 总结 如果说策略模式是通过组合实现弹性,那么装饰者模式就是通过继承来实现,在实现的同时,客户基本感觉不到使用了装饰者模式 ...
- 一些实用的Django+HTML设置
一.关于引入变量 1.变量引入方法: {% block 块名称 %} <p>{{变量名}}<p> {% endblock %} 2.引入变量的值中标签是否转义: 不转义: {% ...