
使用IDEA打包scala程序并在spark中运行
一、首先配置ssh无秘钥登陆,
先使用这条命令:ssh-keygen,然后敲三下回车;
然后使用cd .ssh进入 .ssh这个隐藏文件夹;
再创建一个文件夹authorized_keys,使用命令touch authorized_keys;
然后使用cat id_rsa.pub > authorized_keys 即可;
最后使用 chmod 600 authorized_keys修改权限就完成了。
二、创建spark项目
idea创建spark项目的过程这里就略过了,具体可以看这里https://www.cnblogs.com/xxbbtt/p/8143441.html
三、在pom.xml加入相关的依赖包
在pom.xml文件中添加:
    <properties>

        <spark.version>2.1.0</spark.version>

        <scala.version>2.11</scala.version>

    </properties>

    <dependencies>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-core_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-streaming_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-sql_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-hive_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-mllib_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <groupId>org.scala-tools</groupId>

                <artifactId>maven-scala-plugin</artifactId>

                <version>2.15.2</version>

                <executions>

                    <execution>

                        <goals>

                            <goal>compile</goal>

                            <goal>testCompile</goal>

                        </goals>

                    </execution>

                </executions>

            </plugin>

            <plugin>

                <artifactId>maven-compiler-plugin</artifactId>

                <version>3.6.0</version>

                <configuration>

                    <source>1.8</source>

                    <target>1.8</target>

                </configuration>

            </plugin>

            <plugin>

                <groupId>org.apache.maven.plugins</groupId>

                <artifactId>maven-surefire-plugin</artifactId>

                <version>2.19</version>

                <configuration>

                    <skip>true</skip>

                </configuration>

            </plugin>

        </plugins>

    </build>
然后等待就好了。。。
四、编写一个示范程序
创建一个scala类,并写以下代码,也可以是其他的,这里只是测试而已
object first {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setAppName("wordcount")

    val sc = new SparkContext(conf)

    val input = sc.textFile("/home/cjj/testfile/helloSpark.txt")

    val lines = input.flatMap(line => line.split(" "))

    val count = lines.map(word => (word, 1)).reduceByKey { case (x, y) => x + y }

    val output = count.saveAsTextFile("/home/cjj/testfile/helloSparkRes")

  }

}
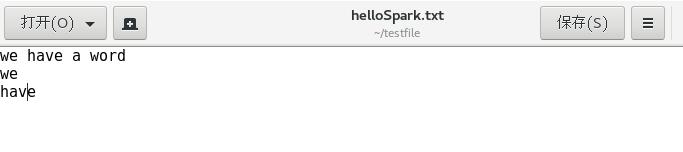
这里使用了Spark实现的功能是,计算helloSpark.txt这个文件各个单词出现的次数,并保存在helloSparkRes文件夹中。
五、打包
file->Porject Structure->Artifacts->绿色的加号->JAR->from modules...
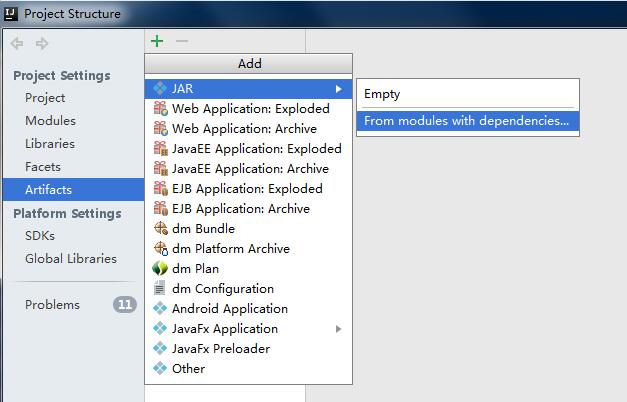
跳出以下对话框,选择要打包的类,然后选择copy to.....选项,这里的意思是只打包这一个类。
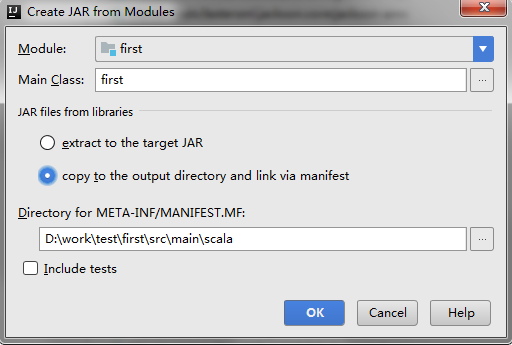
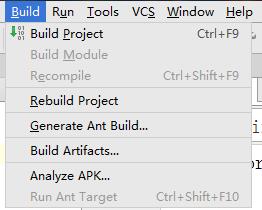
然后点击ok,然后ok。然后build->build Artifacts
再然后点击build
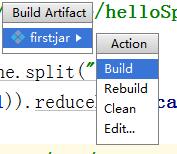
等待build完成。然后可以在项目的这个目录中找到刚刚打包的这个jar包
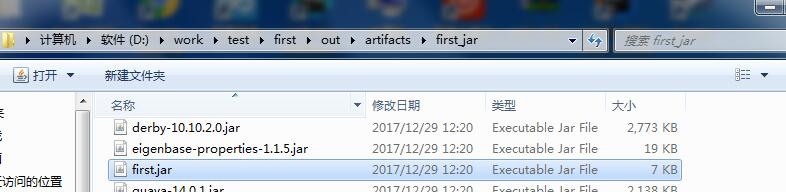
这里的first的我的项目名。
六、启动集群
先将刚才打包的jar包复制到虚拟机中,
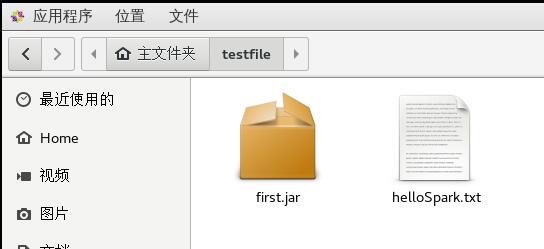
helloSpark.txt是我将要操作的文件。接着就是启动集群,分为三步
- 启动master ./sbin/start-master.sh
- 启动worker ./bin/spark-class
- 提交作业 ./bin/spark-submit
首先进入spark-2.2.1-bin-hadoop2.7文件夹,然后运行命令./sbin/start-master.sh
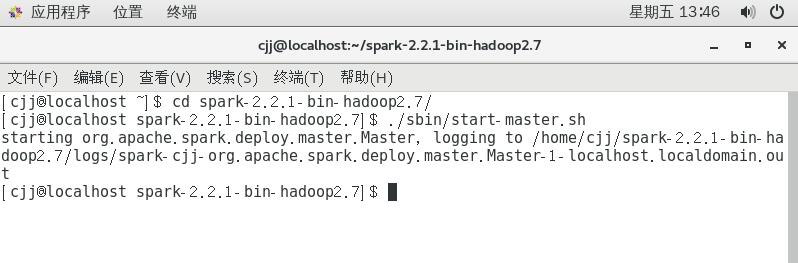
然后可以打开浏览器,进入localhost:8080,可以看到
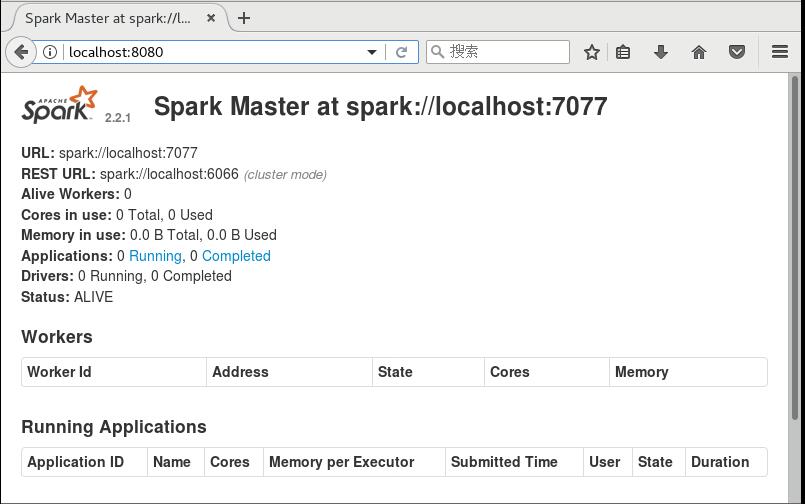
这里的URL spark://localhost:7077需要记下来下一步需要使用,下一步启动work,加上刚刚的URL,可以使用的命令是,
./bin/spark-class org.apache.spark.deploy.worker.Worker spark://localhost:7077
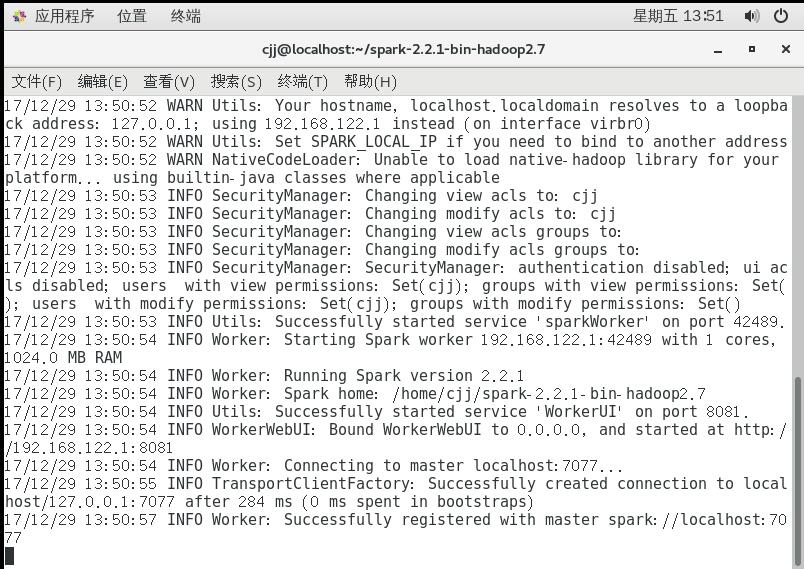
这时启动另一个窗口进行提交作业,同样需要先进入spark文件夹,然后运行命令
./bin/spark-submit --master spark://localhost:7077 --class first /home/cjj/testfile/first.jar
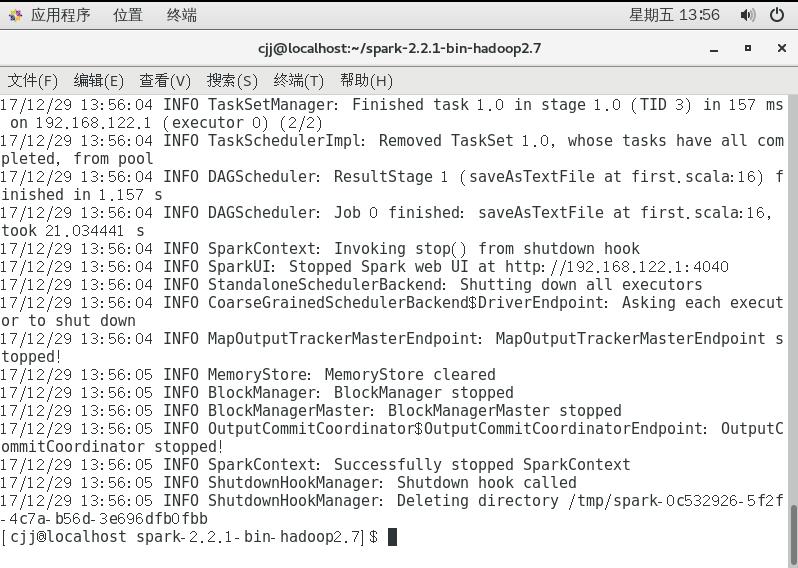
这样就算完成了,我们可以来看看结果,看结果之前需要先看一看helloSpark.txt的内容
结果保存在helloSparkRes中,下面是结果
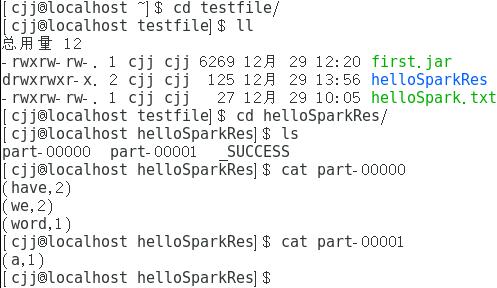
这里的结果告诉我们have和word的个数为2,word和a的个数为1。
使用IDEA打包scala程序并在spark中运行的更多相关文章
- docker 运行jenkins及vue项目与springboot项目(五.jenkins打包springboot服务且在docker中运行)
docker 运行jenkins及vue项目与springboot项目: 一.安装docker 二.docker运行jenkins为自动打包运行做准备 三.jenkins的使用及自动打包vue项目 四 ...
- intellij-idea打包Scala代码在spark中运行
.创建好Maven项目之后(记得添加Scala框架到该项目),修改pom.xml文件,添加如下内容: <properties> <spark.version></spar ...
- 使用IntelliJ IDEA编写Scala在Spark中运行
使用Scala写一个测试代码: object Test { def main(args: Array[String]): Unit = { println("hello world" ...
- 判断Java程序是否在jar中运行
URL url = TextRenderer.class.getResource(""); String protocol = url.getProtocol(); boolean ...
- 关于python程序在VS code中运行时提示文件无法找到的报错
经过测试,在设置文件夹目录时,可以找到当前目录下的htm文件,采用with open()语句可以正常执行程序,如下图. 而当未设置当前目录,直接用vscode执行该程序时,就会报错文件无法找到File ...
- C编译器MinGW安装、下载及在notepad++中运行C程序
一.C编译器MinGW的下载及安装步骤 打开MinGW官网:http://www.mingw.org/ 图一 图二 图三 图四 图五 图六 系统中配置环境变量: 图七 验证是否安装成功: CMD中运行 ...
- sbt打包Scala写的Spark程序,打包正常,提交运行时提示找不到对应的类
sbt打包Scala写的Spark程序,打包正常,提交运行时提示找不到对应的类 详述 使用sbt对写的Spark程序打包,过程中没有问题 spark-submit提交jar包运行提示找不到对应的类 解 ...
- 通过IDEA搭建scala开发环境开发spark应用程序
一.idea社区版安装scala插件 因为idea默认不支持scala开发环境,所以当需要使用idea搭建scala开发环境时,首先需要安装scala插件,具体安装办法如下. 1.打开idea,点击c ...
- IDEA搭建scala开发环境开发spark应用程序
通过IDEA搭建scala开发环境开发spark应用程序 一.idea社区版安装scala插件 因为idea默认不支持scala开发环境,所以当需要使用idea搭建scala开发环境时,首先需要安 ...
随机推荐
- JDK源码阅读(一):Object源码分析
最近经过某大佬的建议准备阅读一下JDK的源码来提升一下自己 所以开始写JDK源码分析的文章 阅读JDK版本为1.8 目录 Object结构图 构造器 equals 方法 getClass 方法 has ...
- lambda匿名函数和他的小伙伴(处理大量数据的时候用到)
lambda匿名函数 主要是为了解决一些简单的需求而设计的一句话函数 #计算n的n次方 def func(n): return n**n f = lambda n : n ** n 语法: 函数名 = ...
- [常用命令]Git命令
取得Git仓库 初始化一个版本仓库 git init Clone远程版本库 git clone https://github.com/yhj167/yhj167.github.io.git 添加远程版 ...
- 从零开始基于go-thrift创建一个RPC服务
Thrift 是一种被广泛使用的 rpc 框架,可以比较灵活的定义数据结构和函数输入输出参数,并且可以跨语言调用.为了保证服务接口的统一性和可维护性,我们需要在最开始就制定一系列规范并严格遵守,降低后 ...
- shiro自定义异常无法被捕获总是抛出AuthenticationException解决方案
这个问题我也是出的莫名其妙,刚开始好好的,然后配置多realm之后出的. 现在直入主题 在继承了 org.apache.shiro.authc.pam.ModularRealmAuthenticato ...
- kuangbin专题 专题一 简单搜索 Fire Game FZU - 2150
题目链接:https://vjudge.net/problem/FZU-2150 题意:’ . '代表火无法烧着的地方,‘ # ’表示草,火可以烧着.选择任意两个‘ # ’(可以两个都选同一个 ‘ # ...
- Java编程思想:I/O的典型使用方式
import java.io.*; public class Test { public static void main(String[] args) { // BufferedInputFile. ...
- Excel催化剂开源第50波-Excel与PowerBIDeskTop互通互联之第四篇
答应过的全盘分享,也必承诺到底,此篇PowerBI功能分享的最后一篇,讲述如何导出数据模型的元数据,笔者定义其为模型的数据字典. 此篇对应功能实现出自:第6波-导出PowerbiDesktop模型数据 ...
- C4.5和ID3的差别
C4.5和ID3的差别 决策树分为两大类:分类树和回归树,前者用于分类标签值,后者用于预测连续值,常用算法有ID3.C4.5.CART等. 信息熵 信息量: 信息熵: 信息增益 当计算出各个特征属 ...
- [小米OJ] 4. 最长连续数列
思路: 时间限制为O(n),即不能使用先排序后寻找的方法. 这里利用哈希表查询插入复杂度都为O(1)的特性来解,利用一个哈希表来保存每一个数字以及其所在数列的长度. 遍历每一个数字n:查询表中是否存在 ...