
大数据学习——mapreduce案例join算法
需求:
用mapreduce实现
select order.orderid,order.pdtid,pdts.pdt_name,oder.amount
from order
join pdts
on order.pdtid=pdts.pdtid
数据:
orders.txt
Order_0000001,pd001,222.8

Order_0000001,pd005,25.8

Order_0000002,pd005,325.8

Order_0000002,pd003,522.8

Order_0000002,pd004,122.4

Order_0000003,pd001,222.8

Order_0000003,pd001,322.8
pdts.txt
pd001,apple

pd002,banana

pd003,orange

pd004,xiaomi

pd005,meizu
pom.xml
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <groupId>com.cyf</groupId>

    <artifactId>MapReduceCases</artifactId>

    <packaging>jar</packaging>

    <version>1.0</version>

    <properties>

        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>

        <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>

    </properties>

    <dependencies>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-common</artifactId>

            <version>2.6.4</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-hdfs</artifactId>

            <version>2.6.4</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-client</artifactId>

            <version>2.6.4</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-mapreduce-client-core</artifactId>

            <version>2.6.4</version>

        </dependency>

        <dependency>

            <groupId>com.alibaba</groupId>

            <artifactId>fastjson</artifactId>

            <version>1.1.40</version>

        </dependency>

        <dependency>

            <groupId>mysql</groupId>

            <artifactId>mysql-connector-java</artifactId>

            <version>5.1.36</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <artifactId>maven-assembly-plugin</artifactId>

                <configuration>

                    <appendAssemblyId>false</appendAssemblyId>

                    <descriptorRefs>

                        <descriptorRef>jar-with-dependencies</descriptorRef>

                    </descriptorRefs>

                    <archive>

                        <manifest>

                            <mainClass>cn.itcast.mapreduce.CacheFile.MapJoinDistributedCacheFile</mainClass>

                        </manifest>

                    </archive>

                </configuration>

                <executions>

                    <execution>

                        <id>make-assembly</id>

                        <phase>package</phase>

                        <goals>

                            <goal>assembly</goal>

                        </goals>

                    </execution>

                </executions>

            </plugin>

        </plugins>

    </build>

</project>
package cn.itcast.mapreduce.CacheFile;

import java.io.BufferedReader;

import java.io.FileReader;

import java.io.IOException;

import java.net.URI;

import java.util.HashMap;

import org.apache.commons.lang.StringUtils;

import org.apache.commons.logging.Log;

import org.apache.commons.logging.LogFactory;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IOUtils;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class MapJoinDistributedCacheFile {

    private static final Log log = LogFactory.getLog(MapJoinDistributedCacheFile.class);

    public static class MapJoinDistributedCacheFileMapper extends Mapper<LongWritable, Text, Text, NullWritable> {

        FileReader in = null;

        BufferedReader reader = null;

        HashMap<String, String[]> b_tab = new HashMap<String, String[]>();

        @Override

        protected void setup(Context context) throws IOException, InterruptedException {

            // 此处加载的是产品表的数据

            in = new FileReader("pdts.txt");

            reader = new BufferedReader(in);

            String line = null;

            while (StringUtils.isNotBlank((line = reader.readLine()))) {

                String[] split = line.split(",");

                String[] products = {split[0], split[1]};

                b_tab.put(split[0], products);

            }

            IOUtils.closeStream(reader);

            IOUtils.closeStream(in);

        }

        @Override

        protected void map(LongWritable key, Text value, Context context)

                throws IOException, InterruptedException {

            String line = value.toString();

            String[] orderFields = line.split(",");

            String pdt_id = orderFields[1];

            String[] pdtFields = b_tab.get(pdt_id);

            String ll = orderFields[0] + "\t" + pdtFields[1] + "\t" + orderFields[1] + "\t" + orderFields[2];

            context.write(new Text(ll), NullWritable.get());

        }

    }

    public static void main(String[] args) throws Exception {

        Configuration conf = new Configuration();

        Job job = Job.getInstance(conf);

//        job.setJarByClass(MapJoinDistributedCacheFile.class);

        //告诉框架,我们的程序所在jar包的位置

        job.setJar("/root/MapJoinDistributedCacheFile.jar");

        job.setMapperClass(MapJoinDistributedCacheFileMapper.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(NullWritable.class);

        FileInputFormat.setInputPaths(job, new Path("/mapjoin/input"));

        FileOutputFormat.setOutputPath(job, new Path("/mapjoin/output"));

        job.setNumReduceTasks(0);

//        job.addCacheFile(new URI("file:/D:/pdts.txt"));

        job.addCacheFile(new URI("hdfs://mini1:9000/cachefile/pdts.txt"));

        job.waitForCompletion(true);

    }

}
创建文件夹上传数据
hadoop fs -mkdir -p /cachefile
hadoop fs -put pdts.txt /cachefile
hadoop fs -mkdir -p /mapjoin/input
hadoop fs -put orders.txt /mapjoin/input
打包并运行

运行
hadoop jar MapJoinDistributedCacheFile.jar cn.itcast.mapreduce.CacheFile.MapJoinDistributedCacheFile
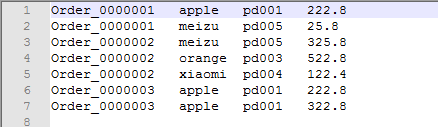
运行结果
大数据学习——mapreduce案例join算法的更多相关文章
- 大数据学习之BigData常用算法和数据结构
大数据学习之BigData常用算法和数据结构 1.Bloom Filter 由一个很长的二进制向量和一系列hash函数组成 优点:可以减少IO操作,省空间 缺点:不支持删除,有 ...
- 大数据学习——mapreduce运营商日志增强
需求 1.对原始json数据进行解析,变成普通文本数据 2.求出每个人评分最高的3部电影 3.求出被评分次数最多的3部电影 数据 https://pan.baidu.com/s/1gPsQXVYSQE ...
- 大数据学习——mapreduce学习topN问题
求每一个订单中成交金额最大的那一笔 top1 数据 Order_0000001,Pdt_01,222.8 Order_0000001,Pdt_05,25.8 Order_0000002,Pdt_05 ...
- 大数据学习——mapreduce共同好友
数据 commonfriends.txt A:B,C,D,F,E,O B:A,C,E,K C:F,A,D,I D:A,E,F,L E:B,C,D,M,L F:A,B,C,D,E,O,M G:A,C,D ...
- 大数据学习——mapreduce倒排索引
数据 a.txt hello jerry hello tom b.txt allen tom allen jerry allen hello c.txt hello jerry hello tom 1 ...
- 大数据学习——mapreduce汇总手机号上行流量下行流量总流量
时间戳 手机号 MAC地址 ip 域名 上行流量包个数 下行 上行流量 下行流量 http状态码 1363157995052 13826544101 5C-0E-8B-C7-F1-E0:CMCC 12 ...
- 大数据学习——mapreduce程序单词统计
项目结构 pom.xml文件 <?xml version="1.0" encoding="UTF-8"?> <project xmlns=&q ...
- 大数据学习——MapReduce学习——字符统计WordCount
操作背景 jdk的版本为1.8以上 ubuntu12 hadoop2.5伪分布 安装 Hadoop-Eclipse-Plugin 要在 Eclipse 上编译和运行 MapReduce 程序,需要安装 ...
- 【机器学习实战】第15章 大数据与MapReduce
第15章 大数据与MapReduce 大数据 概述 大数据: 收集到的数据已经远远超出了我们的处理能力. 大数据 场景 假如你为一家网络购物商店工作,很多用户访问该网站,其中有些人会购买商品,有些人则 ...
随机推荐
- Java 学习列表
这是从450家企业的招聘信息中统计而来,相对来说还是比较真实的,虽然有些公司的招聘要求万年不变,但还是可以大致反应企业的招聘要求的.
- PHP 讓 json_encode() 指定回傳格式
PHP 回傳 JSON 很方便, 只要將資料經過 json_encode() 就解決了. 不過因為 PHP 自動轉換型別, 造成很多資料都習慣存成字串, 希望在輸出 JSON 的時候, 數字部份可以輸 ...
- AJPFX的内存管理小结
管理范围:任何继承于 NSObject的对象原理:每一个对象都有引用计数器当使用alloc new 和 copy创建对象时引用计数器被设置为1给对象发送一条retain消息 ,引用计数器加1 ...
- Web前端开发的四个阶段(小白必看)
第一阶段:HTML的学习 超文本标记语言(HyperText Mark-up Language 简称HTML)是一个网页的骨架,无论是静态网页还是动态网页,最终返回到浏览器端的都是HTML代码,浏览器 ...
- Android 基础知识总结
搞了这么久安卓开发,对基础的知识点总会遗忘,所有有必要总结一下:
- FragmentTabHost实现标签卡效果
转载请注明原文链接:http://www.cnblogs.com/yanyojun/p/8099523.html 代码已上传到github:https://github.com/YanYoJun/Fr ...
- 8.3.3 快速系统调用 —— XP SP3上SystemCallStub的奇怪问题
依书上的例子,ReadFile()函数会调用ntdll!NtReadFile(),后者将服务号放到eax之中,然后调用SharedUserData!SystemCallStub(),由此函数执行sys ...
- SQLite – HAVING 子句
SQLite – HAVING子句 HAVING使您能够指定过滤条件哪一组结果出现在最终的结果. WHERE子句的地方条件选定的列, 在有HAVING 子句的地方 就有GROUP BY子句包含的条件组 ...
- PHP20 PHP面向对象辅助
学习要点 常用函数 命名空间 类的自动加载 常用函数 class_exists 作用:检查类是否已定义 语法格式: bool class_exists ( string $class_name [, ...
- OpenCV2:第五章 访问图像
一.行/列访问 1.单行/单列访问 Mat Mat::row(int i) const Mat Mat::col(int j) const 2.多行/多列访问 Range(start,end); Ra ...