
es7集群的搭建
es7集群的搭建
一、需求
最近在看es相关的知识,此处简单记录一下es集群的搭建步骤。因为本地机器有限,此处模拟一下在同一台机器上搭建三个节点的集群。
二、前置条件
1、es不能使用root用户启动,因此需要创建一个用户。
2、本地的多个es节点之间不能使用相同的data和log目录。
3、集群之间的脑裂问题,集群自己维护。
三、搭建步骤
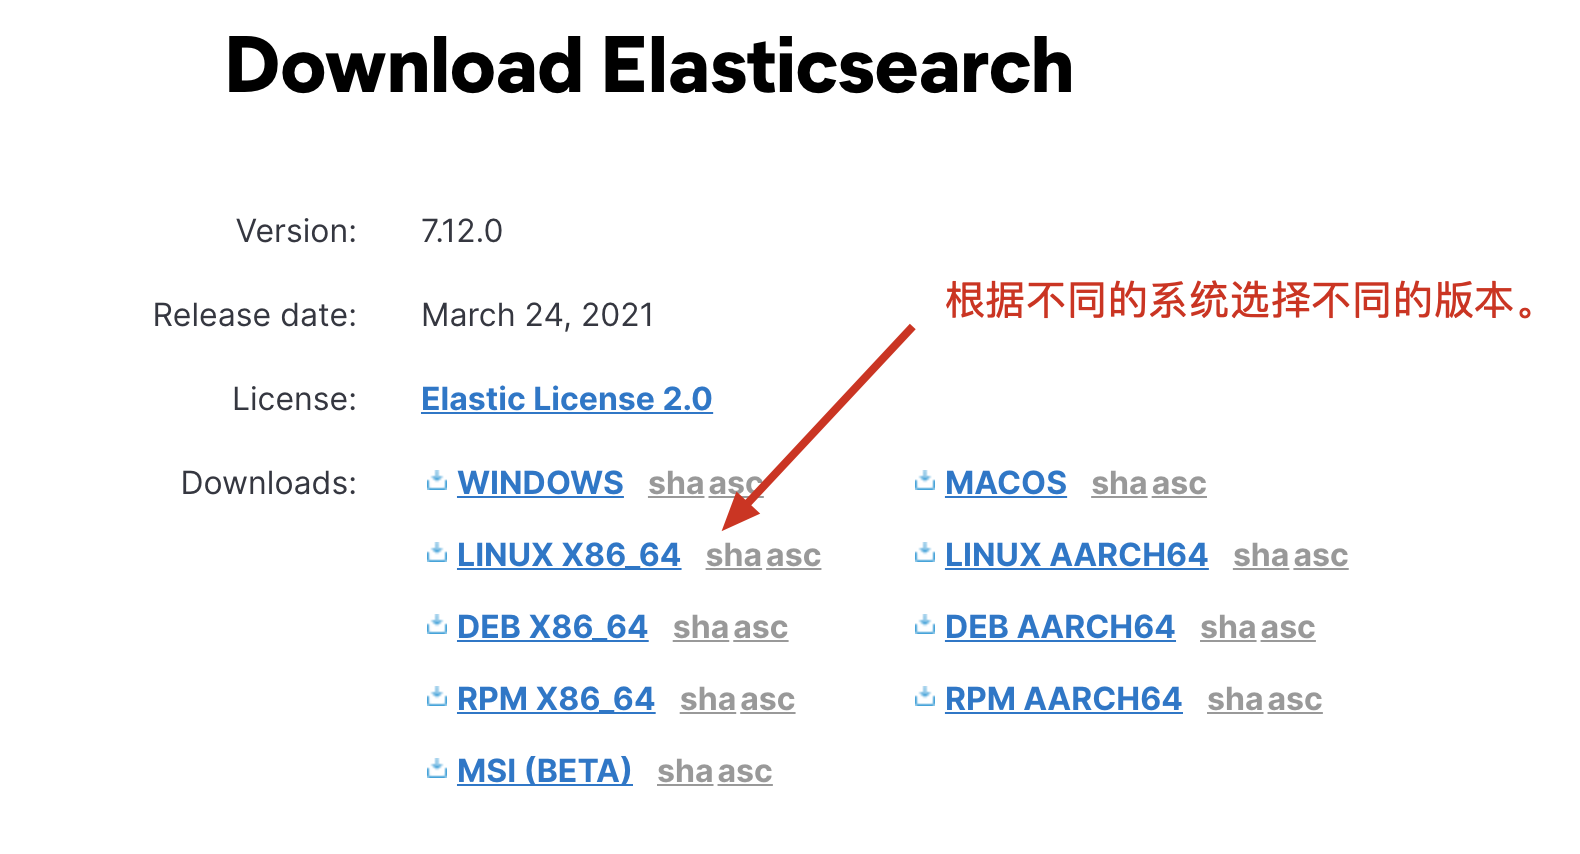
1、下载es
# 下载

wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-7.12.0-linux-x86_64.tar.gz

# 解压

tar -zxvf elasticsearch-7.12.0-linux-x86_64.tar.gz

# 重命名

mv elasticsearch-7.12.0 es01

# 复制2份

cp -r es01/ es02

cp -r es01/ es03
2、创建 es 用户并给es目录授权
# 创建es用户

useradd es

# 设置es用户的密码

passwd es

# 改变上一步下载的 es01、es02和es03目录的所有者为刚创建的es用户

chown -R es es01

chown -R es es02

chown -R es es03

# 创建数据目录和日志目录

mkdir data && mkdir log

cd data

mkdir es01

mkdir es02

mkdir es03

cd log

mkdir es01

mkdir es02

mkdir es03
️ 因为 es 用 root 用户启动会报错,所以此处需要新建一个用户,然后用新建的用户启动es。
3、修改es的配置文件
| 配置文件 | 属性 | 节点01 | 节点02 | 节点03 | 解释 |
|---|---|---|---|---|---|
| es0[1,2,3]/config/ elasticsearch.yml |
es01 | es02 | es03 | es01、es02、es03表示同一台机器上的3个目录 | |
cluster.name |
es-cluster | es-cluster | es-cluster | 集群的名称,组成集群的集群名称必须一致。 | |
node.name |
es01 | es01 | es01 | 节点名称,集群中的每个节点的名字必须要唯一。 | |
path.data |
/home/es/ es/data/es01 |
/home/es/ es/data/es02 |
/home/es/ es/data/es03 |
数据目录 | |
path.logs |
/home/es/ es/log/es01 |
/home/es/ es/log/es02 |
/home/es/ es/log/es03 |
日志目录 | |
network.host |
localhost | localhost | localhost | 监听地址,可以写本地ip,通过此地址可以访问到es | |
http.port |
9200 | 9201 | 9202 | 监听端口 | |
transport.port |
9205 | 9206 | 9207 | 集群之间通讯接口,比如集群选举 | |
discovery.seed_hosts: |
[“localhost:9095”, “localhost:9096”, “localhost:9097”] | [“localhost:9095”, “localhost:9096”, “localhost:9097”] | [“localhost:9095”, “localhost:9096”, “localhost:9097”] | 有资格成为主节点的地址列表 | |
cluster.initial_master_nodes |
[“es01”, “es02”, “es03”] | [“es01”, “es02”, “es03”] | [“es01”, “es02”, “es03”] | 初始的候选master节点列表。必须和node.name的值一致。 | |
node.master |
true | true | true | true:表示可以被选举成为master节点. | |
node.data |
true | true | true | true: 表示可以存储数据。 | |
http.cors.enabled |
true | true | true | true: 表示允许跨域。 | |
http.cors.allow-origin |
* | * | * | 表示支持所有域名 | |
| es0[1,2,3]/config/ jvm.options |
|||||
| -Xms512m | -Xms512m | -Xms512m | 根据自己的情况设置,不要超过本机物理内存的一半,最大不要超过30g | ||
| -Xmx512m | -Xmx512m | -Xmx512m | … |
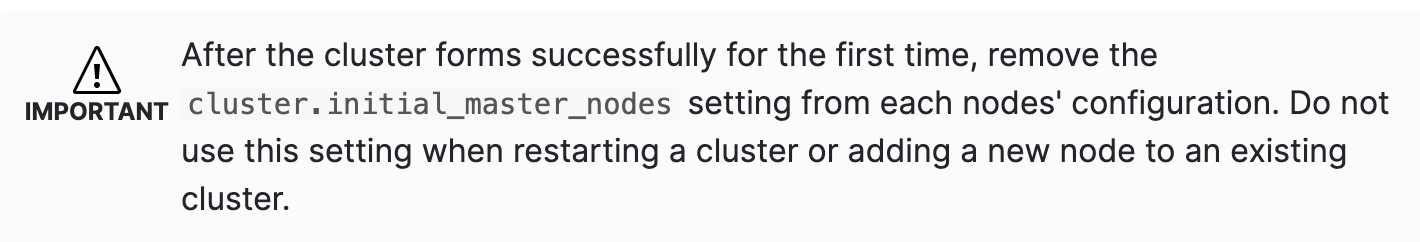
重要的属性:
cluster.initial_master_nodes
4、es01目录下 elasticsearch.yml 的一个完整的配置
cluster.name: es-cluster

node.name: es01

path.data: /home/es/es/data/es01

path.logs: /home/es/es/log/es01

network.host: localhost

http.port: 9200

transport.port: 9205

discovery.seed_hosts: ["localhost:9205", "localhost:9206", "localhost:9207"]

cluster.initial_master_nodes: ["es01", "es02", "es03"]

node.master: true

node.data: true

http.cors.enabled: true

http.cors.allow-origin: "*"
5、启动es集群
#!/bin/bash

# -d 后台启动 -p 指定pid保存在那个文件中 /home/es/es/es01/pid01

/home/es/es/es01/bin/elasticsearch -d -p pid01

/home/es/es/es02/bin/elasticsearch -d -p pid02

/home/es/es/es03/bin/elasticsearch -d -p pid03
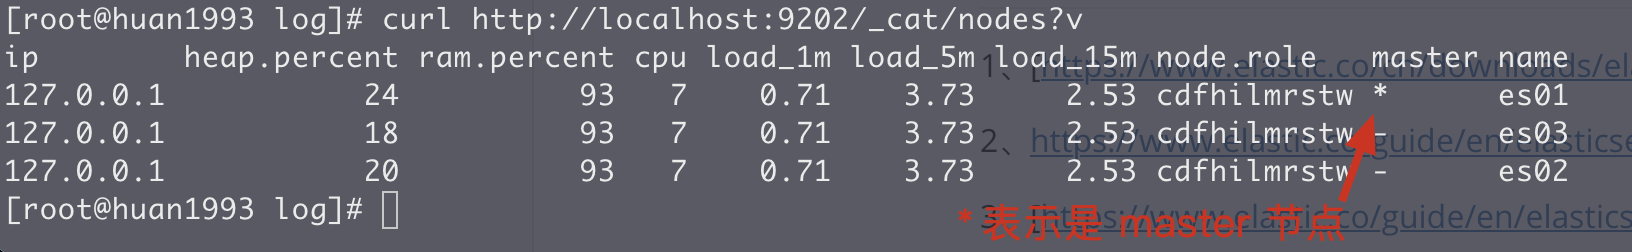
6、查看集群是否启动
curl http://localhost:9202/_cat/nodes?v
curl http://localhost:9202/_cat/health?v

四、参考链接
1、https://www.elastic.co/cn/downloads/elasticsearch.
5、https://www.elastic.co/guide/en/elasticsearch/reference/7.12/modules-discovery-settings.html
6、https://www.elastic.co/guide/en/elasticsearch/reference/7.12/jvm-options.html
es7集群的搭建的更多相关文章
- zookeeper集群的搭建以及hadoop ha的相关配置
1.环境 centos7 hadoop2.6.5 zookeeper3.4.9 jdk1.8 master作为active主机,data1作为standby备用机,三台机器均作为数据节点,yarn资源 ...
- 朝花夕拾之--大数据平台CDH集群离线搭建
body { border: 1px solid #ddd; outline: 1300px solid #fff; margin: 16px auto; } body .markdown-body ...
- Hadoop+Spark:集群环境搭建
环境准备: 在虚拟机下,大家三台Linux ubuntu 14.04 server x64 系统(下载地址:http://releases.ubuntu.com/14.04.2/ubuntu-14.0 ...
- linux环境(CentOS-6.7)下redis集群的搭建全过程
linux环境下redis集群的搭建全过程: 使用mount命令将光盘挂载到/mnt/cdrom目录下: [root@hadoop03 ~]# mount -t iso9660 -o ro /dev/ ...
- 【redis】 linux 下redis 集群环境搭建
Redis集群 (要让集群正常工作至少需要3个主节点,在这里我们要创建6个redis节点,其中三个为主节点,三个为从节点,对应的redis节点的ip和端口对应关系如下) 127.0.0.1:63791 ...
- 项目进阶 之 集群环境搭建(三)多管理节点MySQL集群
上次的博文项目进阶 之 集群环境搭建(二)MySQL集群中,我们搭建了一个基础的MySQL集群,这篇博客咱们继续讲解MySQL集群的相关内容,同时针对上一篇遗留的问题提出一个解决方案. 1.单管理节点 ...
- [原]项目进阶 之 集群环境搭建(二)MySQL集群
上次的博文中我们介绍了一下集群的相关概念,今天的博文我们介绍一下MySQL集群的相关内容. 1.MySQL集群简介 MySQL群集技术在分布式系统中为MySQL数据提供了冗余特性,增强了安全性,使得单 ...
- Spark 1.6.1分布式集群环境搭建
一.软件准备 scala-2.11.8.tgz spark-1.6.1-bin-hadoop2.6.tgz 二.Scala 安装 1.master 机器 (1)下载 scala-2.11.8.tgz, ...
- Solr集群的搭建以及使用(内涵zookeeper集群的搭建指南)
1 什么是SolrCloud SolrCloud(solr 云)是Solr提供的分布式搜索方案,当你需要大规模,容错,分布式索引和检索能力时使用 SolrCloud.当一个系统的索引数据量少的时候 ...
随机推荐
- 在C#中将图像转换为BASE64
本教程说明如何在C#.NET Windows Forms Application中将图像转换为base64字符串,以及将base64字符串转换为图像.您可以创建一个新的Windows窗体应用程序项目来 ...
- ASP.NET Core Web API 教程 - Project Configuration
ASP.NET Core Web API 教程 本系列文章主要参考了<Ultimate ASP.NET Core 3 Web API>一书,我对原文进行了翻译,同时适当删减.修改了一部分内 ...
- rune和byte在处理字符/字符串中的应用.
rune和byte在处理字符/字符串中的应用. 定义: rune是int32的别名,-2147483648->2147483647,常用来表示UNICODE字符集,可以用来处理包含中文/非中文的 ...
- HDFS基本命令
1.创建目录 hadoop dfs -mkdir /data hadoop dfs -mkdir -p /data/data1 创建多级目录 2.查看文件 hadoop dfs -ls / 3.上 ...
- 洛谷P1583——魔法照片(结构体排序)
https://www.luogu.org/problem/show?pid=1583#sub 题目描述 一共有n(n≤20000)个人(以1--n编号)向佳佳要照片,而佳佳只能把照片给其中的k个人. ...
- Android学习记录(一)——安装Android Studio
"工欲善其事必先利其器"学习安卓开发的第一步,安装Android Studio. 一.什么是Android Studio? Android Studio 是谷歌推出的一个Andro ...
- 一、java基础补充
1.java执行流程 源文件由编译器编译成字节码(ByteCode),也就是.class文件 字节码由java虚拟机解释运行 通过命令行操作java程序: javac test.java java t ...
- sonar-scanner的使用
在服务器搭建sonarqube后,本地的windows个人电脑如何使用sonar-scanner? 在服务器搭建sonarqube后,每个人都可以在本地使用sonar-scanner扫描代码. son ...
- css定位:p:nth-child(n)
p:nth-child(n) 定位p标签下的第一个元素,下标从1开始. 首先是一个标签下有多个相同的元素. 如index_service_cnt js_service_list下有多个class=&q ...
- Python简单算法的实现
#coding=utf-8 #!/usr/bin/python def GCD(a,b): """ :求两个数的最大公约数 :param a: :param b: :re ...