
爬取豆瓣Top250图书数据
爬取豆瓣Top250图书数据
项目的实现步骤
1.项目结构
2.获取网页数据
3.提取网页中的关键信息
4.保存数据
1.项目结构
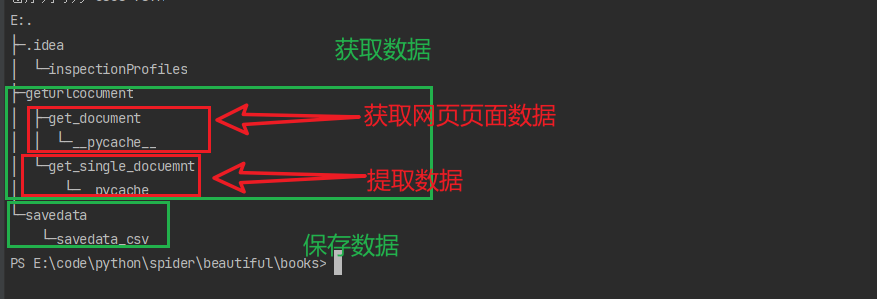
2.获取网页数据
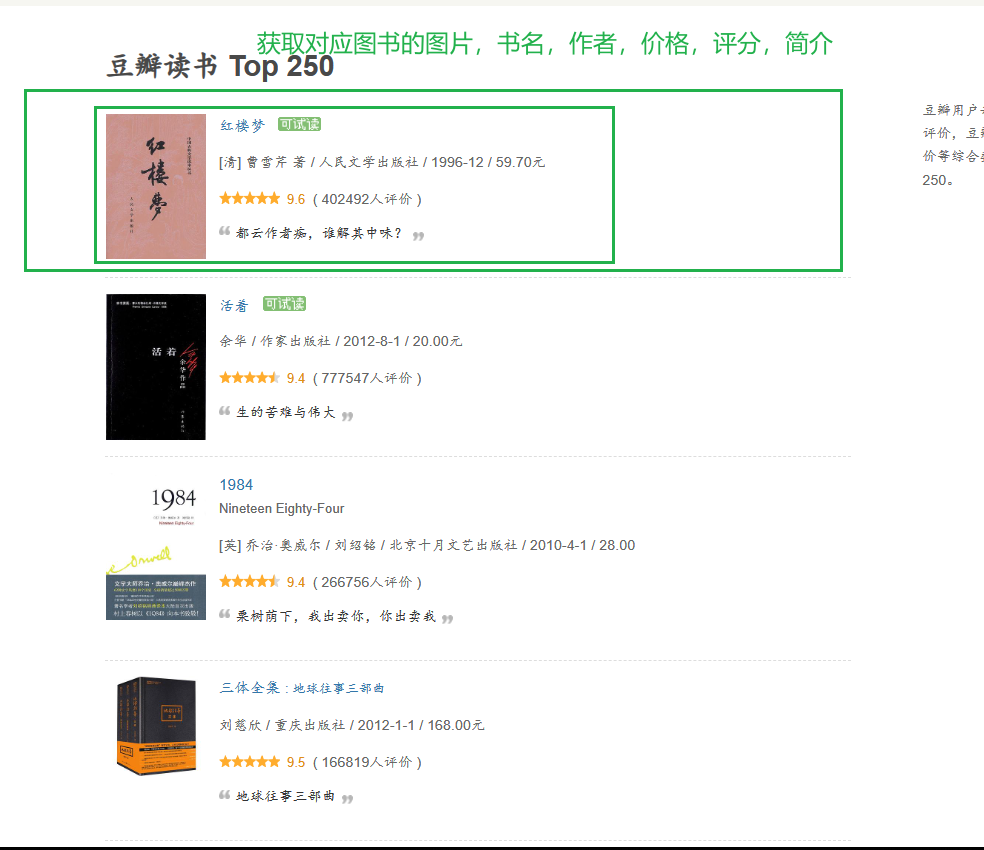
对应的网址为https://book.douban.com/top250
import requests

from bs4 import BeautifulSoup

"""

获取网页数据,解析数据,将相应的数据传出

"""

def get_page(url):

    headers = {

        'User-Agent':'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) '

                     'AppleWebKit/537.36 (KHTML, like Gecko) Chrome/114.0.0.0 '

                     'Mobile Safari/537.36 Edg/114.0.1823.43'

    }

    resp=requests.get(url,headers=headers)

    soup=BeautifulSoup(resp.text,'html.parser')

    return soup
3.提取网页中的关键信息
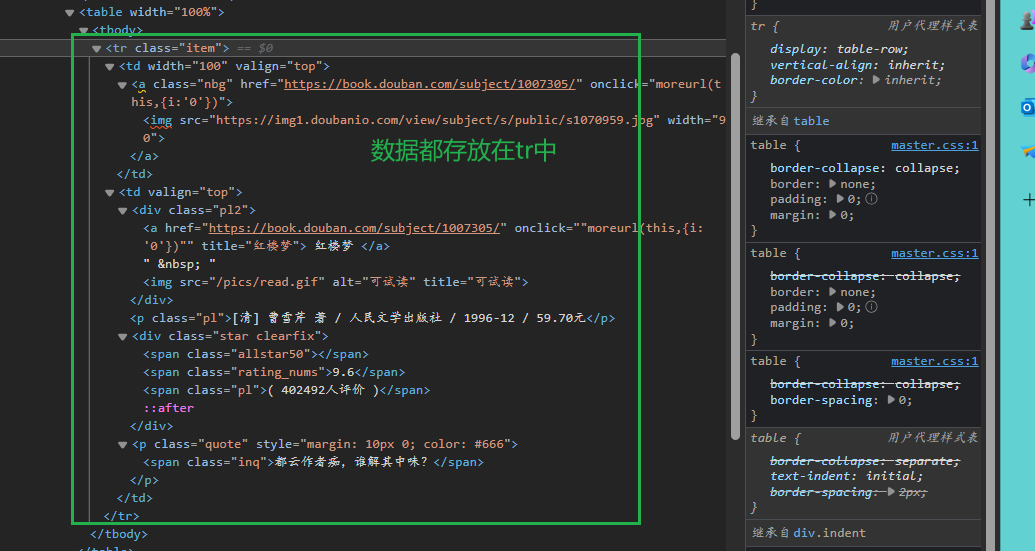
获取传出的解析后的数据,获取对应的图片,书名,作者,价格,评价,简介
from geturlcocument.get_document import get_page

import re

# 初始数据

pictures=[]

names=[]

authors=[]

prices=[]

scores=[]

sums=[]

def get_single():

    # 网址地址

    urls = [f"https://book.douban.com/top250?start={num}" for num in range(0,250,25)]

    for url in urls:

        # 获取对应的网页文本

        text = get_page.get_page(url)

        # 所有数据的集合

        all_tr = text.find_all(name="tr", attrs={"class": "item"})

        # 查找每个单项

        for tr in all_tr:

            # 数据类型:图片,书名,作者,价格,评分,简介

            # 图片

            picture = tr.find(name="img")

            picture = picture.get('src')

            # print(picture)

            # 书名

            div = tr.find(name='div', attrs={'class': 'pl2'})

            name = div.find('a').text

            name = re.sub(r'\s+', '', name)

            # 作者

            author = tr.find(name='p', attrs={'class': 'pl'}).text

            author = author.split('/')[0]

            # 价格

            price = author.split('/')[-1]

            price = re.sub(r'元', '', price)

            # 评分

            score = tr.find(name='span', attrs={'class': 'rating_nums'}).text

            try:

                sum = tr.find(name='span', attrs={'class': 'inq'}).text

            except AttributeError:

                sum = ''

            pictures.append(picture)

            names.append(name)

            authors.append(author)

            prices.append(price)

            scores.append(score)

            sums.append(sum)

    data = {

        "picture": pictures,

        "name": names,

        "author": authors,

        "price": prices,

        "score": scores,

        "sum": sums

    }

    return data
将获取的数据存入到字典中,将数据传出,使用re库对相应的数据进行处理,运用异常检错
4.保存数据
获取传出的字典类型的数据,将数据存入到pandas的DataFrame类型中
from geturlcocument.get_single_docuemnt import get_single

import pandas as pd

# 获取字典类型的数据

data=get_single.get_single()

# 用pandas的DataFrame类型存储数据

df=pd.DataFrame(data)

df.to_csv('./books.csv',encoding='utf-8')

print('ending of data')
该项目完成!!!
爬取豆瓣Top250图书数据的更多相关文章
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
- 爬取豆瓣网图书TOP250的信息
爬取豆瓣网图书TOP250的信息,需要爬取的信息包括:书名.书本的链接.作者.出版社和出版时间.书本的价格.评分和评价,并把爬取到的数据存储到本地文件中. 参考网址:https://book.doub ...
- 正则爬取豆瓣Top250数据存储到CSV文件(6行代码)
利用正则爬取豆瓣TOP250电影信息 电影名字 电影年份 电影评分 评论人数 import requests import csv import re # 不算导包的话正式代码6行 存储到csv文件 ...
- requests爬取豆瓣top250电影信息
''' 1.爬取豆瓣top250电影信息 - 第一页: https://movie.douban.com/top250?start=0&filter= - 第二页: https://movie ...
- python爬取豆瓣电影信息数据
题外话+ 大家好啊,最近自己在做一个属于自己的博客网站(准备辞职回家养老了,明年再战)在家里 琐事也很多, 加上自己 一回到家就懒了(主要是家里冷啊! 广东十几度,老家几度,躲在被窝瑟瑟发抖,) 由于 ...
- Python 爬取豆瓣TOP250实战
学习爬虫之路,必经的一个小项目就是爬取豆瓣的TOP250了,首先我们进入TOP250的界面看看. 可以看到每部电影都有比较全面的简介.其中包括电影名.导演.评分等. 接下来,我们就爬取这些数据,并将这 ...
- Python-爬虫实战 简单爬取豆瓣top250电影保存到本地
爬虫原理 发送数据 获取数据 解析数据 保存数据 requests请求库 res = requests.get(url="目标网站地址") 获取二进制流方法:res.content ...
- re、base64的结合使用爬取豆瓣top250
一.缘由 对于豆瓣的这个网站,记得使用了不少于三种的爬取和解析方式来进行的.今天的这种解析方式是我使用起来较为顺手,后来就更喜欢使用xpath解析,但是这两种也需要掌握. 二.代码展示 '''爬取豆瓣 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python爬虫爬取豆瓣电影之数据提取值xpath和lxml模块
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统.谷歌浏览器 目的:爬取豆瓣电影排行榜中电影的title.链接地址.图片.评价人数.评分等 网址:https:// ...
随机推荐
- C++/Qt网络通讯模块设计与实现(五)
在C++/Qt网络通讯模块设计与实现(四)中具体分析了Qt的信号槽.线程相关的知识,即从 Qt::ConnectionType,示例源码,结果论证,归纳总结等四个方面进行了全方面讲解,深刻阐述了代码设 ...
- Chronicle Pro - 一款简单 Mac 理财规划师,管理你的的个人预算
使用Chronicle追踪和支付账单,管理你的个人预算,这是一款简单的Mac理财规划师.获得通知,这样你就不会错过下一个付款截止日期;你再也不用付滞纳金了.把你所有的账单放在一起,计划.检查和分析它们 ...
- ACM-刷题记录-14届NEFU校赛
P2031凯撒密码 #include<bits/stdc++.h> using namespace std; int main(){ string s; int d; while(cin& ...
- .net6的IIS发布部署
1.打开控制面板,打开程序 2.点击启动或关闭windows功能 3.在其中选择要设置的IIS功能 4.重启IIS服务 5.发布项目 6.在开始菜单搜索IIS,点击IIS管理器 7.右击网站,点击添加 ...
- C++中va_list, va_start, va_arg, va_end的基本用法
关于va_list, va_start, va_arg, va_end 由于在C语言中没有函数重载,解决不定数目函数参数问题变得比较麻烦,即使采用C++,如果参数个数不能确定,也很难采用函数重载.对这 ...
- StampedLock:JDK1.8中新增,比ReadWriteLock还快的锁
摘要:StampedLock是一种在读取共享变量的过程中,允许后面的一个线程获取写锁对共享变量进行写操作,使用乐观读避免数据不一致的问题,并且在读多写少的高并发环境下,比ReadWriteLock更快 ...
- 自用纯C语言实现任务调度(可用于STM32、C51等单片机)
前言 这个任务调度模块的实现是形成于毕设项目中的,用在STM32中,断断续续跨度2个月实现了一些基本功能,可能后面再做其他项目时会一点点完善起来,也会多学习相关知识来强化模块的实用性和高效性,毕竟 ...
- kali装机 安装输入法 修改国内源
1-先配置国内源官方kali源 vim /etc/apt/sources.list 插入如下源 deb http://mirrors.aliyun.com/kali sana main non-fre ...
- Hydra详细使用
1. 简介 Hydra是什么 Hydra是什么: Hydra是一款网络登录破解工具,可以通过暴力破解方式来猜解用户名和密码,从而获取系统的访问权限.它可以支持多种协议,如FTP.SSH.Telnet. ...
- ORA-12154: TNS:could not resolve the connect identifier specified--sys密码包含@符号
问题描述:在操作系统登录数据库时,由于忘记了sys密码,重新修改的sys密码包含@符号,登录时报错, ORA-12154: TNS:could not resolve the connect iden ...