
python爬虫-淘宝商品密码(图文教程附源码)
今天闲着没事,不想像书上介绍的那样,我相信所有的数据都是有规律可以寻找的,然后去分析了一下淘宝的商品数据的规律和加密方式,用了最简单的知识去解析了需要的数据。
这个也让我学到了,解决问题的方法不止一个,我们要常常学会去思考,学会去学习,相信我们爬虫还是可以拿到我们想要的一切需要的数据。
我也对数据感兴趣,就是感觉,世间万物都是有规律可寻的,就看我们能不能去发现其中的秘密。
当我们去解决一个问题的时候,那一种成就感是别人难以体会的。只有我们去亲身体验才会感到真正的幸福。
所用模块:
re+requests+json
所用环境:
windows10 + pycharm
实战分析:
第一步:根据url来在google chrome中分析数据


分析的结果是:数据就是通过json来存储的
第二步:
得到网页的源码
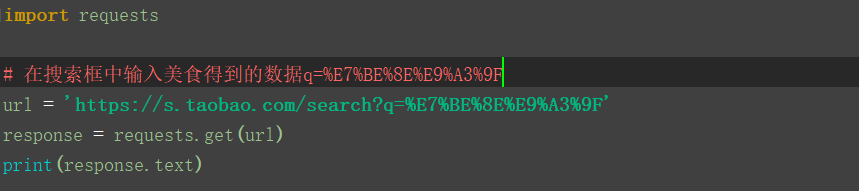
第三步把得到的数据进行解析

第四步:对数据进行解密
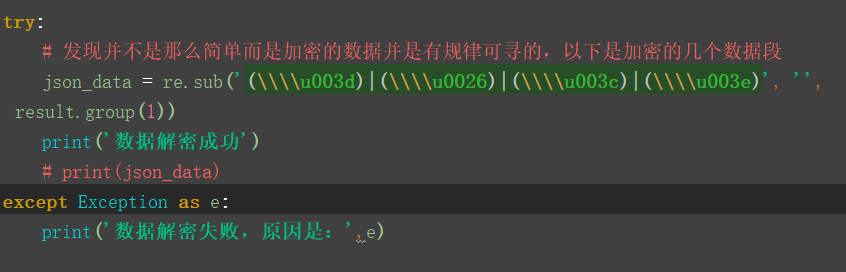
第五步:就可以把json的数据拿到并分析得到相应的数据
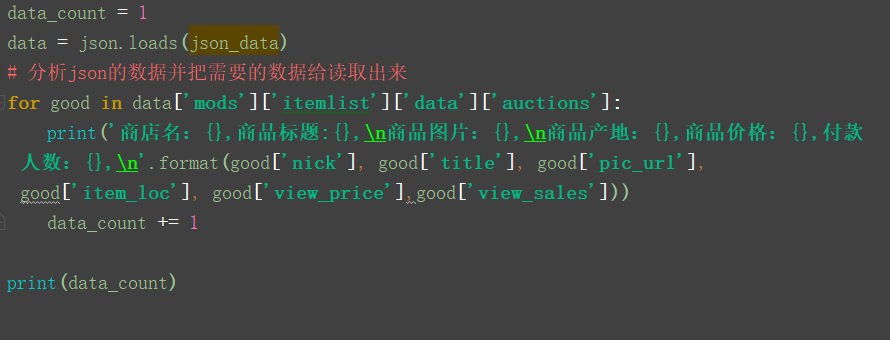
以下是源码:
 import json

 import re

 import requests

 # 在搜索框中输入美食得到的数据q=%E7%BE%8E%E9%A3%9F

 url = 'https://s.taobao.com/search?q=%E7%BE%8E%E9%A3%9F'

 response = requests.get(url)

 # print(response.text)

 # 用正则对html源码进行解析到一个json数据

 pattern = re.compile('g_page_config =(.*?});', re.S)

 result = re.search(pattern, response.text)

 # print(result.group(1))

 try:

     # 发现并不是那么简单而是加密的数据并是有规律可寻的,以下是加密的几个数据段

     json_data = re.sub('(\\\\u003d)|(\\\\u0026)|(\\\\u003c)|(\\\\u003e)', '', result.group(1))

     print('数据解密成功')

     # print(json_data)

 except Exception as e:

     print('数据解密失败,原因是:',e)

 # json_dumps = json.dumps(json_data)

 # print(json_dumps)

 data_count = 1

 data = json.loads(json_data)

 # 分析json的数据并把需要的数据给读取出来

 for good in data['mods']['itemlist']['data']['auctions']:

     print('商店名:{},商品标题:{},\n商品图片:{},\n商品产地:{},商品价格:{},付款人数:{},\n'.format(good['nick'], good['title'], good['pic_url'], good['item_loc'], good['view_price'],good['view_sales']))

     data_count += 1

 print(data_count)
python爬虫-淘宝商品密码(图文教程附源码)的更多相关文章
- 淘宝数据库OceanBase SQL编译器部分 源码阅读--生成物理查询计划
淘宝数据库OceanBase SQL编译器部分 源码阅读--生成物理查询计划 SQL编译解析三部曲分为:构建语法树,制定逻辑计划,生成物理执行计划.前两个步骤请参见我的博客<<淘宝数据库O ...
- 淘宝数据库OceanBase SQL编译器部分 源码阅读--生成逻辑计划
body, td { font-family: tahoma; font-size: 10pt; } 淘宝数据库OceanBase SQL编译器部分 源码阅读--生成逻辑计划 SQL编译解析三部曲分为 ...
- 《淘宝数据库OceanBase SQL编译器部分 源码阅读--解析SQL语法树》
淘宝数据库OceanBase SQL编译器部分 源码阅读--解析SQL语法树 曾经的学渣 2014-06-05 18:38:00 浏览1455 云数据库Oceanbase OceanBase是 ...
- PHP简单的长文章分页教程 附源码
PHP简单的长文章分页教程 附源码.本文将content.txt里的内容分割成3页,这样浏览起来用户体验很好. 根据分页参数ipage,获取对应文章内容 include('page.class.php ...
- python 获取淘宝商品信息
python cookie 获取淘宝商品信息 # //get_goods_from_taobao import requests import re import xlsxwriter cok='' ...
- Python爬虫--淘宝“泸州老窖”
爬虫淘宝--"泸州老窖" 爬去淘宝"泸州老窖" 相关信息: import requests import re import json import panda ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- 安卓sdk webview获取淘宝个人信息100项,源码。
1.贴出主要代码.这个不是python,python只涉及了服务端对信息提取结果的接受.主体是java + android + js.由于淘宝各模块都是二级子域名,不能只在一个页面完成所有请求,aj ...
- Python爬虫一爬取B站小视频源码
如果要爬取多页的话 在最下方循环中 填写好循环的次数就可以了 项目源码 from fake_useragent import UserAgent import requests import time ...
随机推荐
- Linux7系列阅读
1.[Centos7]hostnamectl 设置主机名 https://blog.csdn.net/dream361/article/details/56833248 2.ip addr https ...
- android studio设置窗口颜色和字体
1.设置左边窗口颜色和字体: 设置中间代码编辑窗口:
- pytroch 0.3 到 0.4版本迁移资料mark
搜了一堆,还是官方资料给力,一份中文,一份英文,maek一下 https://www.pytorchtutorial.com/pytorch-0-4-0-migration-guide/ https: ...
- python3+selenium入门01-环境搭建
作为一个测试,在最近两年应该有明显的感觉.那就是工作变的难找,要求变的高了,自动化测试,性能测试等.没有自动化测试能力,只会点点点工作难找不说,工资也不高.所以还是要学习一些技术.首先要学习一门编程语 ...
- 题解-hzy loves segment tree I
Problem 题目概要:给定一棵 \(n\) 个节点的树,点有点权,进行 \(m\) 次路径取\(\max\)的操作,最后统一输出点权 \(n\leq 10^5,m\leq 5\times 10^6 ...
- selenium——表单嵌套
<html> <iframe id="id-iframe" name="iframee1"> --切换表单 <html> & ...
- ansible笔记(6):常用模块之命令类模块
ansible笔记():常用模块之命令类模块 command模块 command模块可以帮助我们在远程主机上执行命令 注意:使用command模块在远程主机中执行命令时,不会经过远程主机的shell处 ...
- JQery插件clipboard.js ----将文本复制到剪贴板的现代化方法
### 之前用了js自带的剪贴板对象clipboardData 对象以为就可以实现粘贴复制,但是种只支持IE的. 就找了jq的一个插件Zclip,但是网上的说法是利用了flesh来实现的,我用了之后可 ...
- Ex 2_16 给定一个无穷数组..._第二次作业
先比较数组的A[0]元素,若不相等接下来比较A[1],A[2],A[4],A[8]…,若找到一个区间A[2n-1]<x<A[2n],再对这个区间进行折半查找操作.总的时间为O(logn). ...
- CSS 重置默认样式
1. 概述 1.1 说明 css重置样式主要是为了让各个浏览器的CSS样式有一个统一的基准,使HTML元素样式在跨浏览器时有一致性的效果. 备注:浏览器的兼容问题,不同浏览器对有些标签的默认值是不同的 ...