
爬虫_腾讯招聘(xpath)
和昨天一样的工作量,时间只用了一半,但还是效率有点低了,因为要把两个网页结合起来,所以在列表操作上用了好多时间
 import requests

 from lxml import etree

 headers = {'User-Agent': 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.75 Safari/537.36'}

 def get_html(url):

     response = requests.get(url, headers=headers)

     response.encoding = response.apparent_encoding

     html = response.text

     return html

 def parse_html(html):

     informations = []

     urls = []

     html_element = etree.HTML(html)

     kinds = html_element.xpath('(//tr[@class="even"]|//tr[@class="odd"])/td[2]/text()')

     '''

     kinds:

     ['技术类', '设计类', '技术类', '技术类', '技术类', '技术类', '技术类', '技术类', '技术类', '产品/项目类']

     '''

     nums = html_element.xpath('(//tr[@class="even"]|//tr[@class="odd"])//td[3]/text()')

     '''

     nums:

     ['2', '1', '2', '1', '2', '2', '1', '2', '1', '1']

     '''

     addresses = html_element.xpath('(//tr[@class="even"]|//tr[@class="odd"])//td[4]/text()')

     '''

     addresses:

     ['深圳', '深圳', '深圳', '深圳', '深圳', '深圳', '深圳', '深圳', '深圳', '深圳']

     '''

     times = html_element.xpath('(//tr[@class="even"]|//tr[@class="odd"])//td[5]/text()')

     '''

     times:

     ['2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04', '2018-08-04']

     '''

     names = html_element.xpath('(//tr[@class="even"]|//tr[@class="odd"])//a/text()')

     detail_url = html_element.xpath('(//tr[@class="even"]|//tr[@class="odd"])//a/@href')

     for str_url in detail_url:

         url = 'https://hr.tencent.com/' + str(str_url)

         urls.append(url)

     '''

     urls :

     ['https://hr.tencent.com/position_detail.php?id=42917&keywords=python&tid=0&lid=0',

      'https://hr.tencent.com/position_detail.php?id=42908&keywords=python&tid=0&lid=0',

                                  ......

      'https://hr.tencent.com/position_detail.php?id=42832&keywords=python&tid=0&lid=0',

      'https://hr.tencent.com/position_detail.php?id=42628&keywords=python&tid=0&lid=0']

     '''

     for index, name in enumerate(names):

         information = {}

         information['name'] = name

         information['url'] = urls[index]

         information['kind'] = kinds[index]

         information['nums_of_need'] = nums[index]

         information['address'] = addresses[index]

         informations.append(information)

     # print(informations)

     # print(urls)

     return urls, informations

 def parse_detail_page(url):

         #one detail page

     html = get_html(url)

     return html

 def get_all_page(page_nums):

     for i in range(0, page_nums):

         url = 'https://hr.tencent.com/position.php?lid=&tid=&keywords=python&start={0}#a'.format(i*10)

         html = get_html(url)

         urls, informations = parse_html(html)

         # print(informations)

         works = []

         for i, url in enumerate(urls):

             html_detail = parse_detail_page(url)

             html_element = etree.HTML(html_detail)

             work_intro = html_element.xpath('//td[@class="l2"]//text()')

             for index, text in enumerate(work_intro):

                 if text.startswith('工作职责:'):

                     text = text.replace('工作职责:', '')

                     works_detail = {}

                     intros = []

                     for x in range(index+1, len(work_intro)):

                         intro = work_intro[x].strip()

                         if work_intro[x].startswith('工作要求:'):

                             break

                         intros.append(intro)

                     while '' in intros:

                         intros.remove('')

                     works_detail['1_____工作职责:'] = intros

                     works.append(works_detail)

                     # print(intros)

                     '''

                     ['负责NLP与深度学习相关技术的研究与实现;',

                      '负责建设基础的语义分析工具和平台;',

                      '负责搜索系统、知识图谱系统、问答与对话系统的设计与搭建;',

                      '结合实际业务需求与数据,研发高效、稳健、完备的NLP解决方案。']

                     '''

                 if text.startswith('工作要求:'):

                     text = text.replace('工作要求:', '')

                     works_detail = {}

                     requests = []

                     for x in range(index+1, len(work_intro)):

                         intro = work_intro[x].strip()

                         if work_intro[x].startswith('申请岗位'):

                             break

                         requests.append(intro)

                     while '' in requests:

                         requests.remove('')

                     works_detail['2_____工作要求:'] = requests

                     works.append(works_detail)

                     # print(requests)

                     '''

                     ['三年以上自然语言处理经验包括语义表示、搜索、知识图谱、对话系统等;',

                      '扎实的编程基础,至少精通一种编程语言,如C++,Java,python等;',

                      '熟悉深度学习以及常见机器学习算法的原理与算法,能熟练运用聚类、分类、回归、排序等模型解决有挑战性的问题;',

                      '对自然语言处理相关的分词、词性标注、实体识别、句法分析、语义分析等有深入的实践经验;',

                      '有强烈求知欲,对人工智能领域相关技术有热情;', '具有良好的数学基础,良好的英语阅读能力;',

                      '有项目管理经验,与他人合作良好,能够独立有效推动复杂项目。']

                     '''

         return works, informations

 def main():

     works, informations = get_all_page(1)

     for index, information in enumerate(informations):

         list = []

         list.append(works[index*2])

         list.append(works[index*2+1])

         information['duty'] = list

         print(information)

 if __name__ == '__main__':

     main()
目前sublime还输入不了中文,所以把输出注释上,方便看清格式
运行结果:
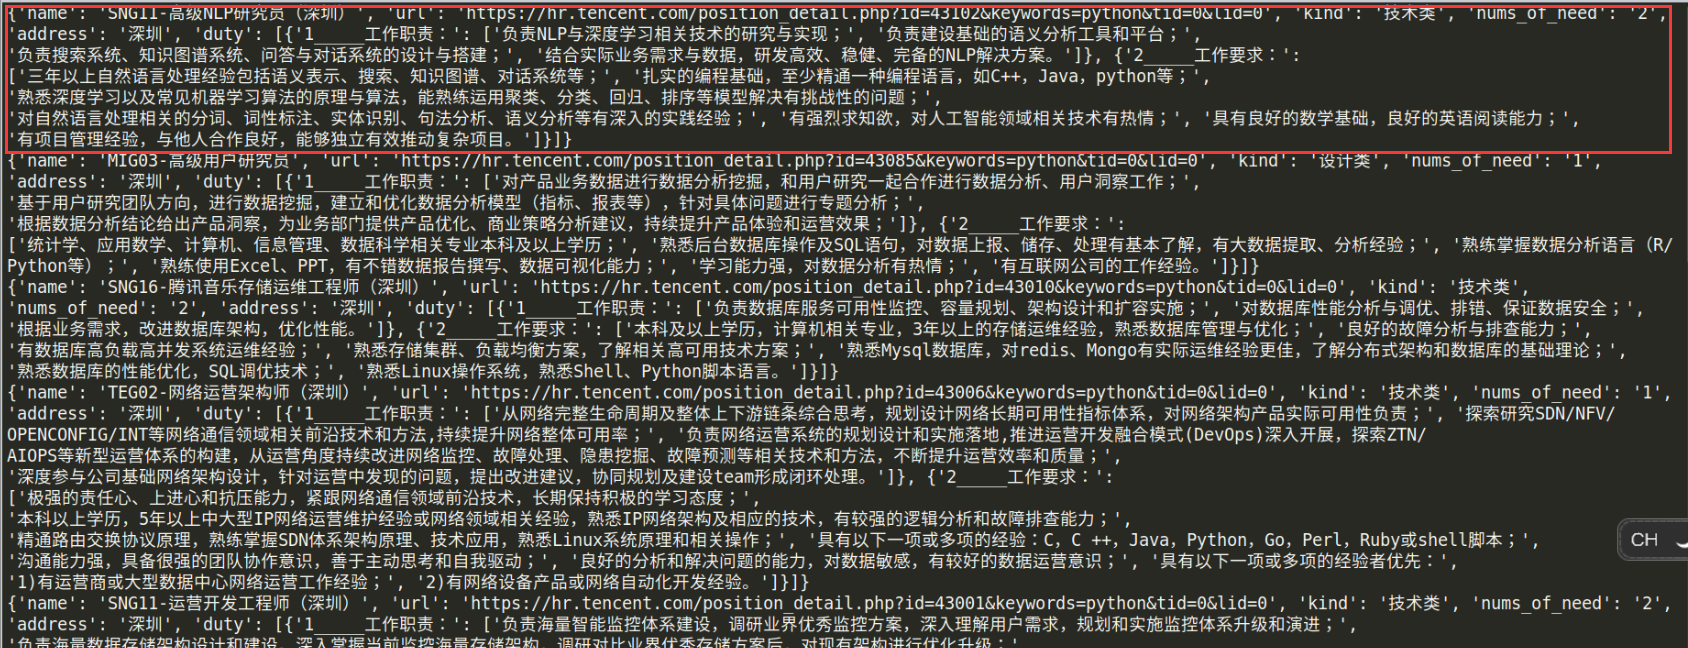
红色圈出来的是一个字典,包含第一个网页的信息(职位名称,url,位置)和详情页面的职责(工作职责,工作要求),嵌套的可能有点复杂,但目前还没有想到更简明的方法
爬虫_腾讯招聘(xpath)的更多相关文章
- python爬虫入门(三)XPATH和BeautifulSoup4
XML和XPATH 用正则处理HTML文档很麻烦,我们可以先将 HTML文件 转换成 XML文档,然后用 XPath 查找 HTML 节点或元素. XML 指可扩展标记语言(EXtensible Ma ...
- Scrapy实现腾讯招聘网信息爬取【Python】
一.腾讯招聘网 二.代码实现 1.spider爬虫 # -*- coding: utf-8 -*- import scrapy from Tencent.items import TencentIte ...
- pymongodb的使用和一个腾讯招聘爬取的案例
一.在python3中操作mongodb 1.连接条件 安装好pymongo库 启动mongodb的服务端(如果是前台启动后就不关闭窗口,窗口关闭后服务端也会跟着关闭) 3.使用 import pym ...
- 简单的scrapy实战:爬取腾讯招聘北京地区的相关招聘信息
简单的scrapy实战:爬取腾讯招聘北京地区的相关招聘信息 简单的scrapy实战:爬取腾讯招聘北京地区的相关招聘信息 系统环境:Fedora22(昨天已安装scrapy环境) 爬取的开始URL:ht ...
- 学习笔记之Python全栈开发/人工智能公开课_腾讯课堂
Python全栈开发/人工智能公开课_腾讯课堂 https://ke.qq.com/course/190378 https://github.com/haoran119/ke.qq.com.pytho ...
- Scrapy 项目:腾讯招聘
目的: 通过爬取腾讯招聘网站(https://careers.tencent.com/search.html)练习Scrapy框架的使用 步骤: 1.通过抓包确认要抓取的内容是否在当前url地址中,测 ...
- 历峰集团3.43亿美元收购Net-a-Porter剩余股权_财经_腾讯网
历峰集团3.43亿美元收购Net-a-Porter剩余股权_财经_腾讯网 历峰集团3.43亿美元收购Net-a-Porter剩余股权
- 大Q品牌故事_大Q官网_腾讯旗下买卖宝公司倾力打造
大Q品牌故事_大Q官网_腾讯旗下买卖宝公司倾力打造 走在大路上的改变者,有态度的互联网手机品牌
- 凡客副总裁崔晓琦离职 曾负责旗下V+商城项目_科技_腾讯网
凡客副总裁崔晓琦离职 曾负责旗下V+商城项目_科技_腾讯网 凡客副总裁崔晓琦离职 曾负责旗下V+商城项目 腾讯科技[微博]乐天2013年09月18日12:44 分享 微博 空间 微信 新浪微博 邮箱 ...
随机推荐
- H5 类选择器
10-类选择器 错误的写法: --> 迟到毁一生 早退穷三代 按时上下班 必成高富帅 我是段落 我是段落 <!DOCTYPE html> <html lang="en ...
- react 项目搭建
1.首先运行环境-node是必须的,需要下载安装node的运行环境: 2.安装好了node之后,自然的就有了npm: 3.npm install -g creact-react-app/全局安装cre ...
- Tarjan算法(缩点)
因为最近在学2sat,需要学习前置技能—Tarjan算法,所以花了一天的时间学习这个算法 算法步骤: 1.从一个点开始dfs,并加入栈 2.如果下一个点没有到过,跳到第一步 3.如果下一个点到过,并且 ...
- Imbalanced Array CodeForces - 817D (思维+单调栈)
You are given an array a consisting of n elements. The imbalance value of some subsegment of this ar ...
- 实时采集新加坡交易所A50指数
http://www.investing.com/indices/ftse-china-a50 前段时间有人问我如何得到这个网页的实时指数变化,经过抓包发现该网站提供的指数实时变化是通过Websock ...
- YARN的笔记
- C# 和 c++的语法不同点
GC Garbage Collection 垃圾回收器 自动释放资源 关键字: new 1.创建对象 2.隐藏从父类继承的同名函数 using 1.引用命名空间 2. using(FileStrea ...
- python3 九九乘法表打印花式操作(然并卵)
# 九九乘法表# 方法一# for i in range(1, 10):# for j in range(1, i+1):# print('{}x{}={}\t'.format(i, j, i*j), ...
- spring aop学习记录
许多AOP框架,比较常用的是Spring AOP 与AspectJ.这里主要学习的Spring AOP. 关于AOP 日志.事务.安全验证这些通用的.散步在系统各处的需要在实现业务逻辑时关注的事情称为 ...
- [转帖]Windows批处理(cmd/bat)常用命令小结
Windows批处理(cmd/bat)常用命令小结 非常值得学习的文档 先放这里 有时间做实验, 转载自:“趣IT”微信公共号 前言 批处理文件(batch file)包含一系列 DOS命令,通常用于 ...