
Scrapy 项目:腾讯招聘
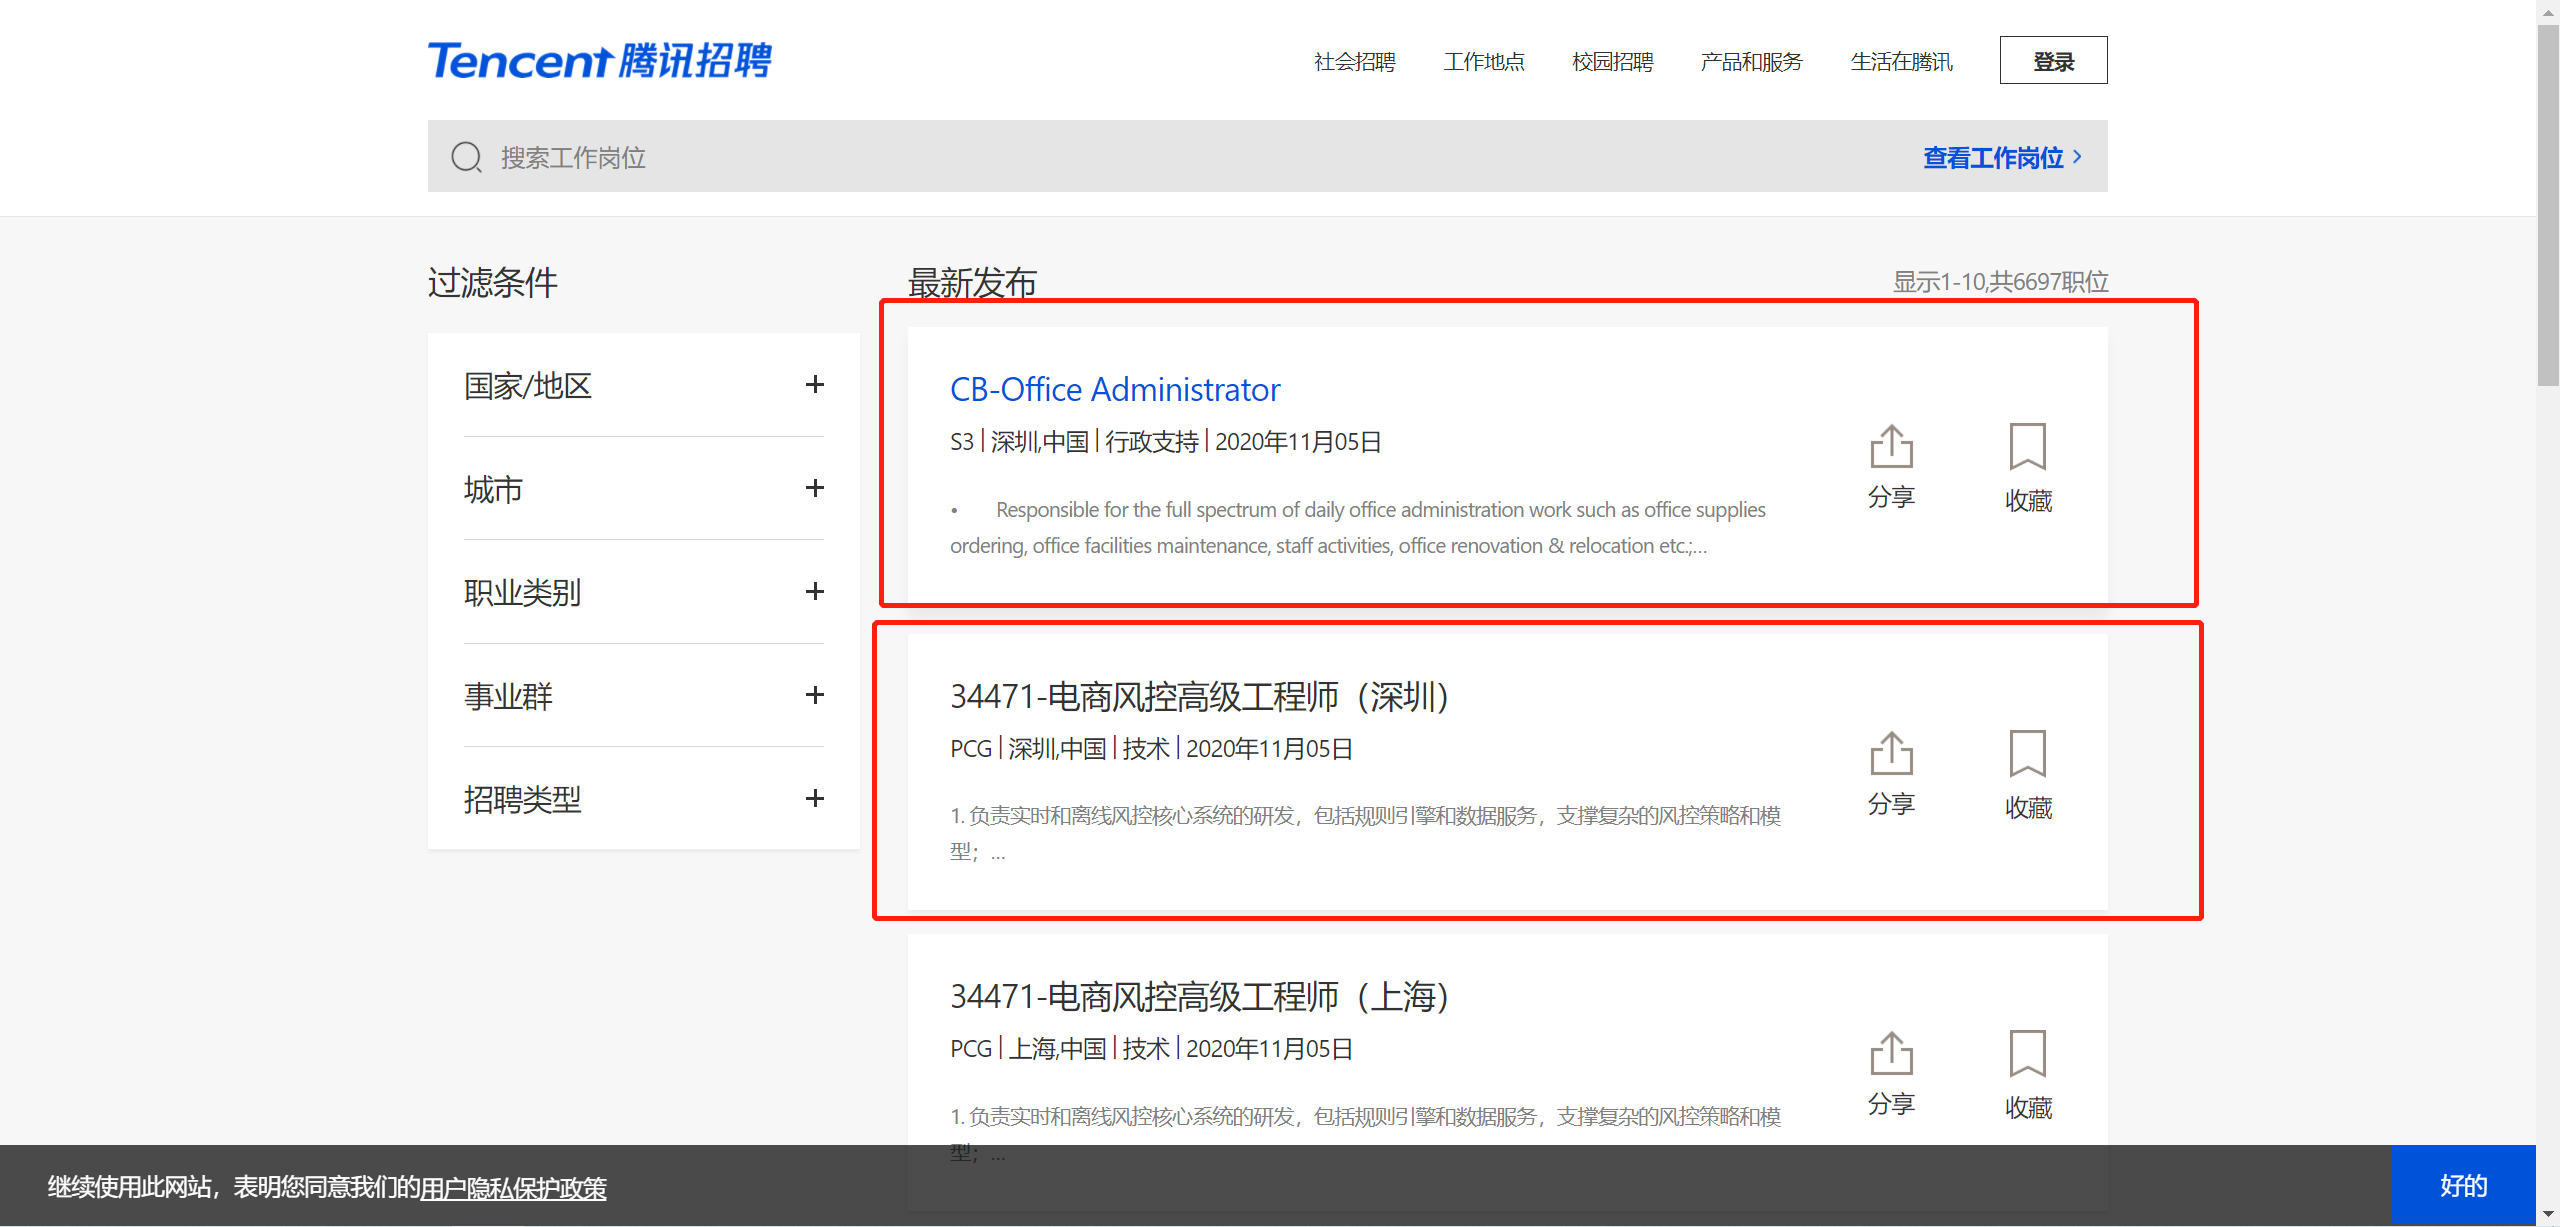
目的:
通过爬取腾讯招聘网站(https://careers.tencent.com/search.html)练习Scrapy框架的使用
步骤:
1、通过抓包确认要抓取的内容是否在当前url地址中,测试发现内容不在当前url中并且数据格式为json字符串
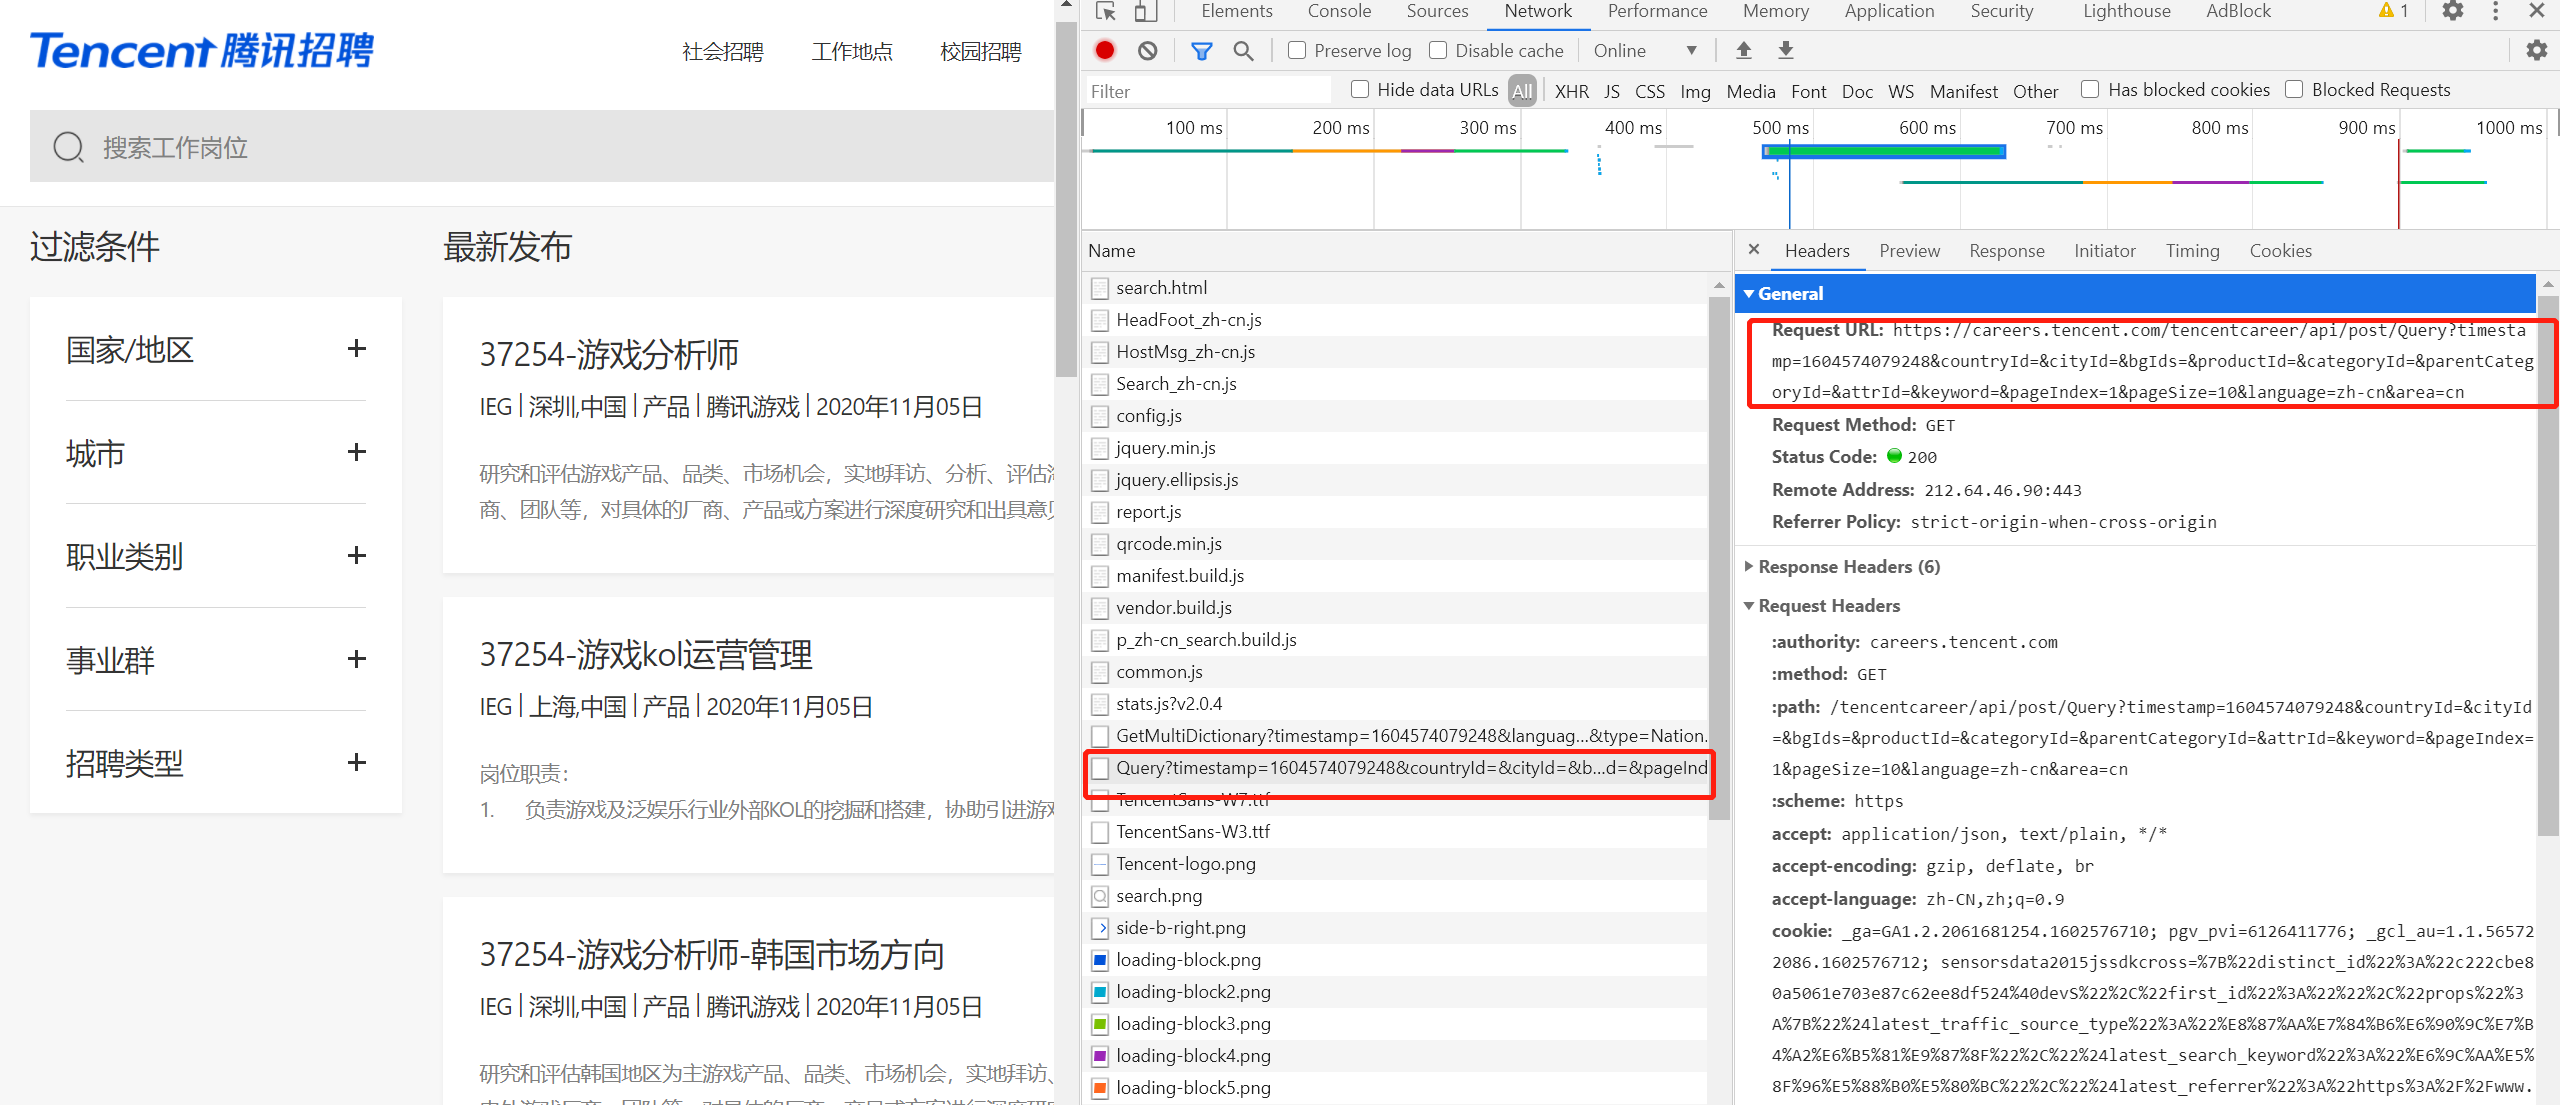
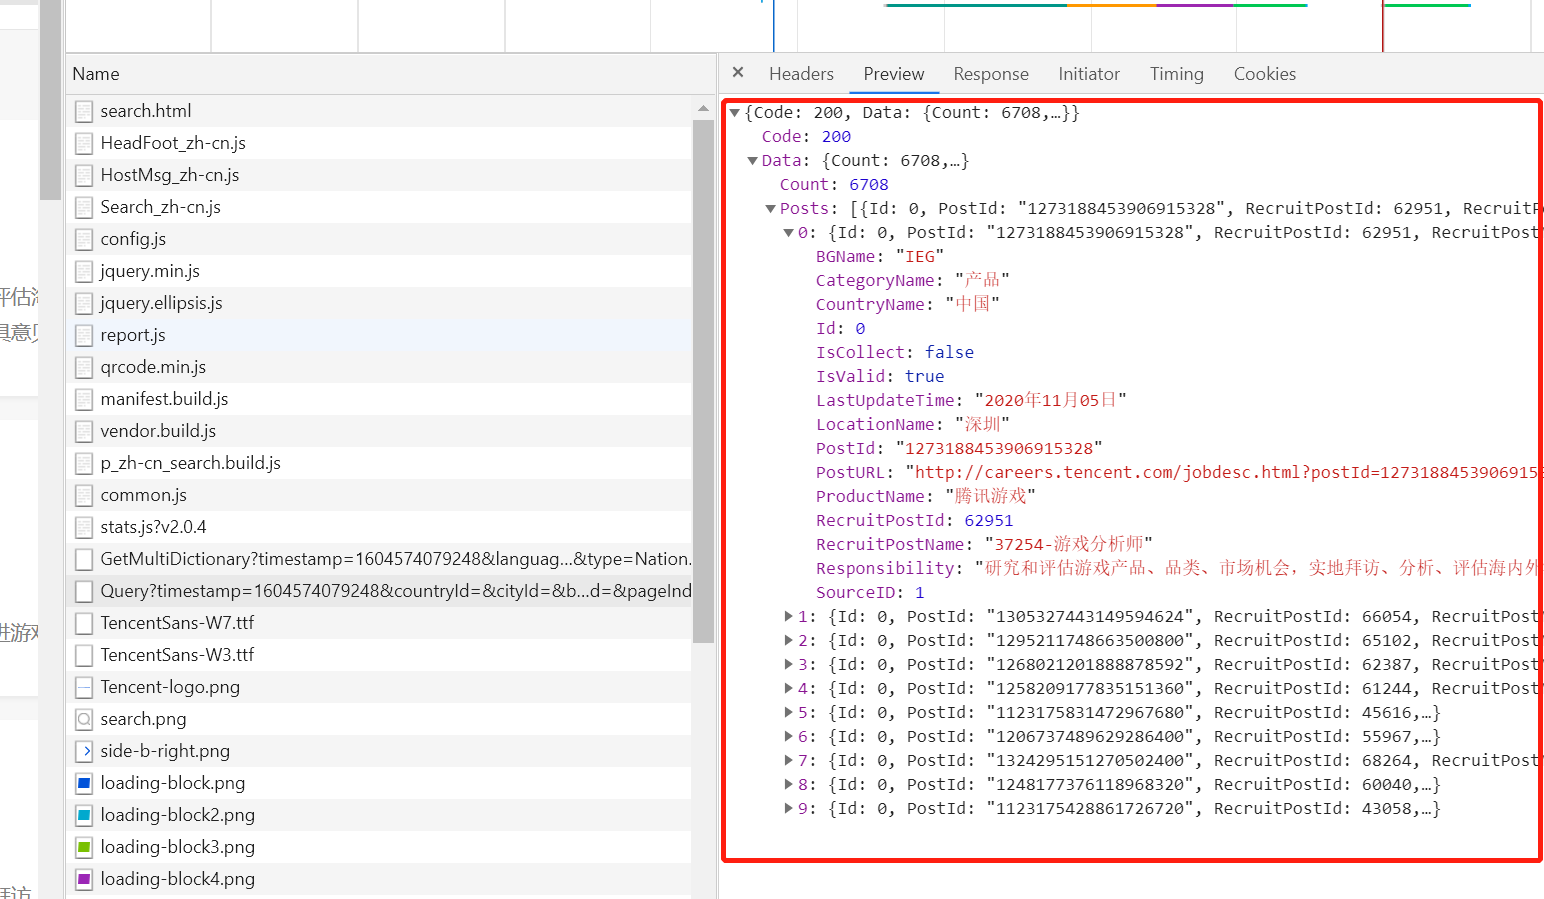
2、请求url地址过长,考虑去除某些部分,经测试得到
'https://careers.tencent.com/tencentcareer/api/post/Query?keyword=&pageIndex=1&pageSize=10&language=zh-cn&area=cn'
3、寻找url地址,pageIndex=页码,可构造爬虫循环的URL列表
4、书写爬虫代码
- scrapy startproject tencent tencent.com
- cd tencent.com
- scrapy genspider hr tencent.com
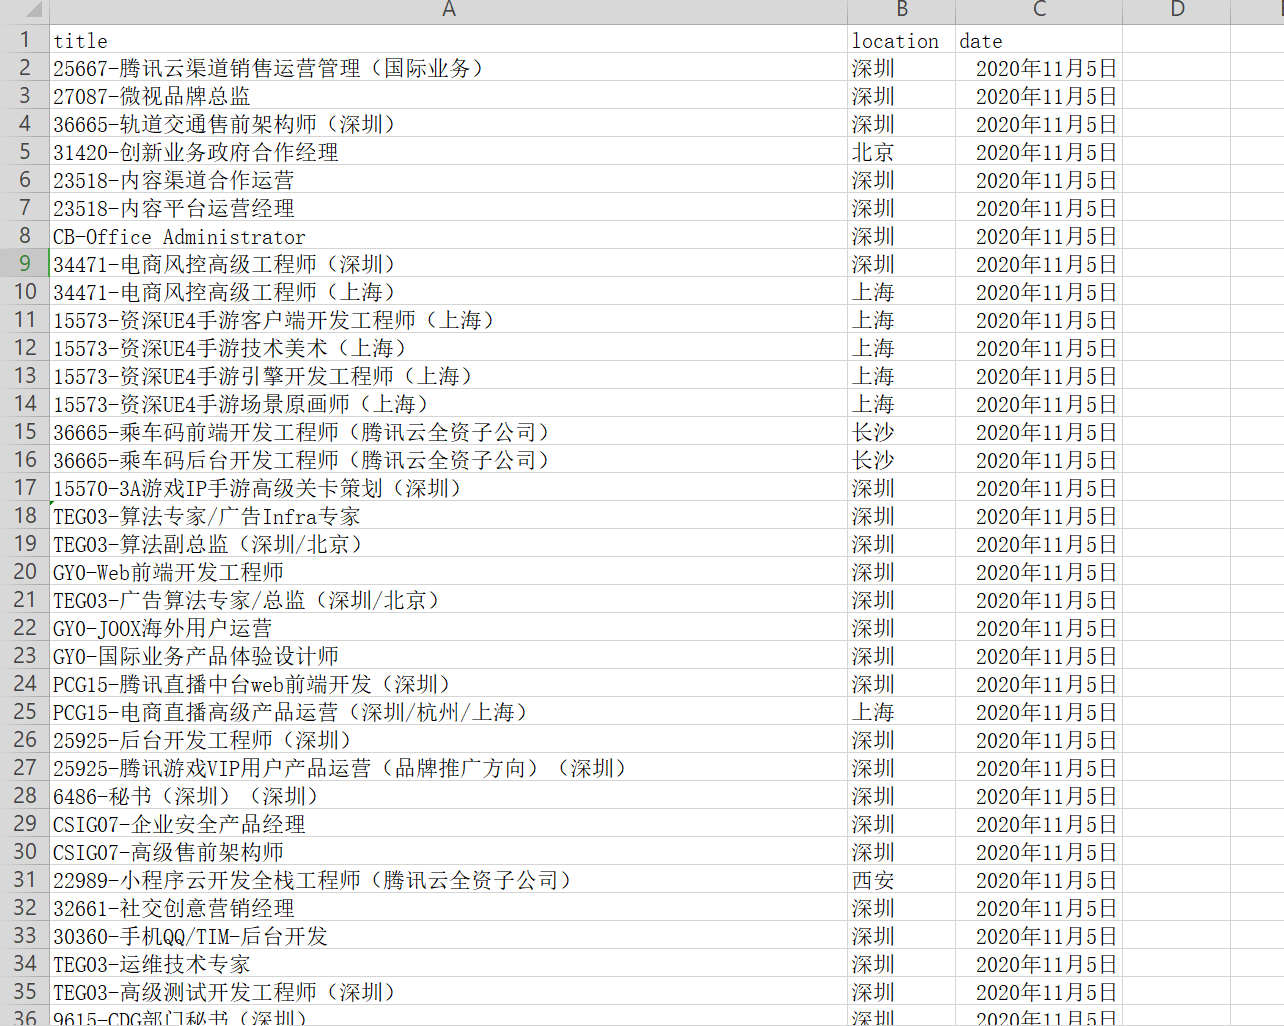
5、保存为CSV文件
 1 import scrapy

 2 import json

 3

 4

 5 class HrSpider(scrapy.Spider):

 6     name = 'hr'

 7     allowed_domains = ['tencent.com']

 8     start_urls = ['https://careers.tencent.com/tencentcareer/api/post/Query?keyword=&pageIndex=1&pageSize=10&language'

 9                   '=zh-cn&area=cn']

10     url = 'https://careers.tencent.com/tencentcareer/api/post/Query?keyword=&pageIndex={' \

11           '}&pageSize=10&language=zh-cn&area=cn '

12     pageIndex = 1

13

14     def parse(self, response):

15         json_str = json.loads(response.body)

16         for content in json_str["Data"]["Posts"]:

17             content_dic = {"title": content["RecruitPostName"], "location": content["LocationName"],

18                            "date": content["LastUpdateTime"]}

19             print(content_dict)20
         yield content_dic

21

23         if self.pageIndex < 10:

24             self.pageIndex += 1

25             next_url = self.url.format(self.pageIndex)

26             yield scrapy.Request(url=next_url, callback=self.parse)
运行爬虫
- scrapy crawl hr
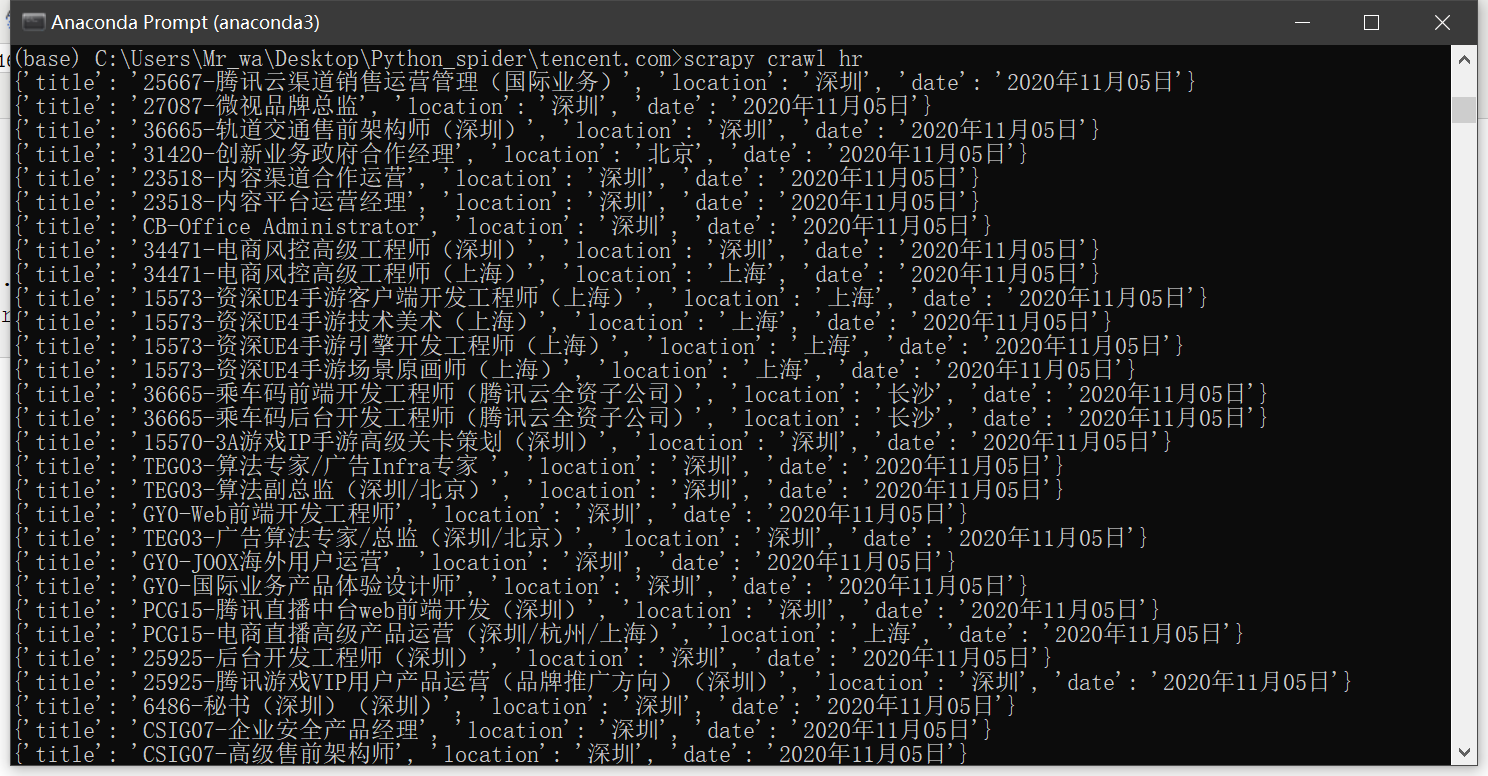
保存命令
- scrapy crawl hr -o tencent.csv
Scrapy 项目:腾讯招聘的更多相关文章
- Scrapy实现腾讯招聘网信息爬取【Python】
一.腾讯招聘网 二.代码实现 1.spider爬虫 # -*- coding: utf-8 -*- import scrapy from Tencent.items import TencentIte ...
- Scrapy:腾讯招聘整站数据爬取
项目地址:https://hr.tencent.com/ 步骤一.分析网站结构和待爬取内容 以下省略一万字 步骤二.上代码(不能略了) 1.配置items.py import scrapy class ...
- Scrapy案例02-腾讯招聘信息爬取
目录 1. 目标 2. 网站结构分析 3. 编写爬虫程序 3.1. 配置需要爬取的目标变量 3.2. 写爬虫文件scrapy 3.3. 编写yield需要的管道文件 3.4. setting中配置请求 ...
- Scrapy项目 - 实现腾讯网站社会招聘信息爬取的爬虫设计
通过使Scrapy框架,进行数据挖掘和对web站点页面提取结构化数据,掌握如何使用Twisted异步网络框架来处理网络通讯的问题,可以加快我们的下载速度,也可深入接触各种中间件接口,灵活的完成各种需求 ...
- Scrapy项目 - 数据简析 - 实现腾讯网站社会招聘信息爬取的爬虫设计
一.数据分析截图 本例实验,使用Weka 3.7对腾讯招聘官网中网页上所罗列的招聘信息,如:其中的职位名称.链接.职位类别.人数.地点和发布时间等信息进行数据分析,详见如下图: 图1-1 Weka ...
- 简单的scrapy实战:爬取腾讯招聘北京地区的相关招聘信息
简单的scrapy实战:爬取腾讯招聘北京地区的相关招聘信息 简单的scrapy实战:爬取腾讯招聘北京地区的相关招聘信息 系统环境:Fedora22(昨天已安装scrapy环境) 爬取的开始URL:ht ...
- python爬虫scrapy项目详解(关注、持续更新)
python爬虫scrapy项目(一) 爬取目标:腾讯招聘网站(起始url:https://hr.tencent.com/position.php?keywords=&tid=0&st ...
- pymongodb的使用和一个腾讯招聘爬取的案例
一.在python3中操作mongodb 1.连接条件 安装好pymongo库 启动mongodb的服务端(如果是前台启动后就不关闭窗口,窗口关闭后服务端也会跟着关闭) 3.使用 import pym ...
- 亲测——pycharm下运行第一个scrapy项目 ©seven_clear
最近在学习scrapy,就想着用pycharm调试,但不知道怎么弄,从网上搜了很多方法,这里总结一个我试成功了的. 首先当然是安装scrapy,安装教程什么的网上一大堆,这里推荐一个详细的:http: ...
随机推荐
- (十四)整合 ClickHouse数据库,实现数据高性能查询分析
整合 ClickHouse数据库,实现数据高性能查询分析 1.ClickHouse简介 1.1 数据分析能力 2.SpringBoot整个ClickHouse 2.1 核心依赖 2.2 配属数据源 2 ...
- Weblogic漏洞利用
Weblogic漏洞 Weblogic任意文件上传(CVE-2018-2894) 受影响版本 weblogic 10.3.6.0.weblogic 12.1.3.0.weblogic 12.2.1.2 ...
- Mysql数据库版本高低引起的group by问题
低版本的Mysql,group by限制性比较小,在进行group by时,select的对象可包含多个,但是换成高版本5.6以上好像,使用group by 以后,select的对象必须也已经被聚合, ...
- idea--忽略隐藏文件、文件夹的设置操作
文章由来 公司同事在群里问了个问题,如下: 为了大家看清,将图特意贴出来: 这人还删除idae重装了下,哈哈,才到群里问的. 解决思路(按顺序) 1.我让他直接拉会,共享桌面我给看了下,首先是open ...
- java类里的成员变量是自身的对象问题
今晚看单例模式饿汉时想到一个问题:假如java类里的成员变量是自身的对象,则新建该类对象时内存中怎么分配空间,我感觉似乎死循环了.于是上网搜索了下,哈哈,果然有人早就思考过这个问题了,站在巨人的肩膀上 ...
- DolphinScheduler 源码分析之 DAG类
1 /* 2 * Licensed to the Apache Software Foundation (ASF) under one or more 3 * contributor license ...
- Array循环for、for in、for of、forEach各间优劣
JavaScript中有多种循环Array的方式,你是否常常分不清他们的细微差别,和适用场景.本文将详细梳理各间的优缺点,整理成表以便对比. 循环 可访问element 可访问index 可迭代pro ...
- 前n项余数个数和
一:O(n) 计算贡献:前n项中,能被i(1~n)整除的数的个数为(n/i)个,,也就是 i 给前n项中(n/i)个数做了余数 #include<iostream> using names ...
- 【noi 2.6_2000】&【poj 2127】 最长公共子上升序列 (DP+打印路径)
由于noi OJ上没有Special Judge,所以我是没有在这上面AC的.但是在POJ上A了. 题意如标题. 解法:f[i][j]表示a串前i个和b串前j个且包含b[j]的最长公共上升子序列长度 ...
- 5.PowerShell DSC核心概念之资源
什么是资源? 资源为 DSC 配置提供构建基块. 资源公开可配置的属性,并包含本地配置管理器 (LCM) 调用以"使其如此"的 PowerShell 脚本函数. 系统内置资源 可在 ...