
Hadoop经典案例(排序&Join&topk&小文件合并)
①自定义按某列排序,二次排序
writablecomparable中的compareto方法

②topk
a利用treemap,缺点:map中的key不允许重复:https://blog.csdn.net/u010660276/article/details/50967054
b封装mapper<key,value>中的key实现writablecompareable接口,实现排序https://blog.csdn.net/lzm1340458776/article/details/43228191
③自定义分区函数:实现按省份输出信息
分区的目的:将相同的key值放到一个reduce中处理,将reduce处理完的数据按key分别存到不同的文件中
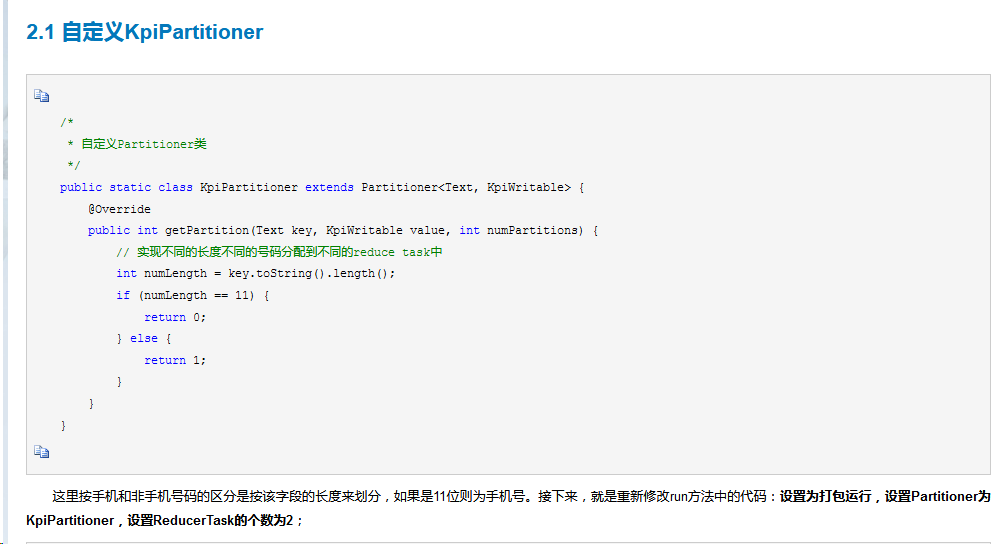
④数据去重
由于在map阶段之后会将相同key的value分组,分组之后的每一个key都是唯一的,消除数据去重时可以将数据直接作为map的key然后输出,map之后就会是唯一的,在reduce阶段直接输出就可。
⑤常用的输入格式:https://blog.csdn.net/u011812294/article/details/63262624
⑥mapreduce中的join:map端join和reduce端join(将需要连接操作的表同时或者选择小的加载到内存中)
map端join和reduce端join举例:https://blog.csdn.net/litianxiang_kaola/article/details/71598632
https://blog.csdn.net/guxin0729/article/details/84035513
map端join:在map的setup()中将小的表加入hashmap中,(指定小表path将表存入话说hashmap中)(在setup中读取小文件)
map()中实现读取一行将条件去匹配hashmap中的值,构造join表类
在main()中只需要指定inputmapperpath为map()中需要读取的大文件即可
reduce端join:mapper中将条件作为key,join的类为value
reducer中创建ArrayList,然后实现join
两者的对比:https://blog.csdn.net/weixin_39979119/article/details/85041438
如何选择:
reduce端join,当两个文件的大小差距较大时,会产生数据倾斜,在reducer中需要结合List
map端join,仅适用于大小表或者小小表关联
⑦小文件合并
Hadoop经典案例(排序&Join&topk&小文件合并)的更多相关文章
- hadoop 将HDFS上多个小文件合并到SequenceFile里
背景:hdfs上的文件最好和hdfs的块大小的N倍.如果文件太小,浪费namnode的元数据存储空间以及内存,如果文件分块不合理也会影响mapreduce中map的效率. 本例中将小文件的文件名作为k ...
- Hadoop MapReduce编程 API入门系列之小文件合并(二十九)
不多说,直接上代码. Hadoop 自身提供了几种机制来解决相关的问题,包括HAR,SequeueFile和CombineFileInputFormat. Hadoop 自身提供的几种小文件合并机制 ...
- Hadoop案例(六)小文件处理(自定义InputFormat)
小文件处理(自定义InputFormat) 1.需求分析 无论hdfs还是mapreduce,对于小文件都有损效率,实践中,又难免面临处理大量小文件的场景,此时,就需要有相应解决方案.将多个小文件合并 ...
- hadoop经典案例
hadoop经典案例http://blog.csdn.net/column/details/sparkhadoopdemo.html
- MR案例:小文件合并SequeceFile
SequeceFile是Hadoop API提供的一种二进制文件支持.这种二进制文件直接将<key, value>对序列化到文件中.可以使用这种文件对小文件合并,即将文件名作为key,文件 ...
- hive小文件合并设置参数
Hive的后端存储是HDFS,它对大文件的处理是非常高效的,如果合理配置文件系统的块大小,NameNode可以支持很大的数据量.但是在数据仓库中,越是上层的表其汇总程度就越高,数据量也就越小.而且这些 ...
- HDFS操作及小文件合并
小文件合并是针对文件上传到HDFS之前 这些文件夹里面都是小文件 参考代码 package com.gong.hadoop2; import java.io.IOException; import j ...
- Hive merge(小文件合并)
当Hive的输入由非常多个小文件组成时.假设不涉及文件合并的话.那么每一个小文件都会启动一个map task. 假设文件过小.以至于map任务启动和初始化的时间大于逻辑处理的时间,会造成资源浪费.甚至 ...
- hive优化之小文件合并
文件数目过多,会给HDFS带来压力,并且会影响处理效率,可以通过合并Map和Reduce的结果文件来消除这样的影响: set hive.merge.mapfiles = true ##在 map on ...
随机推荐
- FQ原理
笔者在nginx反向代理篇讲了正向代理和反向代理的区别,今天着重讲其中的FQ是实现原理. 一.普遍的两种方式 1.vpn vpn它将客户端的IP数据报经过加密和二次封装后转发出去,客户端通过vpn上网 ...
- 极验验证使用-滑动&选字验证码
准备 SDK下载 首先在极验官网下载好SDK,附上官网链接,点此可直接下载python版zip包. 模块安装 使用该SDK时发现它依赖两个模块,分别是geetest和requests. pip ins ...
- HDU 2586 How far away(dfs+邻接表)
How far away [题目链接]How far away [题目类型]dfs+邻接表 &题意: 题目大意:一个村子里有n个房子,这n个房子用n-1条路连接起来,接下了有m次询问,每次询问 ...
- phpcms网页替换验证码功能 及 搜索功能
在使用phpcms替换网页的时候,除了正常的替换栏目.内容页等,其他的什么验证码啦,提交表单了,搜索功能了,这些在替换的时候可能会对一些默认文件有一些小小 的改变 下面就是自己在失败中成功的过程,最后 ...
- php判断手机段登录,以及phpcms手机PC双模板调用
首先一段php代码判断是否为手机浏览: function isMobile() { // 如果有HTTP_X_WAP_PROFILE则一定是移动设备 if (isset ($_SERVER['HTTP ...
- Alpha阶段敏捷冲刺日志的集合贴
敏捷冲刺日志的集合贴 Day1(4.17):http://www.cnblogs.com/software-teamwork/p/8861426.html Day2(4.20):http://www. ...
- redis重要知识点
redis是一种高级的key:value存储系统,其中value支持五种数据类型: 1.字符串(strings) 2.字符串列表(lists) 3.字符串集合(sets) 4.有序字符串集合(sort ...
- django开发(二)
1.django数据库操作---model的使用以及django自带的数据api django中已经做了ORM,表就是一个类class,表中的一个项就是一个对象object,很好用 1.1django ...
- myeclipse集成meavn
环境准备: JDK 1.6 Maven 3.0.4 myeclipse 8.6.1 安装 Maven 之前要求先确定你的 JDK 已经安装配置完成.Maven是 Apache 下的一个项目,目前最新版 ...
- C语言实例:函数指针
函数指针:函数指针数组的使用: 不带参数和返回值的函数指针: #include <stdio.h> #include <stdlib.h> //定义一个没有返回值也没有入口参数 ...