
Python模拟微博登陆,亲测有效

今天想做一个微博爬个人页面的工具,满足一些不可告人的秘密。那么首先就要做那件必做之事!模拟登陆……
代码是参考了:https://www.douban.com/note/201767245/
我对代码进行了优化,重构成了Python 3.6 版本,并且加入了大量注释方便大家学习。
PC 登录新浪微博时, 在客户端用js预先对用户名、密码都进行了加密, 而且在POST之前会GET 一组参数,这也将作为POST_DATA 的一部分。 这样, 就不能用通常的那种简单方法来模拟POST 登录( 比如 人人网 )。
1.
在提交POST请求之前, 需要GET 获取两个参数。
地址是:
http://login.sina.com.cn/sso/login.php?client=ssologin.js(v1.3.18)
得到的数据中有 servertime 和 nonce 的值, 是随机的,其他值貌似没什么用。
def get_servertime():

   url = 'http://login.sina.com.cn/sso/prelogin.php?entry=weibo&callback=sinaSSOController.preloginCallBack&su=dW5kZWZpbmVk&client=ssologin.js(v1.3.18)&_=1329806375939'

   # 返回出来的是一个Response对象,无法直接获取,text后,可以通过正则匹配到

   # 大概长这样子的:sinaSSOController.preloginCallBack({"retcode":0,"servertime":1545606770, ...})

   data = requests.request('GET', url).text

   p = re.compile('\((.*)\)')

   try:

       json_data = p.search(data).group(1)

       data = json.loads(json_data)

       servertime = str(data['servertime'])

       nonce = data['nonce']

       return servertime, nonce

   except:

       print('获取 severtime 失败!')

       return None
2.
通过httpfox 观察POST 的数据, 参数较复杂,其中 “su" 是加密后的username, sp 是加密后的password。servertime 和 nonce 是上一步得到的。其他参数是不变的。
username 经过了BASE64 计算:
username = base64.encodestring( urllib.quote(username) )[:-1]
password 经过了三次SHA1 加密, 且其中加入了 servertime 和 nonce 的值来干扰。
即: 两次SHA1加密后, 将结果加上 servertime 和 nonce 的值, 再SHA1 算一次。
def get_pwd(pwd, servertime, nonce):

   # 第一次计算,注意Python3 的加密需要encode,使用bytes

   pwd1 = hashlib.sha1(pwd.encode()).hexdigest()

   # 使用pwd1的结果在计算第二次

   pwd2 = hashlib.sha1(pwd1.encode()).hexdigest()

   # 使用第二次的结果再加上之前计算好的servertime和nonce值,hash一次

   pwd3_ = pwd2 + servertime + nonce

   pwd3 = hashlib.sha1(pwd3_.encode()).hexdigest()

   return pwd3

def get_user(username):

   # 将@符号转换成url中能够识别的字符

   _username = urllib.request.quote(username)

   # Python3中的base64计算也是要字节

   # base64出来后,最后有一个换行符,所以用了切片去了最后一个字符

   username = base64.encodebytes(_username.encode())[:-1]

   return username
3.
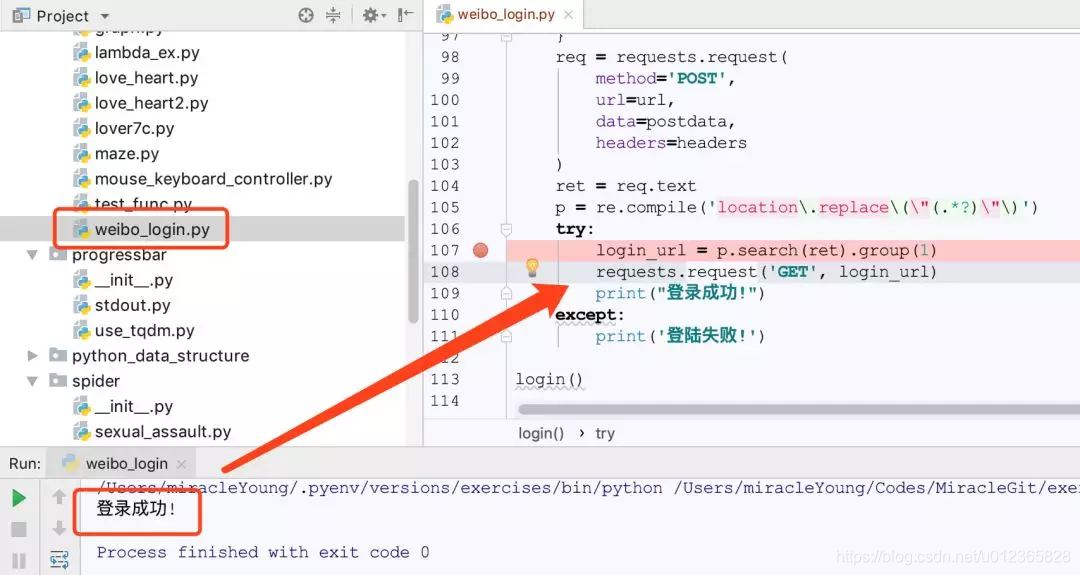
将参数组织好, POST请求。 这之后还没有登录成功。
POST后得到的内容中包含一句:
location.replace("http://weibo.com/ajaxlogin.php?framelogin=1&callback=parent.sinaSSOController.feedBackUrlCallBack&retcode=101&reason=%B5%C7%C2%BC%C3%FB%BB%F2%C3%DC%C2%EB%B4%ED%CE%F3")
这是登录失败时的结果, 登录成功后结果与之类似, 不过retcode 的值是0 。
接下来再请求这个URL,这样就成功登录到微博了。
记得要提前build 缓存。
关注公众号「Python专栏」,后台回复「模拟微博登陆」,获取全套微博自动登陆代码。

Python模拟微博登陆,亲测有效的更多相关文章
- Caffe初学者第一部:Ubuntu14.04上安装caffe(CPU)+Python的详细过程 (亲测成功, 20180524更新)
前言: 最近在学习深度学习,最先要解决的当然是开源框架的环境安装了.之前一直在学习谷歌的Tensorflow开源框架,最近实验中需要跟别人的算法比较,下载的别人的代码很多都是Caffe的,所以想着搭建 ...
- python模拟---注册登陆查看个人信息
需求:1.模拟注册: 2.模拟登陆: 3.模拟登陆成功显示登陆成功的用户账号: 一.注册 代码如下: def regetist(): ''' :param username: 注册的账号 :param ...
- 使用python玩跳一跳亲测使用步骤详解
玩微信跳一跳,测测python跳一跳,顺便蹭一蹭热度: 参考博文 使用python玩跳一跳超详细使用教程 WIN10系统,安卓用户请直入此: python辅助作者github账号为:wangshub. ...
- selenium + python自动化测试环境搭建--亲测
环境准备: 1.下载所学安装包: setuptools https://pypi.python.org/packages/2.7/s/setuptools/ selenium https://pypi ...
- 使用python模拟cookie登陆wooyun
import urllib2 class SimpleCookieHandler(urllib2.BaseHandler): def http_request(self, req): simple_c ...
- python模拟网站登陆-滑动验证码
普通滑动验证 以http://admin.emaotai.cn/login.aspx为例这类验证码只需要我们将滑块拖动指定位置,处理起来比较简单.拖动之前需要先将滚动条滚动到指定元素位置. impor ...
- python 模拟浏览器登陆coursera
import requests import random import string def randomString(length): return ''.join(random.choice(s ...
- HttpClient4的使用,模拟浏览器登陆新浪微博,发表微博和文字+图片微博
HttpClient4,最原始的需求就是使用其来模拟浏览器想服务器发起http请求,当然,他的功能不止于此,但是我需要的就是这个功能而已,jdk也有其自带的类似的api:UrlConnection,效 ...
- Python模拟登陆万能法-微博|知乎
Python模拟登陆让不少人伤透脑筋,今天奉上一种万能登陆方法.你无须精通HTML,甚至也无须精通Python,但却能让你成功的进行模拟登陆.本文讲的是登陆所有网站的一种方法,并不局限于微博与知乎,仅 ...
随机推荐
- react-native 新手爬坑经历(unable to load script from assets 和could not connect to development server.)
按照https://reactnative.cn/docs/0.51/getting-started.html教程新建的项目 react-native init AwesomeProject cd A ...
- logrotate-日志切割示例
logrotate是linux系统自带的工具,它可以自动对日志进行截断(或轮循).压缩以及删除旧的日志文件. 1)配置文件示例# cat /wls/wls81/bin/weblogic/wls/app ...
- centos7源码安装heartbeat可能出现的错误以及解决办法
问题:ipmilan_command.c: In function 'setup_ipmi_conn':ipmilan_command.c:283:2: error: 'sel_alloc_selec ...
- 页面引入js问题
今日问题:左侧菜单栏多余的菜单不可以滚动,自己找了很长时间,前端同事帮忙找了很长事件,最后帮我找到问题所在. 这里红色部分标识有多余部分,可以滑动是对的.但是滑动了. 问题:jquery引入的地方错了 ...
- 100-days: twelve
Title: Mark Zuckerberg wants Facebook's to emulate China's WeChat, but can it? emulate v.效仿,模仿 As ...
- Head First Servlets & JSP 学习笔记 第九章 —— 使用JSTL
JSTL1.1 不是JSP2.0规范的一部分!你能访问Servlet和JSP API 不意味着你能访问JSTL! 使用JSTL之前,需要将两个文件("jstl.jar" 和 &qu ...
- stark组件开发之列表页面应用示例
已经解决的,自定义的扩展函数,功能.但是 不可能返回. 一个 固定的页面把! 应该是,点击那条 记录之后的编辑, 就会跳转到相应的,编辑页面.所以 这个标签的 <a href="/ ...
- 第一个用IDEA写的程序——“前言中不允许有内容”
"前言中不允许有内容" 这是用IDEA写的第一个程序-- 它出现了一些问题 让人很难过 希望有人可以帮助解答,谢谢 程序是这样子的 运行完是这样显示的
- node.js 调试问题
最近打算在项目过程中使用node.js辅助解决一些问题,需要用到node.js的调试技术. 通常而言,大家都会提到debugger或者node-inspector方法. debugger方法谁用谁知道 ...
- Tomcat9报错 The valid characters are defined in RFC 7230 and RFC 3986
tomcat8项目移到tomcat9,出现如下问题 HTTP Status 400 – Bad Request Type Exception Report Message Invalid charac ...