
dubbo2.7.X版本带来的服务注册和服务调用方式改变
参考地址:https://www.cnblogs.com/alisystemsoftware/p/13064620.html
注册中心数据结构格式改变(service:接口服务,application:同个应用实例组成的集合,instance:单个应用实例),带来的是“服务自省”
以 Dubbo 当前的地址发现数据格式为例,它是“RPC 服务粒度”的,它是以 RPC 服务作为 key,以实例列表作为 value 来组织数据的:
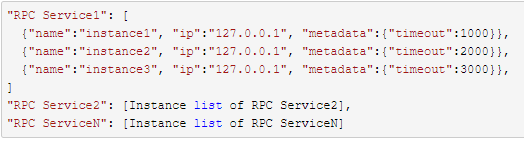
而我们新引入的“应用粒度的服务发现”,它以应用名(Application)作为 key,以这个应用部署的一组实例(Instance)列表作为 value。这带来两点不同:

数据映射关系变了,从 RPC Service -> Instance 变为 Application -> Instance;
数据变少了,注册中心没有了 RPC Service 及其相关配置信息。
以上的改变是称为应用级服务发现的基本机制,接着解释它为什么会被叫做“服务自省”?
其实这还是得从它的工作原理说起,上面我们提到,应用粒度服务发现的数据模型有几个以下明显变化:数据中心的数据量少了,RPC 服务相关的数据在注册中心没有了,现在只有 application - instance 这两个层级的数据。为了保证这部分缺少的 RPC 服务数据仍然能被 Consumer 端正确的感知,我们在 Consumer 和 Provider 间建立了一条单独的通信通道:Consumer 和 Provider 两两之间通过特定端口交换信息,我们把这种 Provider 自己主动暴露自身信息的行为认为是一种内省机制,因此从这个角度出发,我们把整个机制命名为:服务自省。
这样的改变给出了 Dubbo 往应用级服务发现靠拢的好处或原因,但这么做的同时接口粒度的服务治理能力还是要继续保留,这是 Dubbo 框架编程模型易用性、服务治理能力优势的基础。
以下是服务自省的一个完整工作流程图,详细描述了服务注册、服务发现、MetadataService、RPC 调用间的协作流程。
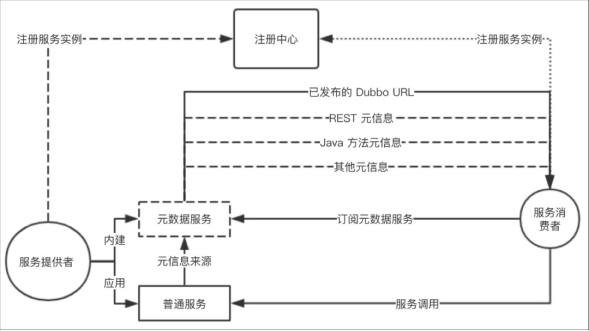
服务提供者启动,首先解析应用定义的“普通服务”并依次注册为 RPC 服务,紧接着注册内建的 MetadataService 服务,最后打开 TCP 监听端口;
启动完成后,将实例信息注册到注册中心(仅限 ip、port 等实例相关数据),提供者启动完成;
服务消费者启动,首先依据其要“消费的 provider 应用名”到注册中心查询地址列表,并完成订阅(以实现后续地址变更自动通知);
消费端拿到地址列表后,紧接着对 MetadataService 发起调用,返回结果中包含了所有应用定义的“普通服务”及其相关配置信息;
至此,消费者可以接收外部流量,并对提供者发起 Dubbo RPC 调用。
元数据同步机制
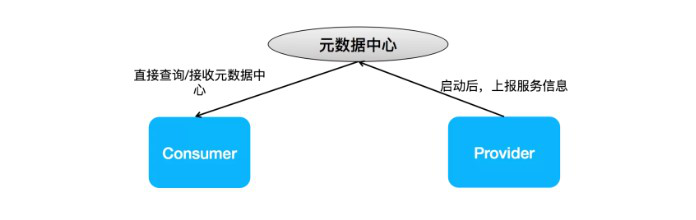
Client 与 Server 间在收到地址推送后的配置同步是服务自省的关键环节,目前针对元数据同步有两种具体的可选方案,分别是:内建 MetadataService;独立的元数据中心,通过中细化的元数据集群协调数据。
内建 MetadataService:MetadataService 通过标准的 Dubbo 协议暴露,根据查询条件,会将内存中符合条件的“普通服务”配置返回给消费者。这一步发生在消费端选址和调用前;
元数据中心:复用 2.7 版本中引入的元数据中心,provider 实例启动后,会尝试将内部的 RPC 服务组织成元数据的格式到元数据中心,而 consumer 则在每次收到注册中心推送更新后,主动查询元数据中心。
注意 consumer 端查询元数据中心的时机,是等到注册中心的地址更新通知之后。也就是通过注册中心下发的数据,我们能明确的知道何时某个实例的元数据被更新了,此时才需要去查元数据中心。
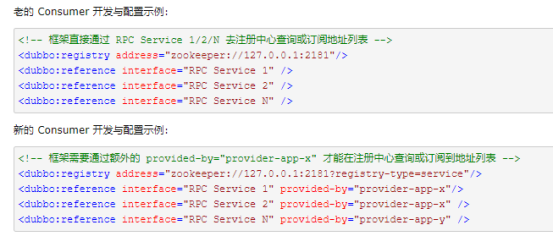
引用服务配置带来的改变:
dubbo2.7.X版本带来的服务注册和服务调用方式改变的更多相关文章
- 【转】用 Consul 来做服务注册与服务发现
原文:https://segmentfault.com/a/1190000018731395?utm_source=tag-newest ------------------------------- ...
- SpringCloud+Consul 服务注册与服务发现
SpringCloud+Consul 服务注册与服务发现 1. 服务注册: 在Spring.factories有一段: # Discovery Client Configuration org.spr ...
- SpringCloud实战之初级入门(二)— 服务注册与服务调用
目录 1.环境介绍 2.服务提供 2.1 创建工程 2.2 修改配置文件 2.3 修改启动文件 2.5 亲测注意事项 3.服务调用 3.1 创建工程 3.2 修改配置文件 3.3 修改启动文件 3.4 ...
- SpringCloud之eureka服务注册和服务发现
服务注册中心 :eureka-server 作用:服务注册中心提供服务注册功能 服务提供方:eureka-client 作用:注册服务到服务注册中心 服务注册中心 :eureka-server 创建 ...
- consul服务注册与服务发现的巨坑
最近使用consul作为项目的服务注册与服务发现的基础功能.在塔建集群使用中遇到一些坑,下面一个个的记录下来. consul集群多node consul集群的node也就是我们所说的consul实例. ...
- SpringCloud系列(一):Eureka 服务注册与服务发现
上一篇,我们介绍了服务注册中心,光有服务注册中心没有用,我们得发服务注册上去,得从它那边获取服务.下面我们注册一个服务到服务注册中心上去. 我们创建一个 hello-service 的 spring ...
- Go微服务框架go-kratos实战04:kratos中服务注册和服务发现的使用
一.简介 关于服务注册和服务发现介绍,我前面的文章有介绍过 - 服务注册和发现的文章. 作为服务中心的软件有很多,比如 etcd,consul,nacos,zookeeper 等都可以作为服务中心. ...
- Windows环境下实现Consul服务注册和服务发现
1.首先从官方网站下载Consul,因为我们是使用的Windows系统,所以选择windows版本 https://www.consul.io/downloads.html 2.可以用开发者模式来启动 ...
- Consul 服务注册与服务发现
上一篇:Mac OS.Ubuntu 安装及使用 Consul 1. 服务注册 对 Consul 进行服务注册之前,需要先部署一个服务站点,我们可以使用 ASP.NET Core 创建 Web 应用程序 ...
随机推荐
- python使用xpath(超详细)
使用时先安装 lxml 包 开始使用 和beautifulsoup类似,首先我们需要得到一个文档树 把文本转换成一个文档树对象 from lxml import etree if __name__ = ...
- Java源码详解系列(十一)--Spring的使用和源码
Spring 是一个一站式的 Java 框架,致力于提高我们项目开发的效率.通过 Spring,我们可以避免编写大量额外代码,更专注于我们的核心逻辑.目前,Spring 已经成为最受欢迎的 Java ...
- docker-创建容器常见选项
1. docker run创建容器常见选项 1.1 创建容器 选项 描述 -i,-interactive 交互式 -t,-tty 分配一个伪终端 -d,-detach 运行容器到后台 -e,-env ...
- 推荐一款IDEA神器!一键查看Java字节码以及其他类信息
由于后面要分享的一篇文章中用到了这篇文章要推荐的一个插件,所以这里分享一下.非常实用!你会爱上它的! 开始推荐 IDEA 字节码查看神器之前,先来回顾一下 Java 字节码是啥. 何为 Java 字节 ...
- GIT 保存日志并建立自己的分支
以下是我个人在工作中对git的愚见全是大白话说明.也是我踩坑记录吧,防止下次再次踩坑. 再已有的dev(开发分支)新建自己的分支 (featuer)在更新到gitlab 仓库中的过程. 首先要有大致的 ...
- leaflet如何加载10万数据
作为一名GIS开发者,你工作中一定遇到过这种问题,根据业务设计,需要在地图上添加1万+条数据,数据或是点.或是线.或是面.但不管哪种,当你添加到5000条时,地图操作就会出现明显的卡顿.当你添加超过1 ...
- 安装两个Eclipse 版本不一致,高版本无法打开
Could not create the JavaVirtual Machine,A fatal exception has occurred. 首先删除了 工作空间的配置 然后删除掉C:\Windo ...
- Linux发行版教你如何选 给入门者的选择通法
Linux的发行版何止琳琅满目,简直是乱入你眼. 本篇将介绍选择发行版的经验和通用法则,主要会从PC角度去谈. 更新于2020年,初次发布于2017年 选择发行版需考虑哪些因素 选择发行版时需要考虑的 ...
- go 结构体与方法
go 结构体与方法 go 结构体相当于 python 中类的概念,结构体用来定义复杂的数据结构,存储很多相同的字段属性 结构体的定义 1.结构体的定义以及简单实用 package main imp ...
- linux(centos8):用grep命令查找文件内容
一,grep的用途: linux平台有最常用的三大文本处理工具:awk/sed/grep grep的功能:搜索指定文件的内容,按照指定的模式匹配,并输出匹配内容所在的行. 需要注意的地方:grep只支 ...