
ELK入门级介绍--打造实时日志查询系统
这几天一直在研究ElasticSearch,在网上看到一篇好的文章和大家分享.
ELK平台介绍
在搜索ELK资料的时候,发现这篇文章比较好,于是摘抄一小段:
以下内容来自:http://baidu.blog.51cto.com/71938/1676798
日志主要包括系统日志、应用程序日志和安全日志。系统运维和开发人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷,性能安全性,从而及时采取措施纠正错误。
通常,日志被分散的储存不同的设备上。如果你管理数十上百台服务器,你还在使用依次登录每台机器的传统方法查阅日志。这样是不是感觉很繁琐和效率低下。当务之急我们使用集中化的日志管理,例如:开源的syslog,将所有服务器上的日志收集汇总。
集中化管理日志后,日志的统计和检索又成为一件比较麻烦的事情,一般我们使用grep、awk和wc等Linux命令能实现检索和统计,但是对于要求更高的查询、排序和统计等要求和庞大的机器数量依然使用这样的方法难免有点力不从心。
开源实时日志分析ELK平台能够完美的解决我们上述的问题,ELK由ElasticSearch、Logstash和Kiabana三个开源工具组成。官方网站:https://www.elastic.co/products
Elasticsearch是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。
Logstash是一个完全开源的工具,他可以对你的日志进行收集、过滤,并将其存储供以后使用(如,搜索)。
Kibana 也是一个开源和免费的工具,它Kibana可以为 Logstash 和 ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助您汇总、分析和搜索重要数据日志。
----------------------------摘抄内容结束-------------------------------
画了一个ELK工作的原理图:
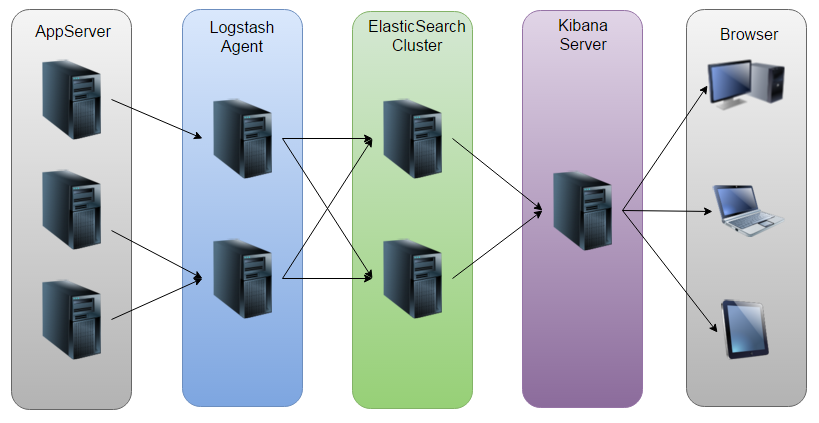
如图:Logstash收集AppServer产生的Log,并存放到ElasticSearch集群中,而Kibana则从ES集群中查询数据生成图表,再返回给Browser。
ELK平台搭建
系统环境
System: Centos release 6.7 (Final)
ElasticSearch: 2.1.0
Logstash: 2.1.1
Kibana: 4.3.0
Java: openjdk version "1.8.0_65"
注:由于Logstash的运行依赖于Java环境, 而Logstash 1.5以上版本不低于java 1.7,因此推荐使用最新版本的Java。因为我们只需要Java的运行环境,所以可以只安装JRE,不过这里我依然使用JDK,请自行搜索安装。
ELK下载:https://www.elastic.co/downloads/
ElasticSearch
配置ElasticSearch:
tar -zxvf elasticsearch-2.1.0.tar.gz

cd elasticsearch-2.1.0
安装Head插件(Optional):
./bin/plugin install mobz/elasticsearch-head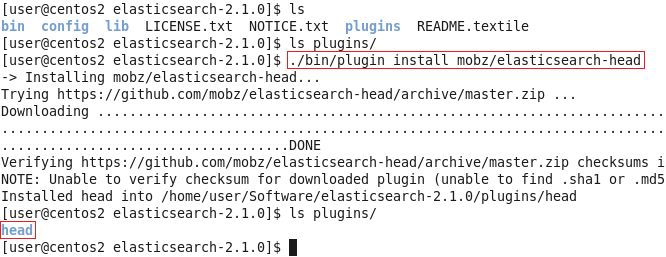
然后编辑ES的配置文件:
vi config/elasticsearch.yml修改以下配置项:
cluster.name=es_cluster

node.name=node0

path.data=/tmp/elasticsearch/data

path.logs=/tmp/elasticsearch/logs

#当前hostname或IP,我这里是centos2

network.host=centos2

network.port=9200
其他的选项保持默认,然后启动ES:
./bin/elasticsearch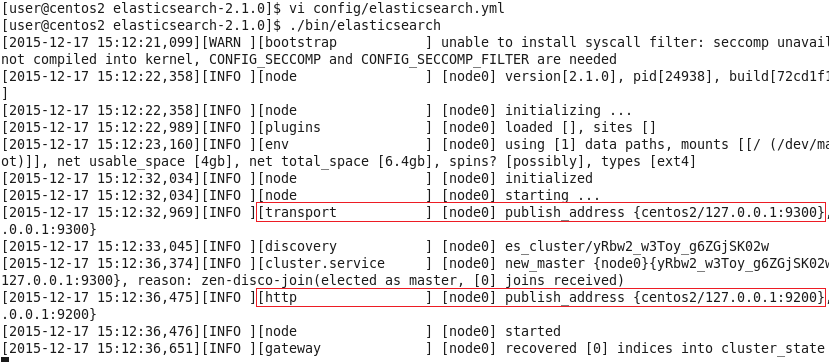
可以看到,它跟其他的节点的传输端口为9300,接受HTTP请求的端口为9200。
使用ctrl+C停止。当然,也可以使用后台进程的方式启动ES:
./bin/elasticsearch &然后可以打开页面localhost:9200,将会看到以下内容:
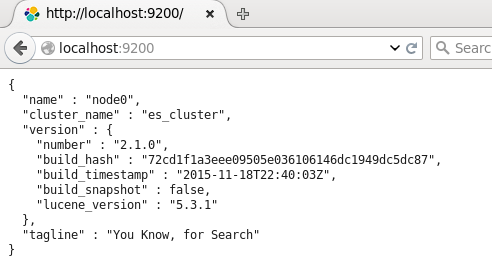
返回展示了配置的cluster_name和name,以及安装的ES的版本等信息。
刚刚安装的head插件,它是一个用浏览器跟ES集群交互的插件,可以查看集群状态、集群的doc内容、执行搜索和普通的Rest请求等。现在也可以使用它打开localhost:9200/_plugin/head页面来查看ES集群状态:

可以看到,现在,ES集群中没有index,也没有type,因此这两条是空的。
Logstash
Logstash的功能如下:
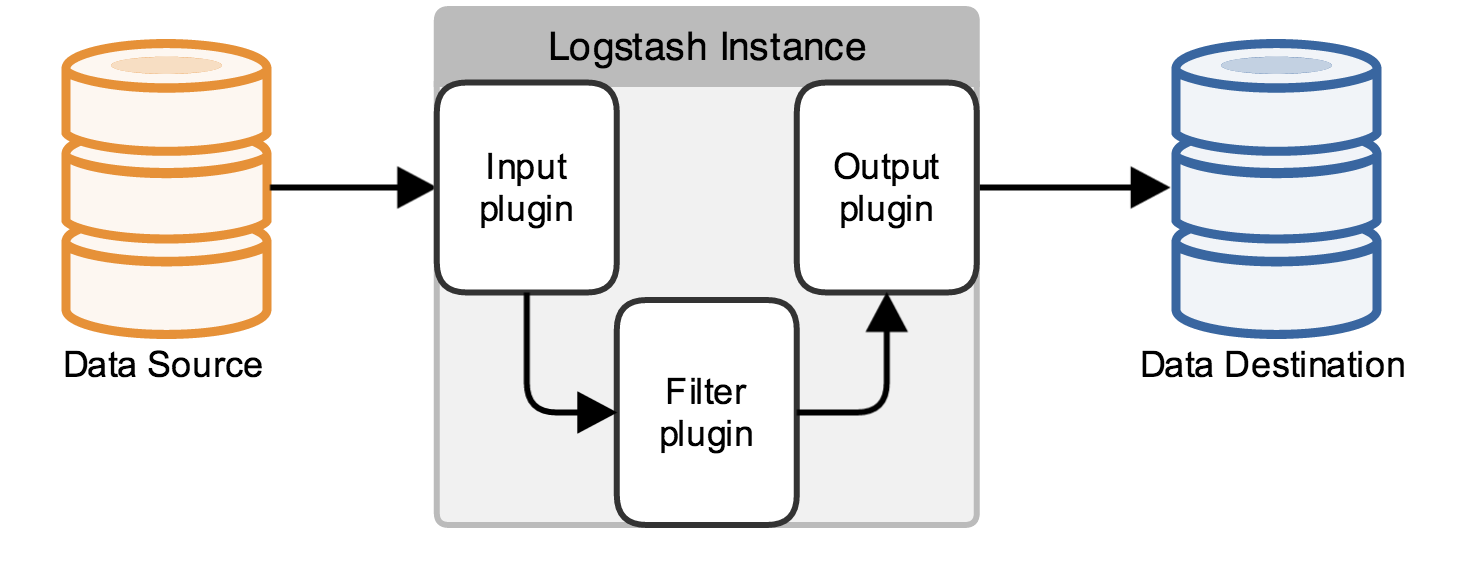
其实它就是一个收集器而已,我们需要为它指定Input和Output(当然Input和Output可以为多个)。由于我们需要把Java代码中Log4j的日志输出到ElasticSearch中,因此这里的Input就是Log4j,而Output就是ElasticSearch。
配置Logstash:
tar -zxvf logstash-2.1.1.tar.gz

cd logstash-2.1.1
编写配置文件(名字和位置可以随意,这里我放在config目录下,取名为log4j_to_es.conf):
mkdir config

vi config/log4j_to_es.conf
输入以下内容:
# For detail structure of this file

# Set: https://www.elastic.co/guide/en/logstash/current/configuration-file-structure.html

input {

  # For detail config for log4j as input,

  # See: https://www.elastic.co/guide/en/logstash/current/plugins-inputs-log4j.html

  log4j {

    mode => "server"

    host => "centos2"

    port => 4567

  }

}

filter {

  #Only matched data are send to output.

}

output {

  # For detail config for elasticsearch as output,

  # See: https://www.elastic.co/guide/en/logstash/current/plugins-outputs-elasticsearch.html

  elasticsearch {

    action => "index"          #The operation on ES

    hosts  => "centos2:9200"   #ElasticSearch host, can be array.

    index  => "applog"         #The index to write data to.

  }

}
logstash命令只有2个参数:
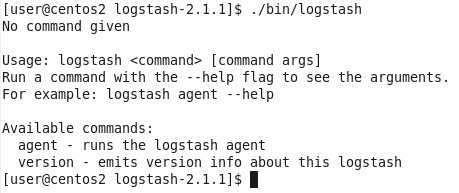
因此使用agent来启动它(使用-f指定配置文件):
./bin/logstash agent -f config/log4j_to_es.conf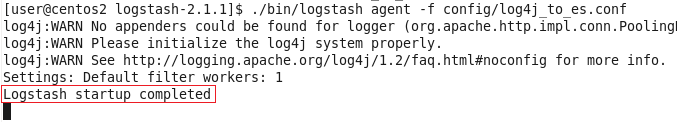
到这里,我们已经可以使用Logstash来收集日志并保存到ES中了,下面来看看项目代码。
Java项目
照例先看项目结构图:
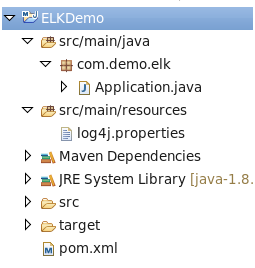
pom.xml,很简单,只用到了Log4j库:
<dependency>

    <groupId>log4j</groupId>

    <artifactId>log4j</artifactId>

    <version>1.2.17</version>

</dependency>log4j.properties,将Log4j的日志输出到SocketAppender,因为官网是这么说的:
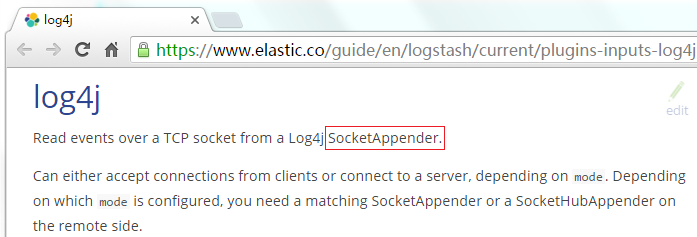
log4j.rootLogger=INFO,console

# for package com.demo.elk, log would be sent to socket appender.

log4j.logger.com.demo.elk=DEBUG, socket

# appender socket

log4j.appender.socket=org.apache.log4j.net.SocketAppender

log4j.appender.socket.Port=4567

log4j.appender.socket.RemoteHost=centos2

log4j.appender.socket.layout=org.apache.log4j.PatternLayout

log4j.appender.socket.layout.ConversionPattern=%d [%-5p] [%l] %m%n

log4j.appender.socket.ReconnectionDelay=10000

# appender console

log4j.appender.console=org.apache.log4j.ConsoleAppender

log4j.appender.console.target=System.out

log4j.appender.console.layout=org.apache.log4j.PatternLayout

log4j.appender.console.layout.ConversionPattern=%d [%-5p] [%l] %m%n注意:这里的端口号需要跟Logstash监听的端口号一致,这里是4567。
Application.java,使用Log4j的LOGGER打印日志即可:
package com.demo.elk;

import org.apache.log4j.Logger;

public class Application {

    private static final Logger LOGGER = Logger.getLogger(Application.class);

    public static void main(String[] args) throws Exception {

        for (int i = 0; i < 10; i++) {

            LOGGER.error("Info log [" + i + "].");

            Thread.sleep(500);

        }

    }

}
用Head插件查看ES状态和内容
运行Application.java,先看看console的输出(当然,这个输出只是为了做验证,不输出到console也可以的):
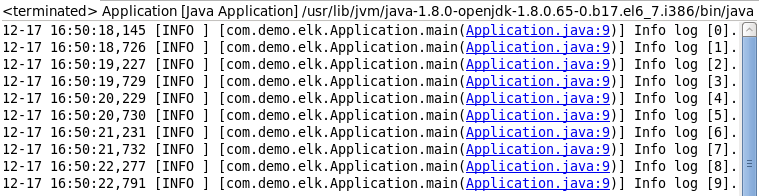
再来看看ES的head页面:
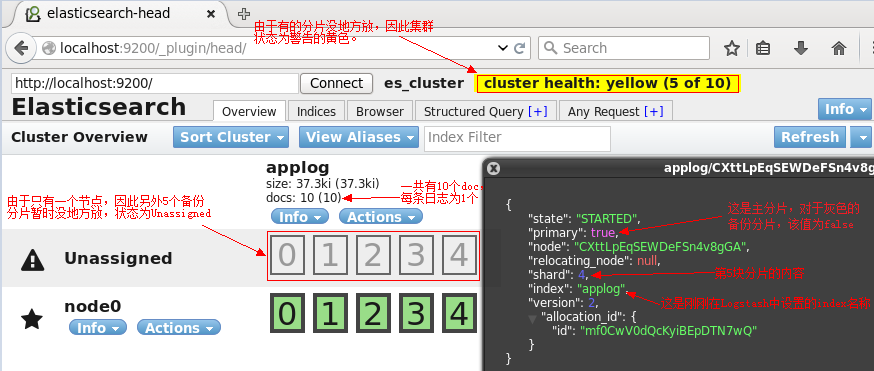
切换到Browser标签:
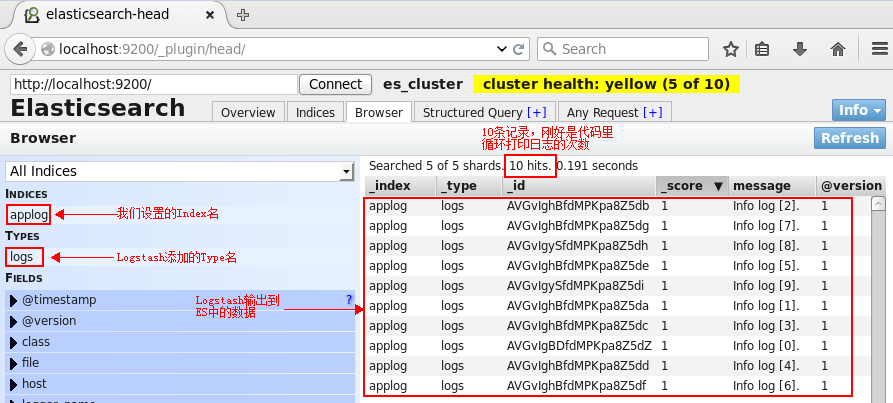
单击某一个文档(doc),则会展示该文档的所有信息:
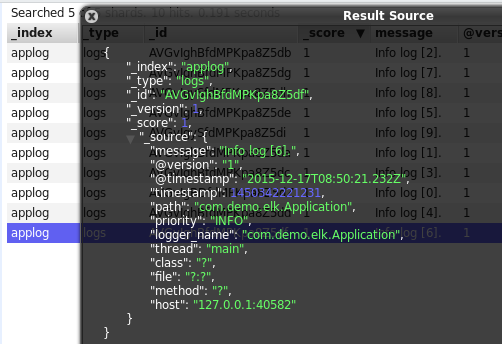
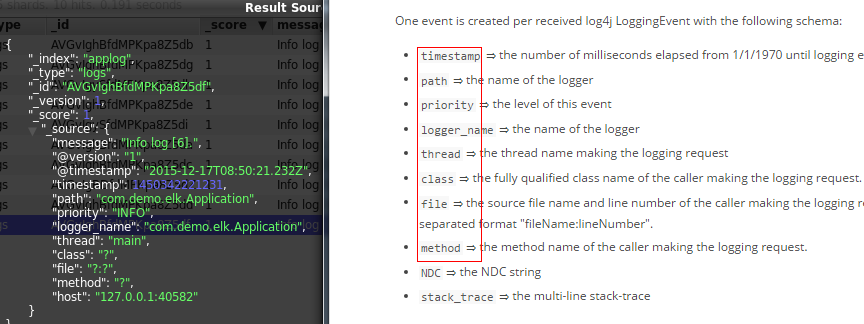
可以看到,除了基础的message字段是我们的日志内容,Logstash还为我们增加了许多字段。而在https://www.elastic.co/guide/en/logstash/current/plugins-inputs-log4j.html中也明确说明了这一点:
上面使用了ES的Head插件观察了ES集群的状态和数据,但这只是个简单的用于跟ES交互的页面而已,并不能生成报表或者图表什么的,接下来使用Kibana来执行搜索并生成图表。
Kibana
配置Kibana:
tar -zxvf kibana-4.3.0-linux-x86.tar.gz

cd kibana-4.3.0-linux-x86

vi config/kibana.yml
修改以下几项(由于是单机版的,因此host的值也可以使用localhost来代替,这里仅仅作为演示):
server.port: 5601

server.host: “centos2”

elasticsearch.url: http://centos2:9200

kibana.index: “.kibana”
启动kibana:
./bin/kibana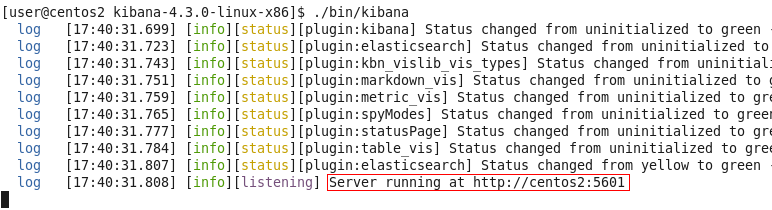
用浏览器打开该地址:
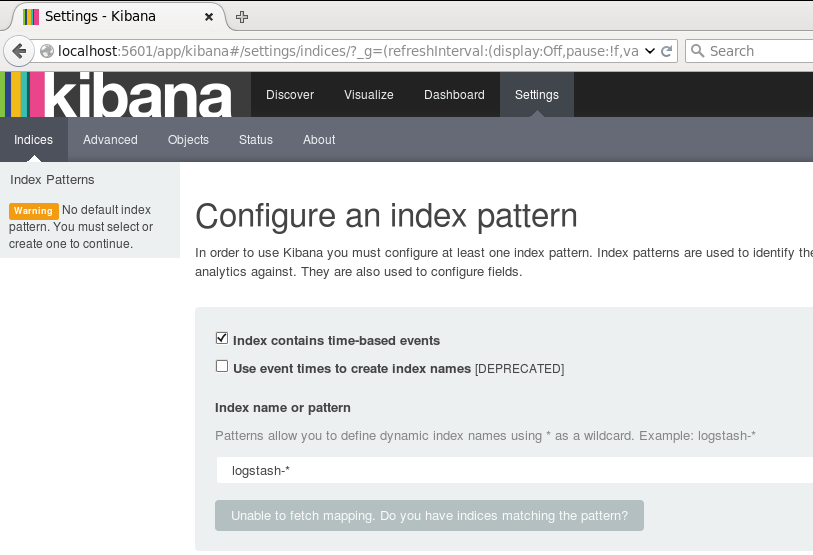
为了后续使用Kibana,需要配置至少一个Index名字或者Pattern,它用于在分析时确定ES中的Index。这里我输入之前配置的Index名字applog,Kibana会自动加载该Index下doc的field,并自动选择合适的field用于图标中的时间字段:
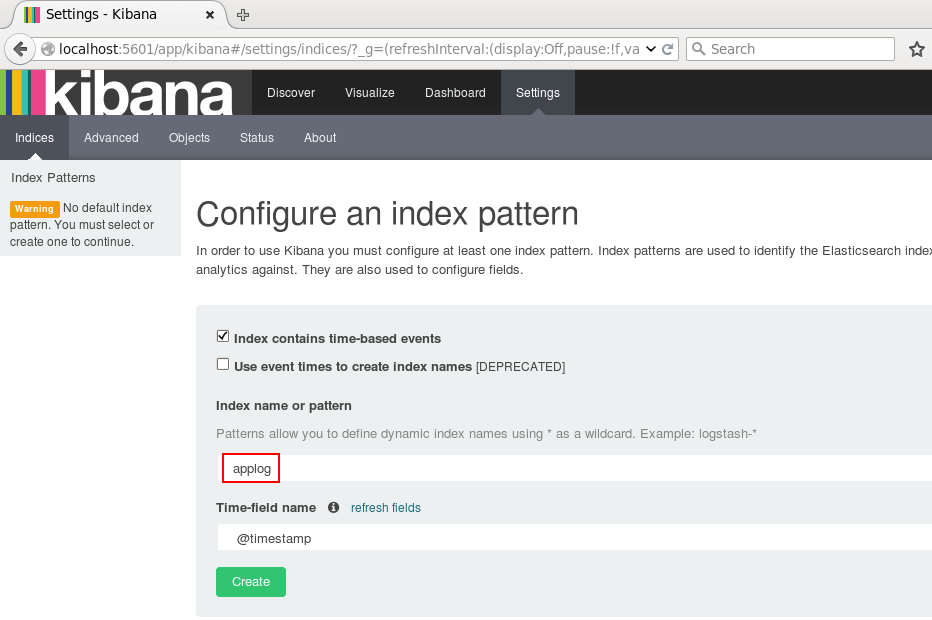
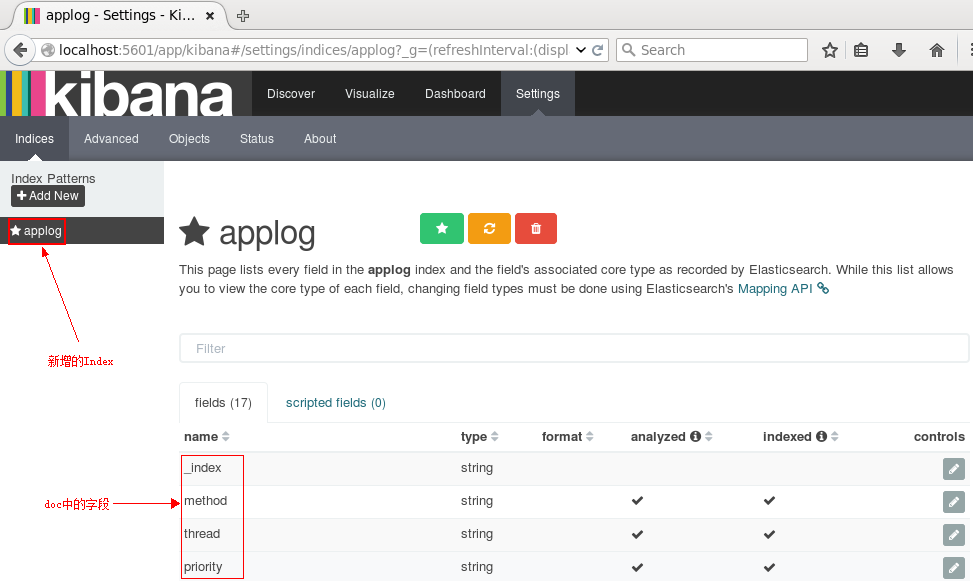
点击Create后,可以看到左侧增加了配置的Index名字:
接下来切换到Discover标签上,注意右上角是查询的时间范围,如果没有查找到数据,那么你就可能需要调整这个时间范围了,这里我选择Today:

接下来就能看到ES中的数据了:
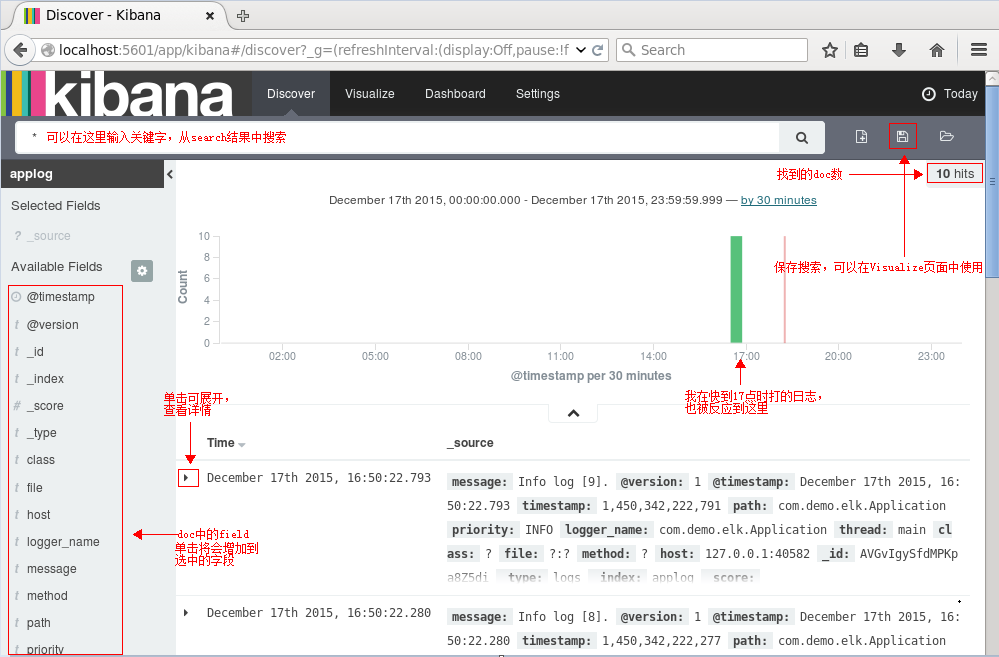
执行搜索看看呢:
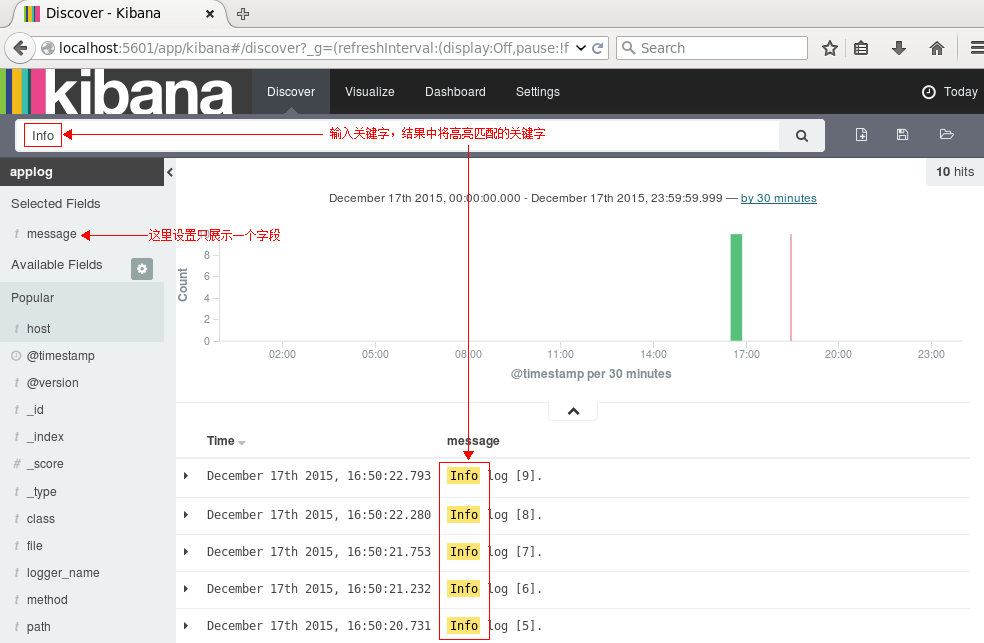
点击右边的保存按钮,保存该查询为search_all_logs。接下来去Visualize页面,点击新建一个柱状图(Vertical Bar Chart),然后选择刚刚保存的查询search_all_logs,之后,Kibana将生成类似于下图的柱状图(只有10条日志,而且是在同一时间段的,比较丑,但足可以说明问题了:) ):
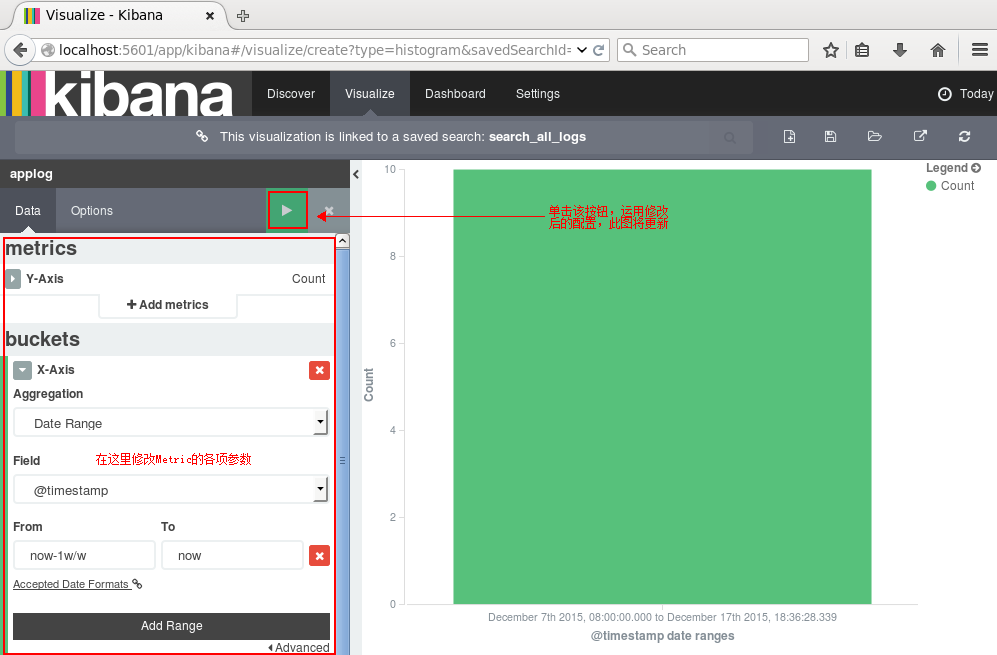
你可以在左边设置图形的各项参数,点击Apply Changes按钮,右边的图形将被更新。同理,其他类型的图形都可以实时更新。
点击右边的保存,保存此图,命名为search_all_logs_visual。接下来切换到Dashboard页面:
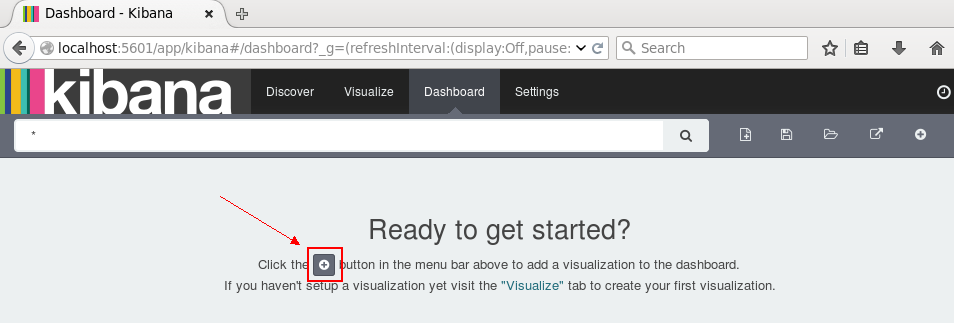
单击新建按钮,选择刚刚保存的search_all_logs_visual图形,面板上将展示该图:
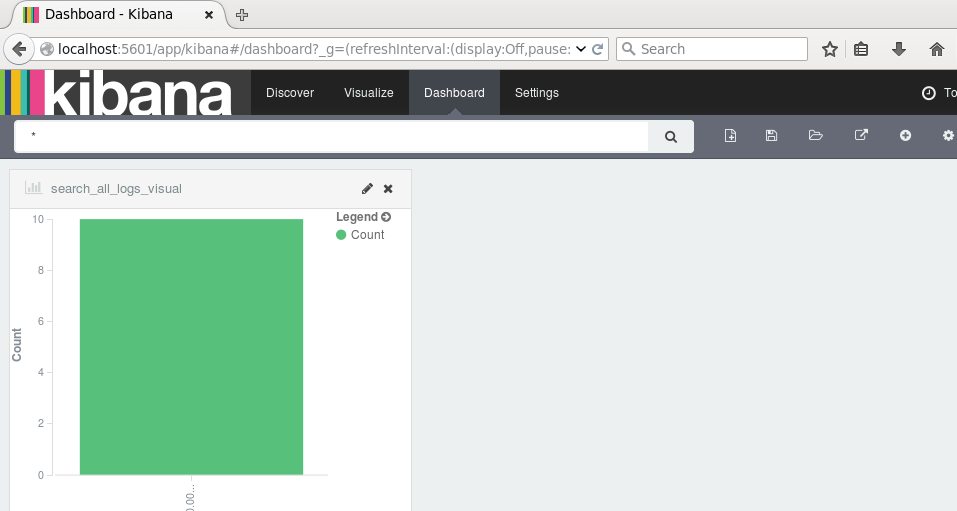
如果有较多数据,我们可以根据业务需求和关注点在Dashboard页面添加多个图表:柱形图,折线图,地图,饼图等等。当然,我们可以设置更新频率,让图表自动更新:
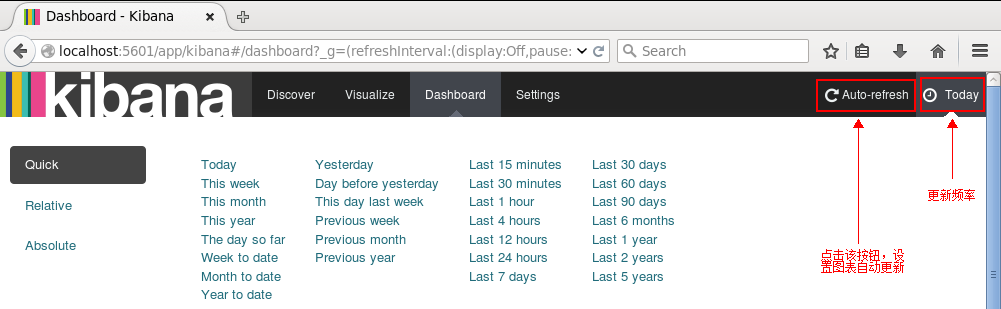
如果设置的时间间隔够短,就很趋近于实时分析了。
到这里,ELK平台部署和基本的测试已完成。
参考:
http://baidu.blog.51cto.com/71938/1676798
http://blog.csdn.net/cnweike/article/details/33736429
文章转载自https://my.oschina.net/itblog/blog/547250
ELK入门级介绍--打造实时日志查询系统的更多相关文章
- 苏宁基于Spark Streaming的实时日志分析系统实践 Spark Streaming 在数据平台日志解析功能的应用
https://mp.weixin.qq.com/s/KPTM02-ICt72_7ZdRZIHBA 苏宁基于Spark Streaming的实时日志分析系统实践 原创: AI+落地实践 AI前线 20 ...
- 用ElasticSearch,LogStash,Kibana搭建实时日志收集系统
用ElasticSearch,LogStash,Kibana搭建实时日志收集系统 介绍 这套系统,logstash负责收集处理日志文件内容存储到elasticsearch搜索引擎数据库中.kibana ...
- 阿里云 oss实时日志查询
实时日志查询 更新时间:2019-01-29 10:31:49 编辑 · 本页目录 开启实时日志查询 查询实时日志 参考文档 用户在访问 OSS 的过程中,会产生大量的访问日志.实时日志查询功能将 O ...
- Python Django项目日志查询系统
该项目适合中小型公司日志查询工作.大型公司可以使用elk等.该系统其实就是调用了absible命令去查日志,然后把输出的信息输到页面查看. 日志查询系统 维护手册 作者:陈土锋 日期:2020年6月1 ...
- 使用Fluentd + MongoDB构建实时日志收集系统
Fluentd是一个日志收集系统,它的特点在于其各部分均是可定制化的,你可以通过简单的配置,将日志收集到不同的地方. 目前开源社区已经贡献了下面一些存储插件:MongoDB, Redis, Couch ...
- centos7搭建ELK开源实时日志分析系统
Elasticsearch 是个开源分布式搜索引擎它的特点有分布式零配置自动发现索引自动分片索引副本机制 restful 风格接口多数据源自动搜索负载等. Logstash 是一个完全开源的工具他可以 ...
- 用Kibana和logstash快速搭建实时日志查询、收集与分析系统
Logstash是一个完全开源的工具,他可以对你的日志进行收集.分析,并将其存储供以后使用(如,搜索),您可以使用它.说到搜索,logstash带有一个web界面,搜索和展示所有日志. kibana ...
- ELK系列--实时日志分析系统ELK 部署与运行中的问题汇总
前记: 去年测试了ELK,今年测试了Storm,最终因为Storm需要过多开发介入而放弃,选择了ELK.感谢互联网上各路大神,目前总算是正常运行了. logstash+elasticsearch+ki ...
- Spark 实践——基于 Spark Streaming 的实时日志分析系统
本文基于<Spark 最佳实践>第6章 Spark 流式计算. 我们知道网站用户访问流量是不间断的,基于网站的访问日志,即 Web log 分析是典型的流式实时计算应用场景.比如百度统计, ...
随机推荐
- 设计模式(三)装饰者模式Decorator
装饰者模式针对的问题是:对一个结构已经确定的类,在不改变该类的结构的情况下,动态增加一些功能. 一般来说,都是对一些已经写好的架构增加自己的功能,或者应对多种情况,增加功能. 我们还是来玩一句红警,首 ...
- Ubuntu+Django+Nginx+uWSGI+Mysql搭建Python Web服务器
Ubuntu+Django+Nginx+uWSGI+Mysql搭建Python Web服务器 闲着无聊的时候部署了一个Django项目玩,用vm虚拟机部署的. 准备工作 我使用的系统是Ubuntu16 ...
- LVS集群之工作原理和调度算法(2)
LVS的工作机制 LVS里Director本身不响应请求,只是接受转发请求到后方,Realservers才是后台真正响应请求. LVS 工作原理基本类似DNAT,又不完全相像,它是一种四层交换,默 ...
- JavaScript字符串转换成数字的三种方法
在js读取文本框或者其它表单数据的时候获得的值是字符串类型的,例如两个文本框a和b,如果获得a的value值为11,b的value值为9 ,那么a.value要小于b.value,因为他们都是字符串形 ...
- vijos 1110小胖邮递员;bzoj 1210: [HNOI2004]邮递员
Description Smith在P市的邮政局工作,他每天的工作是从邮局出发,到自己所管辖的所有邮筒取信件,然后带回邮局.他所管辖的邮筒非常巧地排成了一个m*n的点阵(点阵中的间距都是相等的).左上 ...
- [51nod1684]子集价值
lyk最近在研究位运算. 它发现除了xor,or,and外还有很多运算. 它新定义了一种运算符"#". 具体地,可以由4个参数来表示. ai,j表示 i#j. 其中i,j与a的值均 ...
- BZOJ 1316: 树上的询问 (点分治+set)
题目:http://www.lydsy.com/JudgeOnline/problem.php?id=1316 因为只要求存在某条路径长度为K,所以点分,然后用set判断差值是否在set中就可以了. ...
- 2017ecjtu-summer training #2 POJ2503
...
- HDU--1213并查集
题目传送门:HDU--1213 //题意:ignatius过生日,客人来到,他想知道他需要准备多少张桌子.然而一张桌子上面只能坐上相互熟悉的人, //其中熟悉可定义成为A与B认识,B与C认识,我们就说 ...
- python列表三
>>> list1 = [123]>>> list2 =[234]>>> list1 > list2False>>> li ...