
吴裕雄--天生自然python机器学习:KNN-近邻算法在手写识别系统上的应用
需要识别的数字已经使用图形处理软件,处理成具有相同的色

彩和大小® : 宽髙是32像 素 *32像素的黑白图像。尽管采用文本格式存储图像不能有效地利用内

存空间,但是为了方便理解,我们还是将图像转换为文本格式。
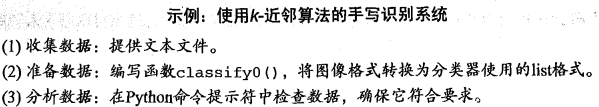
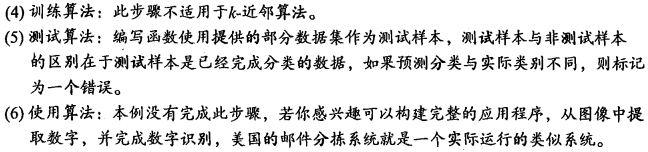
准备数据:将图像转换为测试向量
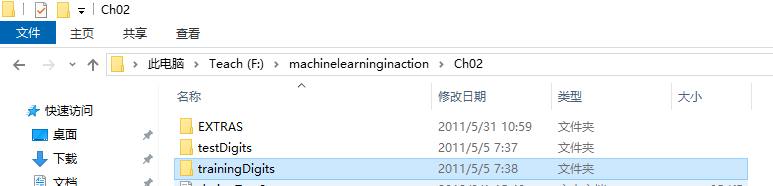
每个数字大约有200个样本;目录中包含了大约900个测试
数据。我们使用目录比testDigits的数据训练分类器,使用目录把testDigits的数据测试分类器
的效果。两组数据没有覆盖,你可以检查一下这些文件夹的文件是否符合要求。

我们将把一个32*32的二进制图像矩阵转换为1 * 1024的向量
def img2vector(filename):

    returnVect = zeros((1,1024))

    fr = open(filename)

    for i in range(32):

        lineStr = fr.readline()

        for j in range(32):

            returnVect[0,32*i+j] = int(lineStr[j])

    return returnVect
returnVect = img2vector("F:\\machinelearninginaction\\Ch02\\trainingDigits\\3_48.txt")

print(returnVect)
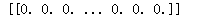
测 试 算 法 : 使 用 尽 近 邻 算 法 识 别 手 写 数 字
import numpy as np

def handwritingClassTest():

    hwLabels = []

    trainingFileList = listdir('F:\\machinelearninginaction\\Ch02\\trainingDigits')           #load the training set

    m = len(trainingFileList)

    trainingMat = np.zeros((m,1024))

    for i in range(m):

        fileNameStr = trainingFileList[i]

        fileStr = fileNameStr.split('.')[0]     #take off .txt

        classNumStr = int(fileStr.split('_')[0])

        hwLabels.append(classNumStr)

        trainingMat[i,:] = img2vector('F:\\machinelearninginaction\\Ch02\\trainingDigits\\%s' % fileNameStr)

    testFileList = listdir('F:\\machinelearninginaction\\Ch02\\testDigits')        #iterate through the test set

    mTest = len(testFileList)

    errorCount = 0.0

    for i in range(mTest):

        fileNameStr = testFileList[i]

        fileStr = fileNameStr.split('.')[0]     #take off .txt

        classNumStr = int(fileStr.split('_')[0])

        vectorUnderTest = img2vector('F:\\machinelearninginaction\\Ch02\\testDigits\\%s' % fileNameStr)

        classifierResult = classify0(vectorUnderTest, trainingMat, hwLabels, 3)

        print("the classifier came back with: %d, the real answer is: %d" % (classifierResult, classNumStr))

        if (classifierResult != classNumStr):

            errorCount += 1.0

    print("\nthe total number of errors is: %d" % errorCount)

    print("\nthe total error rate is: %f" % (errorCount/float(mTest)))

handwritingClassTest()
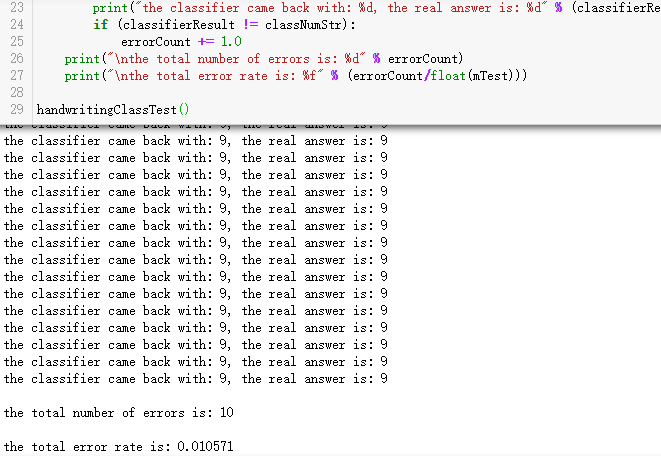
错误率大约是1.6左右,可以说是很不错的准确率了。
小结:
K-近邻算法是基于实例的学习,使用算法时我们必须有接近实际数据的训练样本数
据。A-近邻算法必须保存全部数据集,如果训练数据集的很大,必须使用大量的存储空间。此外,
由于必须对数据集中的每个数据计算距离值,实际使用时可能非常耗时。
K近邻算法的另一个缺陷是它无法给出任何数据的基础结构信息,因此我们也无法知晓平均
实例样本和典型实例样本具有什么特征。
吴裕雄--天生自然python机器学习:KNN-近邻算法在手写识别系统上的应用的更多相关文章
- 吴裕雄--天生自然python机器学习实战:K-NN算法约会网站好友喜好预测以及手写数字预测分类实验
实验设备与软件环境 硬件环境:内存ddr3 4G及以上的x86架构主机一部 系统环境:windows 软件环境:Anaconda2(64位),python3.5,jupyter 内核版本:window ...
- 吴裕雄--天生自然python机器学习:K-近邻算法介绍
k-近邻算法概述 简单地说,谷近邻算法采用测量不同特征值之间的距离方法进行分类. 优 点 :精度高.对异常值不敏感.无数据输入假定. 缺点:计算复杂度高.空间复杂度高. 适用数据范围:数值型和标称型. ...
- 吴裕雄--天生自然python机器学习:朴素贝叶斯算法
分类器有时会产生错误结果,这时可以要求分类器给出一个最优的类别猜测结果,同 时给出这个猜测的概率估计值. 概率论是许多机器学习算法的基础 在计算 特征值取某个值的概率时涉及了一些概率知识,在那里我们先 ...
- 吴裕雄--天生自然python机器学习:决策树算法
我们经常使用决策树处理分类问题’近来的调查表明决策树也是最经常使用的数据挖掘算法. 它之所以如此流行,一个很重要的原因就是使用者基本上不用了解机器学习算法,也不用深究它 是如何工作的. K-近邻算法可 ...
- 吴裕雄--天生自然python机器学习:支持向量机SVM
基于最大间隔分隔数据 import matplotlib import matplotlib.pyplot as plt from numpy import * xcord0 = [] ycord0 ...
- 吴裕雄--天生自然python机器学习:使用K-近邻算法改进约会网站的配对效果
在约会网站使用K-近邻算法 准备数据:从文本文件中解析数据 海伦收集约会数据巳经有了一段时间,她把这些数据存放在文本文件(1如1^及抓 比加 中,每 个样本数据占据一行,总共有1000行.海伦的样本主 ...
- 吴裕雄--天生自然python机器学习:机器学习简介
除却一些无关紧要的情况,人们很难直接从原始数据本身获得所需信息.例如 ,对于垃圾邮 件的检测,侦测一个单词是否存在并没有太大的作用,然而当某几个特定单词同时出现时,再辅 以考察邮件长度及其他因素,人们 ...
- 吴裕雄--天生自然python机器学习:基于支持向量机SVM的手写数字识别
from numpy import * def img2vector(filename): returnVect = zeros((1,1024)) fr = open(filename) for i ...
- 吴裕雄--天生自然python机器学习:使用Logistic回归从疝气病症预测病马的死亡率
,除了部分指标主观和难以测量外,该数据还存在一个问题,数据集中有 30%的值是缺失的.下面将首先介绍如何处理数据集中的数据缺失问题,然 后 再 利 用 Logistic回 归 和随机梯度上升算法来预测 ...
随机推荐
- IDEA控制台输出中文乱码日志文件正常
控制台中文输出乱码但输出的日志文件正常 idea.exe.vmoptions与idea64.exe.vmoptions已经配置 -Dfile.encoding=UTF-8 logback.xml中也配 ...
- settings配置数据库和日志
数据库的配置: 一.mysql配置 pip下载pymysql,用于mysql和django的连接. 在init.py上配置pymsqy. import pymysql pymysql.install_ ...
- [CQOI2016]K远点对(KD-Tree)
暴力的做法应该是这样的,维护大小为k的堆,每次插入两点间距离并弹出堆顶. 然后这个做法显然是可以KD-Tree优化的,建立KD-Tree,然后如果该平面内最远点小于堆顶,则直接退出.就当做是复习很久没 ...
- 工程日记之HelloSlide(1):Swift自定义可视化组件的方法(继承UIView和在StoryBoard中设置)
需求描述 HelloSlide是把文本自动转化成幻灯片的软件,在幻灯片中我们有SmartArt:各种各样的几何形状,并且可以自定义大小和颜色,放在幻灯片不同的位置. 为了在我们的软件中实现类似的效果, ...
- 解决: java.io.IOException: 打开的文件过多 的问题
问题 前一阵子公司项目做了一次压力测试, 中间出现了一个问题: 在50多个并发的时候会出现 java.io.IOException: 打开的文件过多 这个异常. 但是在没有并发的时候是不会出现这个问题 ...
- 实验吧web--易--后台登陆
题目地址:http://www.shiyanbar.com/ctf/2036 这道题确实有点考研脑洞了. 1.首先,查看网页源代码(Ctrl+U),会发现一段PHP代码: $sql = "S ...
- opencv python图片编码解码
cv2.imdecode()函数从指定的内存缓存中读取数据,并把数据转换(解码)成图像格式;主要用于从网络传输数据中恢复出图像.cv2.imencode()函数是将图片格式转换(编码)成流数据,赋值到 ...
- Coursera机器学习——Recommender System测验
第一题本应该是基础题,考察Cost Function不同形式的表示方法,但却难住了我,说明基本概念掌握不够到位. 1. 在求和的部分,有两种可能,一种是(i,j)同时求和,即∑(i,j):r(i,j) ...
- 17.3.10--C语言运行的步骤
编译-->生成-->调试-->链接-->运行 编译就是:将你编写的C语言程序翻译成机器能识别运行的指令集 生成就是:根据编译完成的指令集制造出机器可以具体执行的指令序列 调试就 ...
- UML-逻辑架构&包图-相关概念
1.逻辑架构 软件的宏观组织结构.含: 1).包 2).子系统 3).层 2.层 对类.包.子系统的分组(内聚).例如:mvc.在OOA/D中要重点关注核心应用逻辑(或领域)层. 3.UML包图 描述 ...