
scrapy爬虫框架入门实例(一)
流程分析
抓取内容(百度贴吧:网络爬虫吧)
页面: http://tieba.baidu.com/f?kw=%E7%BD%91%E7%BB%9C%E7%88%AC%E8%99%AB&ie=utf-8
数据:1.帖子标题;2.帖子作者;3.帖子回复数
通过观察页面html代码来帮助我们获得所需的数据内容。
一、工程建立
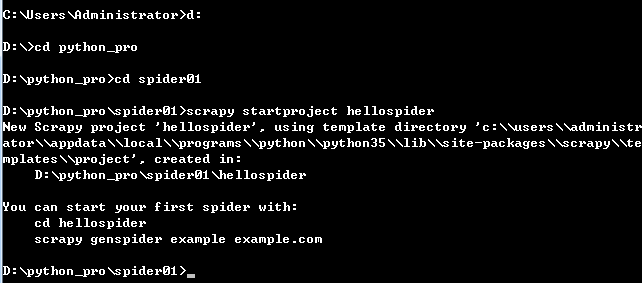
在控制台模式下进入你要建立工程的文件夹执行如下命令创建工程:

二、实现过程
1、在items.py中定义自己要抓取的数据:
import scrapy

class DetailItem(scrapy.Item):

    # 抓取内容:1.帖子标题;2.帖子作者;3.帖子回复数

    title = scrapy.Field()

    author = scrapy.Field()

    reply = scrapy.Field()
2、然后在spiders目录下编辑myspider.py那个文件:
import scrapy

from hellospider.items import DetailItem

import sys

class MySpider(scrapy.Spider):

    """

    name:scrapy唯一定位实例的属性,必须唯一

    allowed_domains:允许爬取的域名列表,不设置表示允许爬取所有

    start_urls:起始爬取列表

    start_requests:它就是从start_urls中读取链接,然后使用make_requests_from_url生成Request,

                    这就意味我们可以在start_requests方法中根据我们自己的需求往start_urls中写入

                    我们自定义的规律的链接

    parse:回调函数,处理response并返回处理后的数据和需要跟进的url

    log:打印日志信息

    closed:关闭spider

    """

    # 设置name

    name = "spidertieba"

    # 设定域名

    allowed_domains = ["baidu.com"]

    # 填写爬取地址

    start_urls = [

        "http://tieba.baidu.com/f?kw=%E7%BD%91%E7%BB%9C%E7%88%AC%E8%99%AB&ie=utf-8",

    ]

    # 编写爬取方法

    def parse(self, response):

        for line in response.xpath('//li[@class=" j_thread_list clearfix"]'):

            # 初始化item对象保存爬取的信息

            item = DetailItem()

            # 这部分是爬取部分,使用xpath的方式选择信息,具体方法根据网页结构而定

            item['title'] = line.xpath('.//div[contains(@class,"threadlist_title pull_left j_th_tit ")]/a/text()').extract()

            item['author'] = line.xpath('.//div[contains(@class,"threadlist_author pull_right")]//span[contains(@class,"frs-author-name-wrap")]/a/text()').extract()

            item['reply'] = line.xpath('.//div[contains(@class,"col2_left j_threadlist_li_left")]/span/text()').extract()

            yield item
【注】xpath语法可参考:http://www.w3school.com.cn/xpath/xpath_syntax.asp


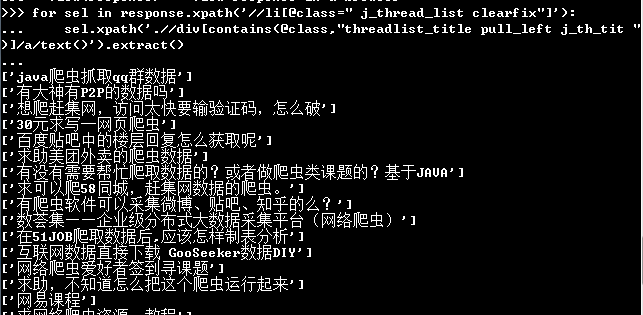
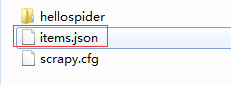
3、执行命令 scrapy crawl [类中name值]

#!/usr/bin/env python

# Version = 3.5.2

# __auth__ = '无名小妖'

import json

with open('hellospider/items.json') as f:

    rownum = 0

    new_list = json.load(f)

    for i in new_list:

        rownum += 1

        print("""line{}:  title:{},  author:{},  reply:{}.""".format(rownum,

                                                      i['title'][0],

                                                      i['author'][0],

                                                      i['reply'][0]))
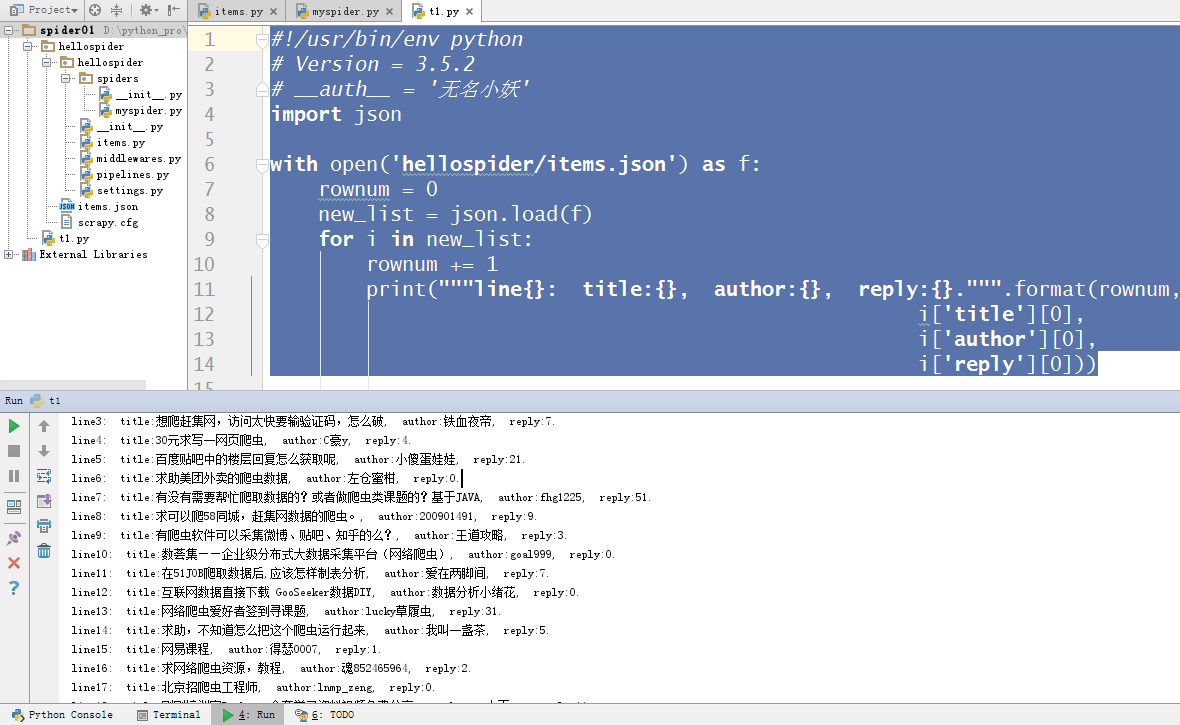
至此,scrapy的最简单的应用就完成了。
后续还会有更复杂的爬虫示例,敬请关注!
scrapy爬虫框架入门实例(一)的更多相关文章
- Python之Scrapy爬虫框架 入门实例(一)
一.开发环境 1.安装 scrapy 2.安装 python2.7 3.安装编辑器 PyCharm 二.创建scrapy项目pachong 1.在命令行输入命令:scrapy startproject ...
- Scrapy 爬虫框架入门案例详解
欢迎大家关注腾讯云技术社区-博客园官方主页,我们将持续在博客园为大家推荐技术精品文章哦~ 作者:崔庆才 Scrapy入门 本篇会通过介绍一个简单的项目,走一遍Scrapy抓取流程,通过这个过程,可以对 ...
- 【python】Scrapy爬虫框架入门
说明: 本文主要学习Scrapy框架入门,介绍如何使用Scrapy框架爬取页面信息. 项目案例:爬取腾讯招聘页面 https://hr.tencent.com/position.php?&st ...
- [Python] Scrapy爬虫框架入门
说明: 本文主要学习Scrapy框架入门,介绍如何使用Scrapy框架爬取页面信息. 项目案例:爬取腾讯招聘页面 https://hr.tencent.com/position.php?&st ...
- scrapy爬虫框架入门教程
scrapy安装请参考:安装指南. 我们将使用开放目录项目(dmoz)作为抓取的例子. 这篇入门教程将引导你完成如下任务: 创建一个新的Scrapy项目 定义提取的Item 写一个Spider用来爬行 ...
- scrapy爬虫框架入门实战
博客 https://www.jianshu.com/p/61911e00abd0 项目源码 https://github.com/ppy2790/jianshu/blob/master/jiansh ...
- Python之Scrapy爬虫框架安装及简单使用
题记:早已听闻python爬虫框架的大名.近些天学习了下其中的Scrapy爬虫框架,将自己理解的跟大家分享.有表述不当之处,望大神们斧正. 一.初窥Scrapy Scrapy是一个为了爬取网站数据,提 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影
前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大家讲解一个完整爬虫的流程. 工具和环境 语言:python 2 ...
随机推荐
- CSS第二章
1. 文本与字体属性: text-decoration:文本修饰线 none(去除修饰线).underline(下划线).overline(上划线).line-through(删除线) color: ...
- Linux系统挂载数据盘
参考:http://help.aliyun.com/knowledge_detail/5974154.html?spm=5176.788314850.3.2.hUqwXo 1.在阿里云上购买了服务器, ...
- Ejabberd 插件开发 --- IQ截获与处理
ejabberd的组件开发其实是非常简单的,只要遵循其gen_mod规范,添加iq处理函数就可以了.下面一步步教大家如何开发ejabberd组件. 首先,最好是自己编译ejabberd源码,这样的话把 ...
- Python-8 元组tuple
#1 特殊的列表:元组 元组中的元素不可改变 #2 创建.访问 >>> tuple1=(1,2,3) >>> tuple1=1,2,3 >>> t ...
- 在SQL2008配置数据库镜像1418错误的处理
在SQL2008配置数据库镜像错误一般都由以下原因造成 1.主体.镜像服务器SQL SERVER选择本账号切保持一致 2.在数据库镜像配置向导中的“服务账号”选项中请选择需要同步数据库的登陆名,例如数 ...
- hibernate复合主键
需要用到实体类Role的主键和Menu的主键结合起来作为实体类RoleMenu的主键,那么通过Hibernate具体实现如下: RoleMenu实体类:(注意该实体类需要实现Serializable接 ...
- MySQL 对于千万级的大表要怎么优化?
作者:哈哈链接:https://www.zhihu.com/question/19719997/answer/81930332来源:知乎著作权归作者所有,转载请联系作者获得授权. 第一优化你的sql和 ...
- arcgis将图片转成shp地图
打开arcMap 1.右键[图层]-[属性]-[坐标系]-[地理坐标系]-双击"WGS 1984" 2.右键[图层]-[添加数据],打开图片文件-Band_2 3.右键图片-[属性 ...
- HTML的FormData对象
FormData是HTML5标准制定的一个新的封装对象,有了FormData对象,可以方便地通过javascript创建表单数据,直接以ajax发送到服务器中. 目前浏览器的支持情况为: 详细的介绍与 ...
- CountDownLatch如何使用
正如每个Java文档所描述的那样,CountDownLatch是一个同步工具类,它允许一个或多个线程一直等待,直到其他线程的操作执行完后再执行.在Java并发中,countdownlatch的概念是一 ...