
Python爬虫根据关键词爬取知网论文摘要并保存到数据库中【入门必学】
前言
本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
作者:崩坏的芝麻

由于实验室需要一些语料做研究,语料要求是知网上的论文摘要,但是目前最新版的知网爬起来有些麻烦,所以我利用的是知网的另外一个搜索接口
比如下面这个网页:
http://search.cnki.net/Search.aspx?q=肉制品
搜索出来的结果和知网上的结果几乎一样,另外以后面试找Python工作,项目经验展示是核心,如果你缺项目练习,去小编的Python交流.裙 :一久武其而而流一思(数字的谐音)转换下可以找到了,里面很多新教程项目
在这个基础上,我简单看了些网页的结构,很容易就能写出爬取得代码(是最基础的,相当不完善,增加其他功能可自行增加)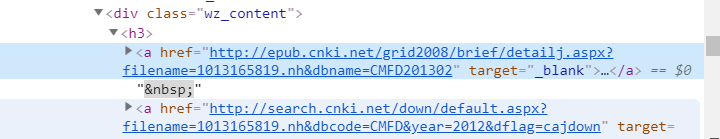
网页的结构还是很清晰的
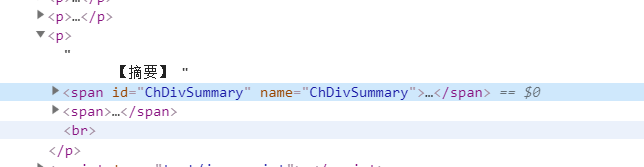
摘要信息也很清晰
我使用的是 pymysql 连接的数据库,效率也还可以
下面直接贴代码:
# -*- coding: utf-8 -*-

import time

import re

import random

import requests

from bs4 import BeautifulSoup

import pymysql

connection = pymysql.connect(host='',

                             user='',

                             password='',

                             db='',

                             port=3306,

                             charset='utf8')  # 注意是utf8不是utf-8

# 获取游标

cursor = connection.cursor()

#url = 'http://epub.cnki.net/grid2008/brief/detailj.aspx?filename=RLGY201806014&dbname=CJFDLAST2018'

#这个headers信息必须包含,否则该网站会将你的请求重定向到其它页面

headers = {

    'Accept':'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',

    'Accept-Encoding':'gzip, deflate, sdch',

    'Accept-Language':'zh-CN,zh;q=0.8',

    'Connection':'keep-alive',

    'Host':'www.cnki.net',

    'Referer':'http://search.cnki.net/search.aspx?q=%E4%BD%9C%E8%80%85%E5%8D%95%E4%BD%8D%3a%E6%AD%A6%E6%B1%89%E5%A4%A7%E5%AD%A6&rank=relevant&cluster=zyk&val=CDFDTOTAL',

    'Upgrade-Insecure-Requests':'1',

    'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'

}

headers1 = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.143 Safari/537.36'

    }

def get_url_list(start_url):

    depth = 20

    url_list = []

    for i in range(depth):

        try:

            url = start_url + "&p=" + str(i * 15)

            search = requests.get(url.replace('\n', ''), headers=headers1)

            soup = BeautifulSoup(search.text, 'html.parser')

            for art in soup.find_all('div', class_='wz_tab'):

                print(art.find('a')['href'])

                if art.find('a')['href'] not in url_list:

                    url_list.append(art.find('a')['href'])

            print("爬取第" + str(i) + "页成功!")

            time.sleep(random.randint(1, 3))

        except:

            print("爬取第" + str(i) + "页失败!")

    return url_list

def get_data(url_list, wordType):

    try:

        # 通过url_results.txt读取链接进行访问

        for url in url_list:

            i = 1;

            if url == pymysql.NULL or url == '':

                continue

            try:

                html = requests.get(url.replace('\n', ''), headers=headers)

                soup = BeautifulSoup(html.text, 'html.parser')

            except:

                print("获取网页失败")

            try:

                print(url)

                if soup is None:

                    continue

                # 获取标题

                title = soup.find('title').get_text().split('-')[0]

                # 获取作者

                author = ''

                for a in soup.find('div', class_='summary pad10').find('p').find_all('a', class_='KnowledgeNetLink'):

                    author += (a.get_text() + ' ')

                # 获取摘要

                abstract = soup.find('span', id='ChDivSummary').get_text()

                # 获取关键词,存在没有关键词的情况

            except:

                print("部分获取失败")

                pass

            try:

                key = ''

                for k in soup.find('span', id='ChDivKeyWord').find_all('a', class_='KnowledgeNetLink'):

                    key += (k.get_text() + ' ')

            except:

                pass

            print("第" + str(i) + "个url")

            print("【Title】:" + title)

            print("【author】:" + author)

            print("【abstract】:" + abstract)

            print("【key】:" + key)

            # 执行SQL语句

            cursor.execute('INSERT INTO cnki VALUES (NULL, %s, %s, %s, %s, %s)', (wordType, title, author, abstract, key))

            # 提交到数据库执行

            connection.commit()

            print()

        print("爬取完毕")

    finally:

        print()

if __name__ == '__main__':

    try:

        for wordType in {"大肠杆菌", "菌群总落", "胭脂红", "日落黄"}:

            wordType = "肉+" + wordType

            start_url = "http://search.cnki.net/search.aspx?q=%s&rank=relevant&cluster=zyk&val=" % wordType

            url_list = get_url_list(start_url)

            print("开始爬取")

            get_data(url_list, wordType)

            print("一种类型爬取完毕")

        print("全部爬取完毕")

    finally:

        connection.close()
在这里的关键词我简单的选了几个,作为实验,如果爬取的很多,可以写在txt文件里,直接读取就可以,非常方便。
Python爬虫根据关键词爬取知网论文摘要并保存到数据库中【入门必学】的更多相关文章
- 芝麻HTTP:Python爬虫实战之抓取爱问知识人问题并保存至数据库
本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表达式的简 ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- Python爬虫实战之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 对百度贴吧的任意帖子进行抓取 指定是否只抓取楼主发帖 ...
- Python爬取招聘信息,并且存储到MySQL数据库中
前面一篇文章主要讲述,如何通过Python爬取招聘信息,且爬取的日期为前一天的,同时将爬取的内容保存到数据库中:这篇文章主要讲述如何将python文件压缩成exe可执行文件,供后面的操作. 这系列文章 ...
- 基于webmagic的爬虫小应用--爬取知乎用户信息
听到“爬虫”,是不是第一时间想到Python/php ? 多少想玩爬虫的Java学习者就因为语言不通而止步.Java是真的不能做爬虫吗? 当然不是. 只不过python的3行代码能解决的问题,而Jav ...
随机推荐
- java本地缓存
1.为什么要使用缓存 由于服务器.数据库.网络等资源有限,无法支撑越来越多的请求与计算量,所以将一部分数据放在缓存中,以此减小薄弱环节的计算量和请求流程. 网站中缓存的应用场景: 1:可 ...
- SpringBoot 整合jdbc和mybatis
摘要 该文章主要为记录如何在SpringBoot项目中整合JDBC和MyBatis,在整合中我会使用简单的用法和测试用例,毕竟该文章目的是为了整合,而不是教大家如何去使用.希望大家多多包涵. 通用配置 ...
- 如何查看当前linux服务器是否支持虚拟化
[root@localhost ~]# grep -E '(svm|vmx)' /proc/cpuinfo 或者: [root@localhost ~]# cat /proc/cpuinfo 找到fl ...
- VS链接文件设置
右键点击文件夹,添加现有项,选中文件,添加为链接 ,点击确定,那么在修改源文件后这个目录的文件也会同步修改.如果更改源文件目录,就需要重新指定一次链接.
- 【Java】final修饰符的使用
final修饰符的使用 1.修饰类: final修饰的类不能被继承,final修饰的类里面的方法都是(隐式)final方法 2.修饰方法: final修饰的方法不能被重写 3.修饰变量(被修饰的变量一 ...
- C语言|博客作业03
这个作业属于哪个课程 C程序语言设计 这个作业要求在哪里 https://edu.cnblogs.com/campus/zswxy/CST2019-1/homework/8654 我在这个课程的目标是 ...
- C语言博客I作业09
提问 回答 这个作业属于哪个课程 C语言程序设计Ⅱ 这个作业要求在哪里 https://www.cnblogs.com/sanying/p/11907721.html 我在这个课程的目标 掌握语句嵌套 ...
- [apue] FIFO:不是文件的文件
众所周知,FIFO中文译为命名管道,是PIPE的升级版.而PIPE是管道,系统提供的一种进程间通讯方式,FIFO与PIPE有以下方面不同: 1) FIFO需要先在文件系统创建(mkfifo),之后使用 ...
- 官方宣布IPV4已然耗尽,IPv6D风口或将到来?
急救箱 IPV4真的用完了吗? IPV4真的用完了吗?其实 小兰 一点也不惊讶 ,毕竟全球人口这么多,多N的几次幂就用完了吧- 43亿个IPv4地址已分配完毕,这意味着没已经有更多的IPv4地址可 ...
- 【论文阅读】Diverse Image-to-Image Translation via Disentangled Representations(ECCV2018 oral)
目录 相关链接 方法亮点 相关工作 方法细节 实验结果 总结与收获 参考文献 相关链接: 论文:https://arxiv.org/abs/1808.00948 代码:https://github.c ...