
SparkStreaming消费Kafka,手动维护Offset到Mysql
说明
当前处理只实现手动维护offset到mysql,只能保证数据不丢失,可能会重复
要想实现精准一次性,还需要将数据提交和offset提交维护在一个事务中
官网说明
Your own data store

For data stores that support transactions, saving offsets in the same transaction as the results can keep the two in sync, even in failure situations. If you’re careful about detecting repeated or skipped offset ranges, rolling back the transaction prevents duplicated or lost messages from affecting results. This gives the equivalent of exactly-once semantics. It is also possible to use this tactic even for outputs that result from aggregations, which are typically hard to make idempotent.

您自己的数据存储

对于支持事务的数据存储,即使在失败情况下,将偏移与结果保存在同一事务中也可以使两者保持同步。 如果您在检测重复或跳过的偏移量范围时很谨慎,则回滚事务可防止重复或丢失的消息影响结果。 这相当于一次语义。 即使是由于聚合而产生的输出(通常很难使等幂),也可以使用此策略。
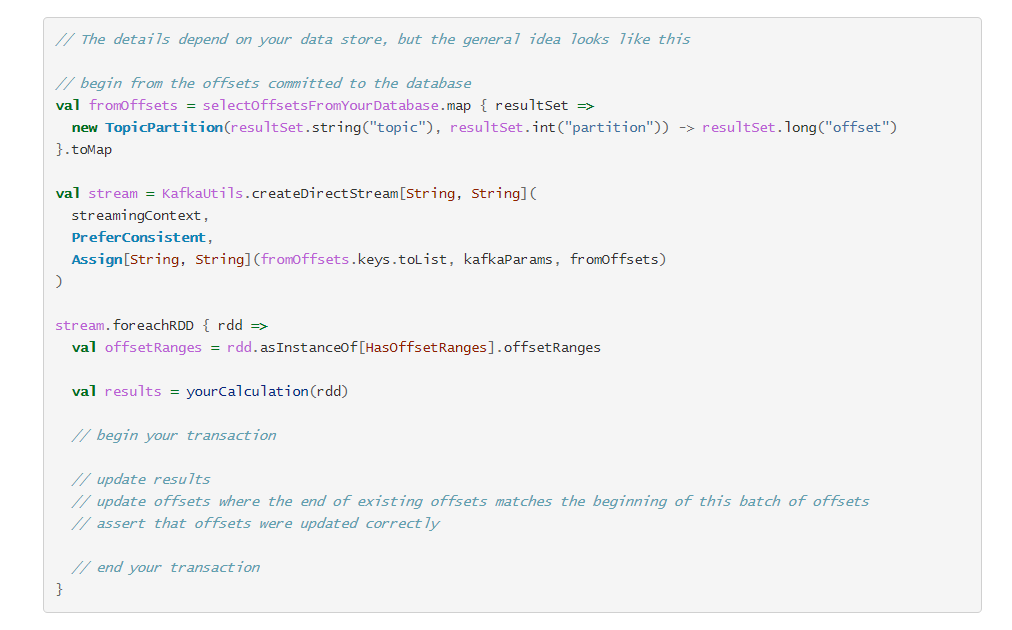
整体逻辑
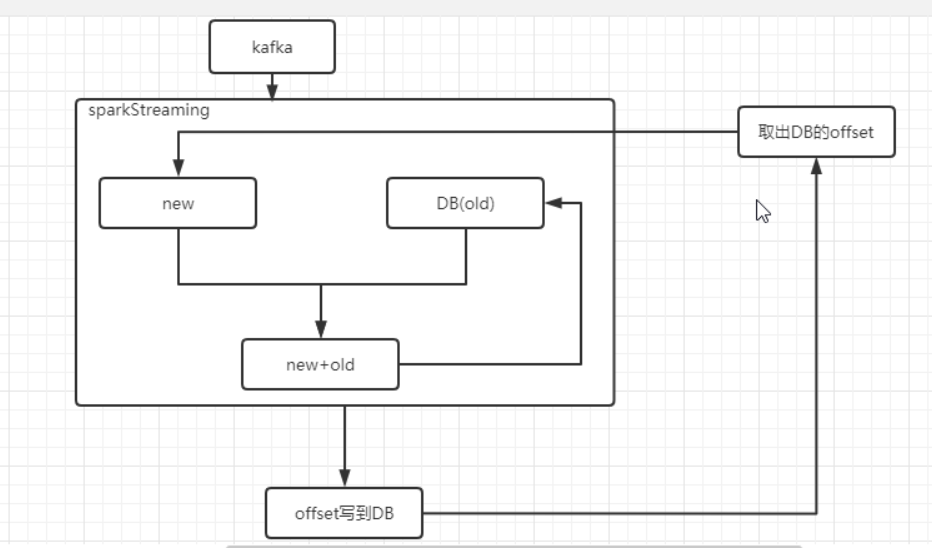
offset建表语句
CREATE TABLE `offset_manager` (

  `groupid` varchar(50) DEFAULT NULL,

  `topic` varchar(50) DEFAULT NULL,

  `partition` int(11) DEFAULT NULL,

  `untiloffset` mediumtext,

  UNIQUE KEY `offset_unique` (`groupid`,`topic`,`partition`)

) ENGINE=InnoDB DEFAULT CHARSET=latin1
代码实现
在线教育:知识点实时统计
import java.sql.{Connection, ResultSet}

import com.atguigu.qzpoint.util.{DataSourceUtil, QueryCallback, SqlProxy}

import org.apache.kafka.clients.consumer.ConsumerRecord

import org.apache.kafka.common.TopicPartition

import org.apache.kafka.common.serialization.StringDeserializer

import org.apache.spark.streaming.dstream.InputDStream

import org.apache.spark.streaming.kafka010.{ConsumerStrategies, HasOffsetRanges, KafkaUtils, LocationStrategies, OffsetRange}

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.SparkConf

import scala.collection.mutable

/**

 * @description: 知识点掌握实时统计

 * @author: HaoWu

 * @create: 2020年10月13日

 */

object QzPointStreaming_V2 {

  val groupid = "test1"

  def main(args: Array[String]): Unit = {

    /**

     * 初始化ssc

     */

    val conf: SparkConf = new SparkConf()

      .setAppName("test1")

      .setMaster("local[*]")

      .set("spark.streaming.kafka.maxRatePerPartition", "100")

      .set("spark.streaming.backpressure.enabled", "true")

    val ssc = new StreamingContext(conf, Seconds(3))

    /**

     * 读取mysql历史的offset

     */

    val sqlProxy = new SqlProxy()

    val client: Connection = DataSourceUtil.getConnection

    val offsetMap = new mutable.HashMap[TopicPartition, Long]

    try {

      sqlProxy.executeQuery(client, "select * from `offset_manager` where groupid=?", Array(groupid), new QueryCallback {

        override def process(rs: ResultSet): Unit = {

          while (rs.next()) {

            val model = new TopicPartition(rs.getString(2), rs.getInt(3))

            val offset = rs.getLong(4)

            offsetMap.put(model, offset)

          }

          rs.close()

        }

      })

    } catch {

      case e: Exception => e.printStackTrace()

    } finally {

      sqlProxy.shutdown(client)

    }

    /**

     * 消费kafka主题,获取数据流

     */

    val topics = Array("qz_log")

    val kafkaMap: Map[String, Object] = Map[String, Object](

      "bootstrap.servers" -> "hadoop102:9092,hadoop103:9092,hadoop104:9092",

      "key.deserializer" -> classOf[StringDeserializer],

      "value.deserializer" -> classOf[StringDeserializer],

      "group.id" -> groupid,

      "auto.offset.reset" -> "earliest",

      //手动维护offset,要设置为false

      "enable.auto.commit" -> (false: Boolean)

    )

    val inStream: InputDStream[ConsumerRecord[String, String]] = if (offsetMap.isEmpty) {

      //第一次启动程序消费

      KafkaUtils.createDirectStream(

        ssc, LocationStrategies.PreferConsistent, ConsumerStrategies.Subscribe[String, String](topics, kafkaMap))

    } else {

      //程序挂了,恢复程序

      KafkaUtils.createDirectStream(

        ssc, LocationStrategies.PreferConsistent, ConsumerStrategies.Subscribe[String, String](topics, kafkaMap, offsetMap))

    }

    //*************************************************处理逻辑 开始**********************************************//

    /**

     * 逻辑处理的套路:统计当前批 + DB中历史的数据  => 更新DB中的表数据

     */

    inStream

      .filter(

        record => record.value().split("\t") == 6

      )

    //*************************************************处理逻辑 结束**********************************************//

    /**

     * 逻辑处理完后,更新 mysql中维护的offset

     */

    inStream.foreachRDD(rdd => {

      val sqlProxy = new SqlProxy()

      val client = DataSourceUtil.getConnection

      try {

        val offsetRanges: Array[OffsetRange] = rdd.asInstanceOf[HasOffsetRanges].offsetRanges

        for (or <- offsetRanges) {

          sqlProxy.executeUpdate(client, "replace into `offset_manager` (groupid,topic,`partition`,untilOffset) values(?,?,?,?)",

            Array(groupid, or.topic, or.partition.toString, or.untilOffset))

        }

        /*for (i <- 0 until 100000) {

          val model = new LearnModel(1, 1, 1, 1, 1, 1, "", 2, 1l, 1l, 1, 1)

          map.put(UUID.randomUUID().toString, model)

        }*/

      } catch {

        case e: Exception => e.printStackTrace()

      } finally {

        sqlProxy.shutdown(client)

      }

    })

    //启动

    ssc.start()

    //阻塞

    ssc.awaitTermination()

  }

}
SparkStreaming消费Kafka,手动维护Offset到Mysql的更多相关文章
- spark streaming读取kakfka数据手动维护offset
在spark streaming读取kafka的数据中,spark streaming提供了两个接口读取kafka中的数据,分别是KafkaUtils.createDstream,KafkaUtils ...
- Spark Streaming消费Kafka Direct保存offset到Redis,实现数据零丢失和exactly once
一.概述 上次写这篇文章文章的时候,Spark还是1.x,kafka还是0.8x版本,转眼间spark到了2.x,kafka也到了2.x,存储offset的方式也发生了改变,笔者根据上篇文章和网上文章 ...
- SparkStreaming消费kafka中数据的方式
有两种:Direct直连方式.Receiver方式 1.Receiver方式: 使用kafka高层次的consumer API来实现,receiver从kafka中获取的数据都保存在spark exc ...
- kafka手动设置offset
项目中经常有需求不是消费kafka队列全部的数据,取区间数据 查询kafka最大的offset: ./kafka-run-class.sh kafka.tools.GetOffsetShell --b ...
- Spring-Kafka —— 实现批量消费和手动提交offset
spring-kafka的官方文档介绍,可以知道自1.1版本之后, @KafkaListener开始支持批量消费,只需要设置batchListener参数为true 把application.yml中 ...
- sparkstreaming消费kafka后bulk到es
不使用es-hadoop的saveToES,与scala版本冲突问题太多.不使用bulkprocessor,异步提交,es容易oom,速度反而不快.使用BulkRequestBuilder同步提交. ...
- 使用spark-streaming实时读取Kafka数据统计结果存入MySQL
在这篇文章里,我们模拟了一个场景,实时分析订单数据,统计实时收益. 场景模拟 我试图覆盖工程上最为常用的一个场景: 1)首先,向Kafka里实时的写入订单数据,JSON格式,包含订单ID-订单类型-订 ...
- 17-Flink消费Kafka写入Mysql
戳更多文章: 1-Flink入门 2-本地环境搭建&构建第一个Flink应用 3-DataSet API 4-DataSteam API 5-集群部署 6-分布式缓存 7-重启策略 8-Fli ...
- SparkStreaming与Kafka,SparkStreaming接收Kafka数据的两种方式
SparkStreaming接收Kafka数据的两种方式 SparkStreaming接收数据原理 一.SparkStreaming + Kafka Receiver模式 二.SparkStreami ...
随机推荐
- 双栈排序 牛客网 程序员面试金典 C++ Python
双栈排序 牛客网 程序员面试金典 C++ Python 题目描述 请编写一个程序,按升序对栈进行排序(即最大元素位于栈顶),要求最多只能使用一个额外的栈存放临时数据,但不得将元素复制到别的数据结构中. ...
- gas-station leetcode C++
There are N gas stations along a circular route, where the amount of gas at station i isgas[i]. You ...
- AtCoder Beginner Contest 215 F题题解
F - Dist Max 2 什么时候我才能突破\(F\)题的大关... 算了,不说了,看题. 简化题意:给定\(n\)个点的坐标,定义没两个点的距离为\(min(|x_i-x_j|,|y_i-y_j ...
- SpringMVC配置版到注解版
什么是springmvc? 1.1.什么是MVC MVC是模型(Model).视图(View).控制器(Controller)的简写,是一种软件设计规范. 是将业务逻辑.数据.显示分离的方法来组织代码 ...
- 一、spring 环境搭建
一.springtoolSuite4下载 1.概述 Spring Tools 4 是适用于您最喜欢的编码环境的下一代 Spring 工具.它主要从头开始重建,为开发基于 Spring 的企业应用程序提 ...
- msfsploit框架的使用——ms17_010漏洞的利用
开门见山,首先输入msfconsole打开msf控制台 全球最牛逼的渗透测试框架就是长这个样子(每次打开时,显示的图案都不一样) 然后搜索ms17_010的相关模块,得到了六条结果,我们需要用的是编号 ...
- 【JavaSE】格式化输出
Java格式化输出 2019-07-06 11:35:55 by冲冲 1. 输出字符串 %s 1 /*** 输出字符串 ***/ 2 // %s表示输出字符串,也就是将后面的字符串替换模式中的%s ...
- Orika - 类复制工具
Orika 前言 类复制工具有很多,比较常用的有 mapstruct.Spring BeanUtils.Apache BeanUtils.dozer 等,目前我所在的项目组中使用的是 mapstruc ...
- 联盛德 HLK-W806 (一): Ubuntu20.04下的开发环境配置, 编译和烧录说明
目录 联盛德 HLK-W806 (一): Ubuntu20.04下的开发环境配置, 编译和烧录说明 联盛德 HLK-W806 (二): Win10下的开发环境配置, 编译和烧录说明 联盛德 HLK-W ...
- 联盛德 HLK-W806 (二): Win10下的开发环境配置, 编译和烧录说明
目录 联盛德 HLK-W806 (一): Ubuntu20.04下的开发环境配置, 编译和烧录说明 联盛德 HLK-W806 (二): Win10下的开发环境配置, 编译和烧录说明 联盛德 HLK-W ...