
Tkinter 之爬虫框架项目实战
一、效果图
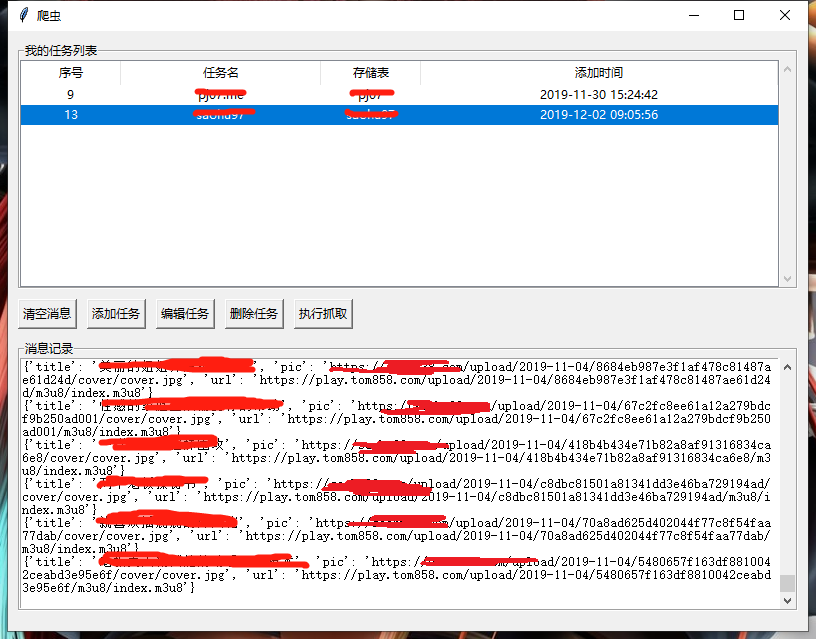
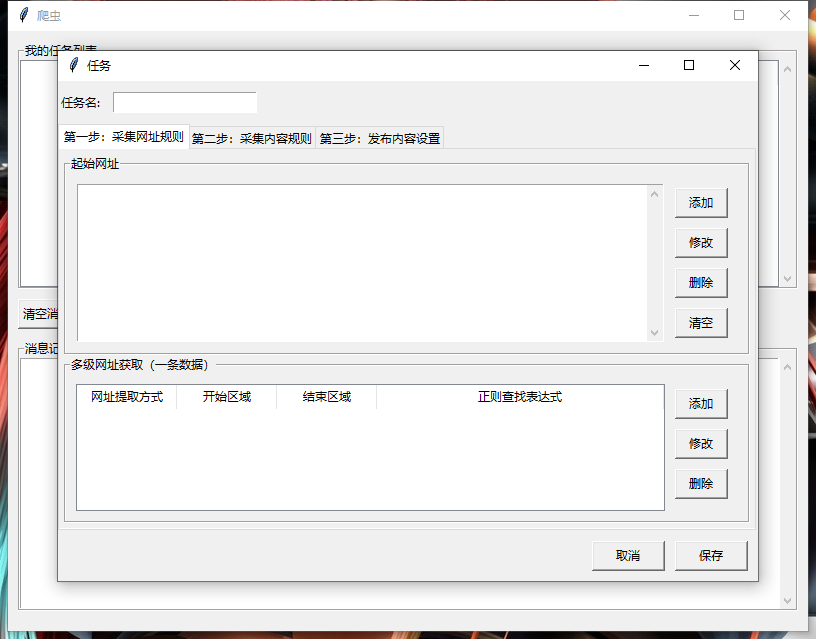
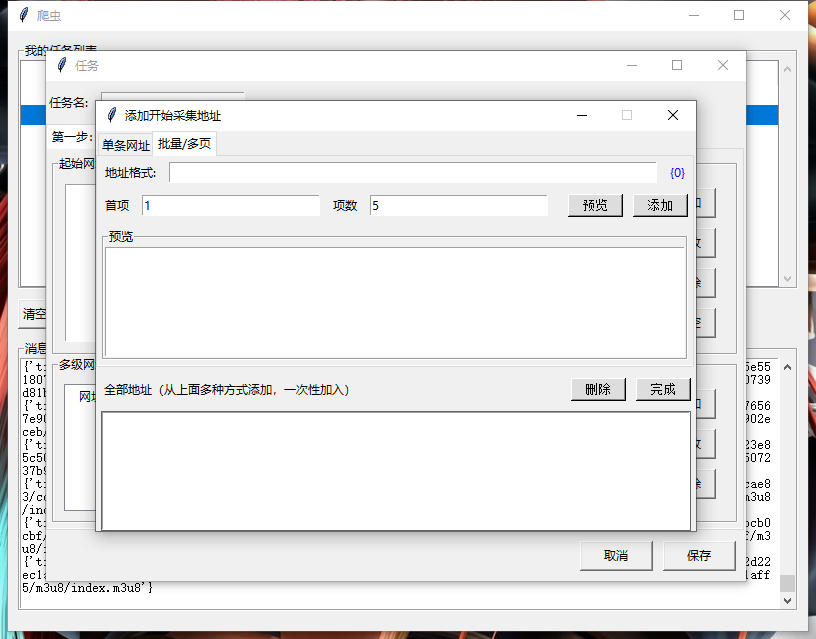
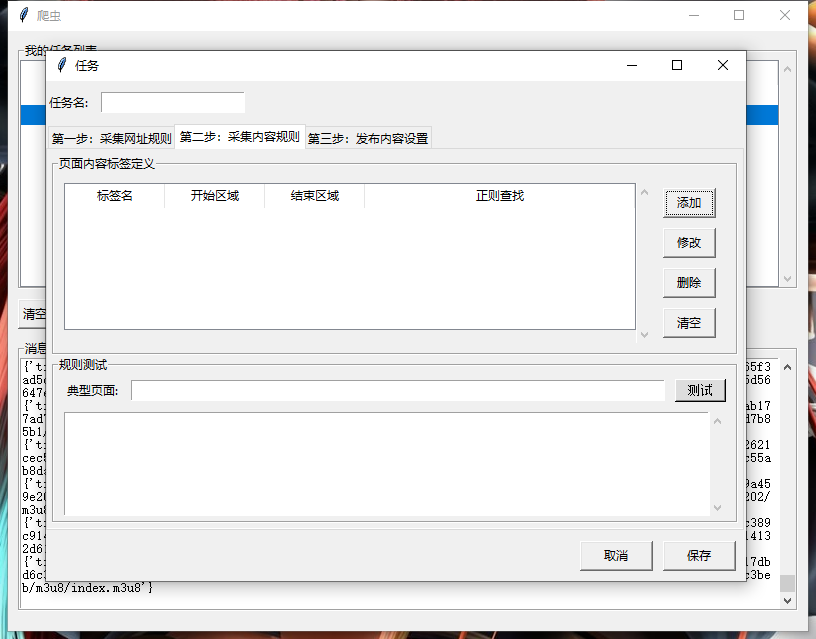
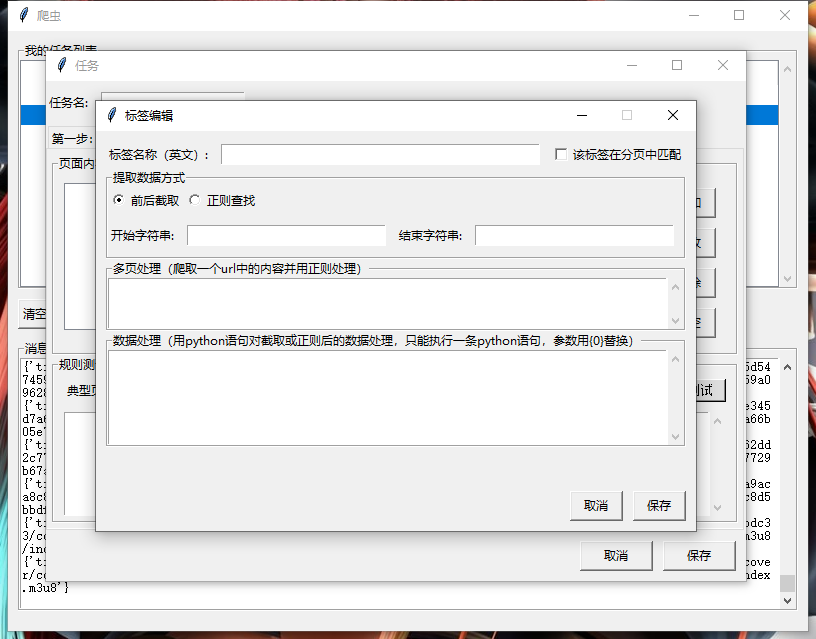
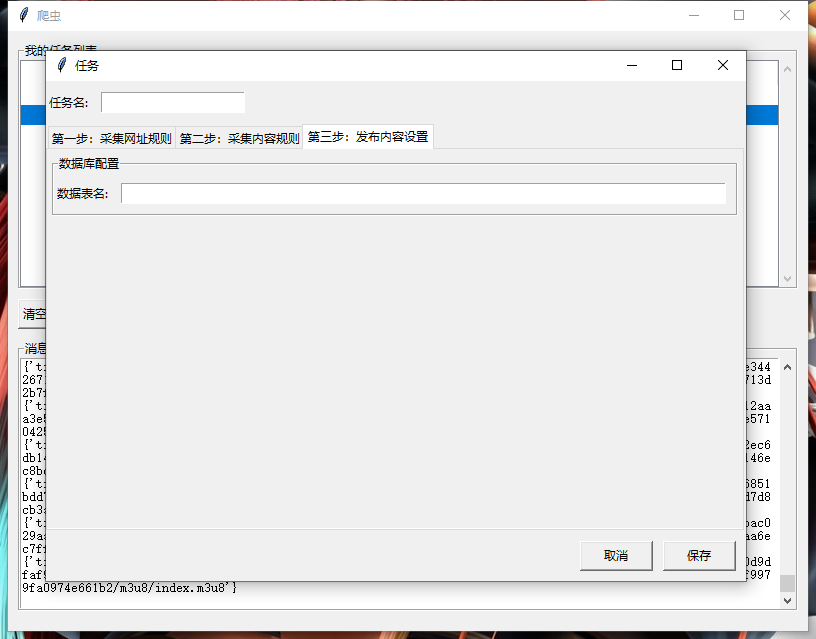
二、源码
    ''' 测试内容页爬取'''

    def test_content_url(self):

        try:

            url = self.test_url_var.get().strip()

            items = self.content_tree.get_children('')

            content = self.get_html(url)

            content_dict = {}

            self.test_text.delete(1.0, END)

            for item in items:

                value = self.content_tree.item(item).get('values')

                if value[4] == 0:

                    print(value)

                    if value[5] == 0:

                        # substring

                        return_value = self.deal_with_sustring(content, value[1], value[2])

                        if value[6]:

                            return_value = self.request_again(url, return_value, value[6])

                        if value[7]:

                            exec_content = value[7].format(return_value)

                            return_value = self.deal_with_python(exec_content)

                            return_value =  self.c

                        content_dict[value[0]] = return_value

                        self.test_text.insert(END, value[0] + ': ' + return_value + '\n')

                    else:

                        # re

                        pattern = re.findall(value[3], content, re.I|re.M)

                        if pattern:

                            pattern_value = pattern[0]

                        else:

                            pattern_value = ''

                        if value[6]:

                            pattern_value = self.request_again(url, pattern_value, value[6])

                        if value[7]:

                            exec_content = value[7].format(pattern_value)

                            return_value = self.deal_with_python(exec_content)

                        self.test_text.insert(END, value[0] + ': ' + pattern_value + '\n')

                        content_dict[value[0]] = pattern_value

                else:

                    print('%s在列表页提取' % value[0])

            print(content_dict)

        except Exception as e:

            print(e)

            self.test_text.insert(END, '错误信息:' + str(e))
有需要源码的可以评论哦~
Tkinter 之爬虫框架项目实战的更多相关文章
- Python爬虫教程-32-Scrapy 爬虫框架项目 Settings.py 介绍
本篇介绍项目开发的过程中,对 Setting 文件的配置和使用 Python爬虫教程-32-Scrapy 爬虫框架项目 Settings.py 介绍 settings.py 文件的使用 想要详细查看 ...
- Python爬虫教程-31-创建 Scrapy 爬虫框架项目
本篇是介绍在 Anaconda 环境下,创建 Scrapy 爬虫框架项目的步骤,且介绍比较详细 Python爬虫教程-31-创建 Scrapy 爬虫框架项目 首先说一下,本篇是在 Anaconda 环 ...
- Scrapy爬虫框架(实战篇)【Scrapy框架对接Splash抓取javaScript动态渲染页面】
(1).前言 动态页面:HTML文档中的部分是由客户端运行JS脚本生成的,即服务器生成部分HTML文档内容,其余的再由客户端生成 静态页面:整个HTML文档是在服务器端生成的,即服务器生成好了,再发送 ...
- 纯手写SpringMVC到SpringBoot框架项目实战
引言 Spring Boot其设计目的是用来简化新Spring应用的初始搭建以及开发过程.该框架使用了特定的方式来进行配置,从而使开发人员不再需要定义样板化的配置. 通过这种方式,springboot ...
- UI自动化测试框架(项目实战)python、Selenium(日志、邮件、pageobject)
其实百度UI自动化测试框架,会出来很多相关的信息,不过就没有找到纯项目的,无法拿来使用的:所以我最近就写了一个简单,不过可以拿来在真正项目中可以使用的测试框架. 项目的地址:https://githu ...
- scrapy爬虫框架入门实战
博客 https://www.jianshu.com/p/61911e00abd0 项目源码 https://github.com/ppy2790/jianshu/blob/master/jiansh ...
- python爬虫小项目实战
- jsoup爬虫,项目实战,欢迎收看
import com.mongodb.BasicDBObject import com.mongodb.DBCollection import org.jsoup.Jsoup import org.j ...
- Python爬虫教程-30-Scrapy 爬虫框架介绍
从本篇开始学习 Scrapy 爬虫框架 Python爬虫教程-30-Scrapy 爬虫框架介绍 框架:框架就是对于相同的相似的部分,代码做到不出错,而我们就可以将注意力放到我们自己的部分了 常见爬虫框 ...
随机推荐
- 2019 竞技世界java面试笔试题 (含面试题解析)
本人3年开发经验.18年年底开始跑路找工作,在互联网寒冬下成功拿到阿里巴巴.今日头条.竞技世界等公司offer,岗位是Java后端开发,最终选择去了竞技世界. 面试了很多家公司,感觉大部分公司考察的点 ...
- EXPORT_SYMBOL
EXPORT_SYMBOL只出现在2.6内核中,在2.4内核默认的非static函数和变量都会自动导入到kernel 空间 作用 EXPORT_SYMBOL标签内定义的函数或者符号对全部内核代码公开, ...
- SVN 报错 Can't install '*' from pristine store, because no checksum is recorded for this file
SVN同步.cleanup都会出现下面的提示: svn: E155017: Can't install '*' from pristine store, because no checksum is ...
- js 数组 深拷贝 复制 (汇总)
https://www.cnblogs.com/zhoupengyi/p/6048955.html https://www.cnblogs.com/racyily/p/3532176.html htt ...
- centos7 docker安装Jenkins BlueOcean
Jenkins是一款Java开发的跨平台持续集成和持续发布的开源项目,Jenkins已经作为各大公司进行CI/CD的首选工具.而BlueOcean是Jenkins推出的一个插件,其目的就是让程序员执行 ...
- redis基本操作使用
连接redis [root@master src]# redis-cli 127.0.0.1:6379> ping PONG 127.0.0.1:6379> set name root O ...
- MySQL/MariaDB数据库的函数
MySQL/MariaDB数据库的函数 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. MySQL/MariaDB数据库的函数分为系统函数和用户自定义函数(user-define ...
- Windows 将FTP 映射到本地文件夹 --简化操作
转载自yutiantongbu Windows 将FTP 映射到本地文件夹 --简化操作 1.右键我的电脑,选择映射网络驱动器 2.选择"连接到可用与存储文档和图片的网站" 3.接 ...
- PySpark 的背后原理--在Driver端,通过Py4j实现在Python中调用Java的方法.pyspark.executor 端一个Executor上同时运行多少个Task,就会有多少个对应的pyspark.worker进程。
PySpark 的背后原理 Spark主要是由Scala语言开发,为了方便和其他系统集成而不引入scala相关依赖,部分实现使用Java语言开发,例如External Shuffle Service等 ...
- 关于微信小程序在ios中无法调起摄像头问题
这几天关于微信小程序开发关于wx.chooseVideo组件问题,因为自己一直是安卓手机上测试,可以调取摄像头,但是应用在ios上无法打开摄像头,困扰了好多天,经过反复查看官方文档,今天总算修复了这个 ...