
spark集成kerberos
1、生成票据
1.1、创建认证用户
登陆到kdc服务器,使用root或者可以使用root权限的普通用户操作:
# kadmin.local -q “addprinc -randkey spark/yjt”
1.2、生成密钥文件
生成spark密钥文件
# kadmin.local -q “xst -norankey -k /etc/spark.keytab spark/yjt”
拷贝sparkkeytab到所有的spark集群节点的conf目录下
1.3、修改权限
# chmod 404 /data1/hadoop/spark/conf/spark.keytab
# chown hduser:hduser /data1/hadoop/spark/conf/spark.keytab
2、集群内部测试
2.1、获取票据
# klint -it /data1/hadoop/spark/conf/spark.keytab spark/yjt
(1)、本地机器测试
# spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi examples/jars/spark-examples_2.11-2.4.0.jar 10
(2) 、提交到yarn, 模式是client
spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master yarn examples/jars/spark-examples_2.11-2.4.0.jar 10
查看8088信息:

(3) 、提交到yarn集群,模式是cluster
# spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master yarn --deploy-mode cluster examples/jars/spark-examples_2.11-2.4.0.jar 10
查看8088信息:

3、客户端测试
3.1、hduser用户测试
安装spark或者从集群拷贝一份到客户端
客户端测试用户使用hduser
获取票据
# kinit -kt /data1/hadoop/spark/conf/spark.keytab spark/yjt
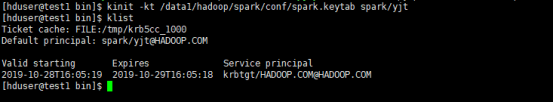
(1) 、提交到本地集群
# ./bin/spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master spark://192.168.0.230:7077 examples/jars/spark-examples_2.11-2.4.0.jar 10
注意:使用这种方式提交需要在集群里面的hosts文件配置客户端的主机域名映射关系。
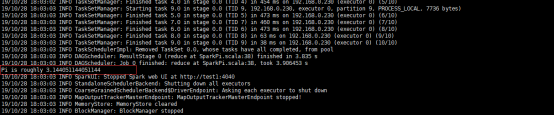
(2) 、提交到yarn,模式client
# ./bin/spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master yarn examples/jars/spark-examples_2.11-2.4.0.jar 10
注:这种方式也需要在集群内部设置客户端主机名映射关系
(3) 、提交到yarn,模式cluster
# ./bin/spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master yarn --deploy-mode cluster examples/jars/spark-examples_2.11-2.4.0.jar 10

3.2、其他用户测试
(1)、创建用户yujt
# useradd -s /bin/bash -m -d /home/yujt -G hduser yujt
# echo “Your Password” | passwd --stdin yujt
(2)、修改spark.keytab权限
# chmod 404 /data1/hadoop/spark/conf/spark.keytab
注: 以上操作root或者sudo,需要root权限
# su - yujt
(3)、修改yujt这个用户的环境变量
修改用户的~/.bashrc文件,添加如下信息:(当然最好是直接修改/etc/profile,这样在创建用户的时候就不需要为每个用户添加环境变量信息)
export JAVA_HOME=/data1/hadoop/jdk
export PATH=${JAVA_HOME}/bin:$PATH
export HADOOP_HOME=/data1/hadoop/hadoop
export PATH=${HADOOP_HOME}/bin:${HADOOP_HOME}/sbin:$PATH
(4) 、测试本地standlone模式
# ./bin/spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master spark://192.168.0.230:7077 examples/jars/spark-examples_2.11-2.4.0.jar 10
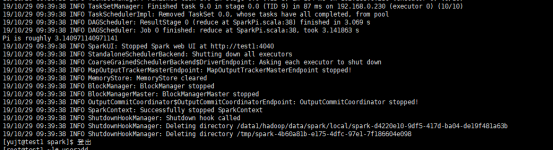
如上述,执行成功。
(5) 、测试yarn, 部署模式client
# $ ./bin/spark-submit --principal spark/yjt --keytab /data1/hadoop/spark/conf/spark.keytab --class org.apache.spark.examples.SparkPi --master yarn examples/jars/spark-examples_2.11-2.4.0.jar 10
执行结果如下:
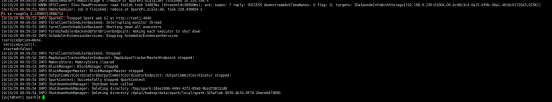
Web界面如下:

(6) 、测试yarn, 部署模式cluster

注:上述在执行任务的时候,我们使用了--principal 和--keytab参数,其实,如果使用kinit -kt /data1/hadoop/spark/conf/spark.keytab spark/yjt获取了票据以后,可以省略这两个参数。
spark集成kerberos的更多相关文章
- Spark:利用Eclipse构建Spark集成开发环境
前一篇文章“Apache Spark学习:将Spark部署到Hadoop 2.2.0上”介绍了如何使用Maven编译生成可直接运行在Hadoop 2.2.0上的Spark jar包,而本文则在此基础上 ...
- spark集成hive遭遇mysql check失败的问题
问题: spark集成hive,启动spark-shell或者spark-sql的时候,报错: INFO MetaStoreDirectSql: MySQL check failed, assumin ...
- Ambari集成Kerberos报错汇总
Ambari集成Kerberos报错汇总 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.查看报错的配置信息步骤 1>.点击Test Kerberos Client,查看相 ...
- HDP安全之集成kerberos/LDAP、ranger(knox自带LDAP)
----------------------目录导航见左上角------------------------------- 环境 HDP 3.0.1.0 (已有) JDK 1.8.0_91 (已有 ...
- Spark集成
一.Spark 架构与优化器 1.Spark架构 (重点) 2.Spark优化器 二.Spark+SQL的API (重点) 1.DataSet简介 2.DataFrame简介 3.RDD与DF/DS的 ...
- 机器学习 - pycharm, pyspark, spark集成篇
AS WE ALL KNOW,学机器学习的一般都是从python+sklearn开始学,适用于数据量不大的场景(这里就别计较“不大”具体指标是啥了,哈哈) 数据量大了,就需要用到其他技术了,如:spa ...
- 挖坑:hive集成kerberos
集成hive+kerberos前,hadoop已经支持kerberos,所以基础安装略去: https://www.cnblogs.com/garfieldcgf/p/10077331.html 直接 ...
- 机器学习 - 开发环境安装pycharm + pyspark + spark集成篇
AS WE ALL KNOW,学机器学习的一般都是从python+sklearn开始学,适用于数据量不大的场景(这里就别计较“不大”具体指标是啥了,哈哈) 数据量大了,就需要用到其他技术了,如:spa ...
- hive集成kerberos
1.票据的生成 kdc服务器操作,生成用于hive身份验证的principal 1.1.创建principal # kadmin.local -q “addprinc -randkey hive/yj ...
随机推荐
- 2019 房多多java面试笔试题 (含面试题解析)
本人5年开发经验.18年年底开始跑路找工作,在互联网寒冬下成功拿到阿里巴巴.今日头条.房多多等公司offer,岗位是Java后端开发,因为发展原因最终选择去了房多多,入职一年时间了,也成为了面试官 ...
- (转载) @ConfigurationProperties 注解使用姿势,这一篇就够了
SpringBoot中的@ConfigurationProperties 传送门: http://www.hellojava.com/a/82613.html
- 浏览器提示:源映射错误:request failed with status 404 源 URL:http://xxx.js 源映射 URL:jquery.min.map
浏览器 jquery1.9.1min.js 报脚本错误 无jquery.min.map 文件 最近在浏览个人网站的时候就遇到了这个问题 我先说一下什么是source map文件. source map ...
- Flask 基础总结回顾
1.Flask Request # from flask import request request.form # 获取FormData中的数据 request.args # 获取URL中的数据 r ...
- Java 之 Redis 基础
一.Redis 概述 1.什么是 Redis Redis:redis 是一款高性能的 NOSQL 系列的非关系型数据库. Redis是用C语言开发的一个开源的高性能键值对(key-value)数据库, ...
- linux修改当前用户环境变量永久生效
在linux环境中,修改当前用户环境变量,且永久生效的方法如下. 1,编辑~/.bash_profile文件 1 2 3 # Get the aliases and functions 4 if [ ...
- windows mysql 5.5.62 安装
下载链接: https://dev.mysql.com/downloads/installer/ mysql下载这边有句话,虽然是32位的安装包,但是可以装在32位和64位上. 建议迅雷下载. 然后打 ...
- PHP 将json的int类型转换为string类型 解决php bigint转科学计数法的问题
/** * 将json的int类型转换为string类型 * @param $str * @param int $minLength 最小的转换位数,即只有大于等于这个长度的数字才会被转换为字符串 * ...
- jar - 操作jar包的工具
jar - Manipulates Java Archive (JAR) files. jar命令是一种通用的存档和压缩工具,基于ZIP和ZLIB压缩格式. 常用格式: * 创建jar文件 jar c ...
- PHP三种输出的不同类型
var_dump() 能打印出类型print_r() 只能打出值echo() 是正常输出... 需要精确调试的时候用 var_dump();一般查看的时候用 print_r()另外 , echo不能显 ...