
为什么AI的翻译水平还远不能和人类相比?
为什么AI的翻译水平还远不能和人类相比?
https://mp.weixin.qq.com/s/0koIt-qu9IOVxNhbFcZr1Q
作者 | SHARON ZHOU
译者 | 王天宇
编辑 | 2812
出品 | AI 科技大本营
【导读】前一段时间,大家都在热议 Google 的翻译系统出现了一些相当奇怪的结果,例如下图呈现的是最被大家谈及的一个翻译结果。
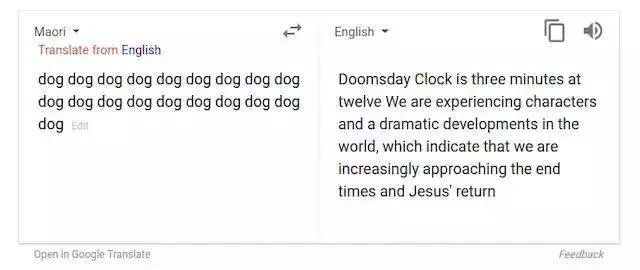
后来 Google 发言人也对包括数据在内等因素做出了解释(“这只是一个将无意义的话语输入系统然后产生无意义输出的功能”),随后界内一些技术人员也发表了分析与评论,表示这可能与 Google 采用的 NMT(神经机器翻译) 技术有关。
然而经过这一系列事件过后,大家又重新开始思考一个问题:AI 的翻译水平真的已经可以和人类媲美了吗?而本文的作者从 NMT 技术出发,分析了这项技术仍存在的问题,给出了自己明确的态度及答案:AI的翻译水平还远不能和人类相比。
最近,诸多媒体都报道了有关人工智能的翻译已经可以达到人类译者水平的新闻,如:
- The Verge – Google's AI translation system is approaching human-level accuracy
The Verge – 谷歌 AI 翻译系统的准确度趋近于人类
- Quartz – AI-based translation to soon reach human levels
Quartz – 基于人工智能的翻译即将达到人类水平
- ZDNet - Microsoft researchers match human levels in translation news from Chinese to English
ZDNet - 微软研究员表示,机器翻译中文新闻的水平可与人类匹敌
这一显著突破源于神经机器翻译(Neural Machine Translation, NMT)的出现,该方法使用神经网络来进行机器翻译。这项技术应用起来非常出色,是因为它有处理大规模翻译数据的能力。谷歌、Facebook 等大型科技公司在过去几年都引入了 NMT,并开发出了较高水平的翻译功能。
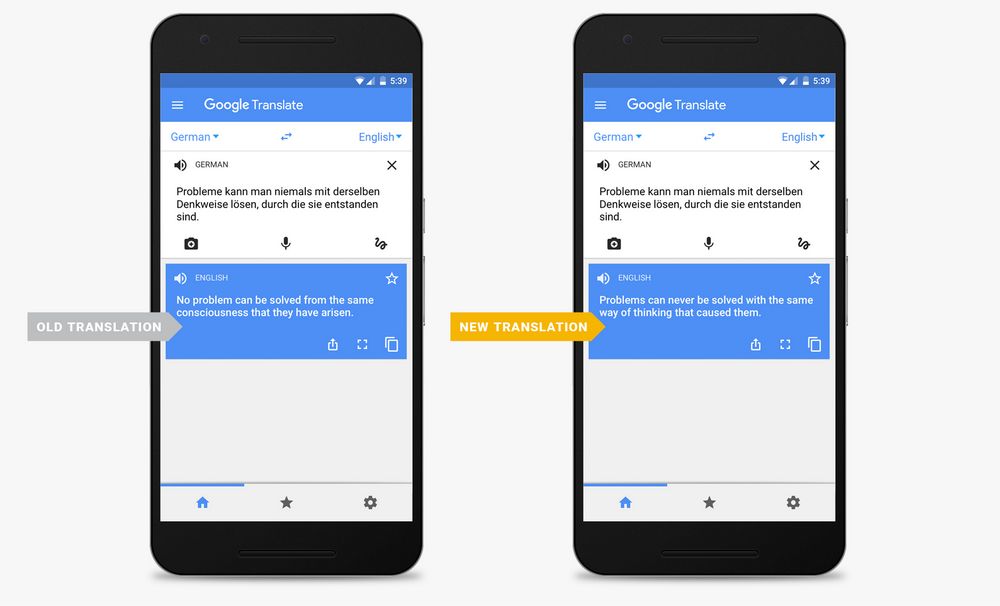
一个例子:引入 NMT 后,谷歌翻译的水平有明显提升
但 NMT 系统真的可以像上述题目说的那样,已经可以和人类译者相比了吗?还差得远呢。我们发现,目前的 NMT 系统并没有他们所说的那么好用,他们忽视了翻译中的许多关键问题。
▌什么是 NMT?

NMT 在整个 AI 领域中的位置
机器翻译(MT)是 AI 的一个分支,它致力于通过软件来进行不同语言之间的翻译。神经机器翻译(NMT)是一种较新颖的方法,它利用神经网络实现机器翻译。神经网络可以被训练,对数据进行模式识别,从而将输入数据转换为我们所需要的形式。接下来,我们看一个有关 NMT 系统的例子:
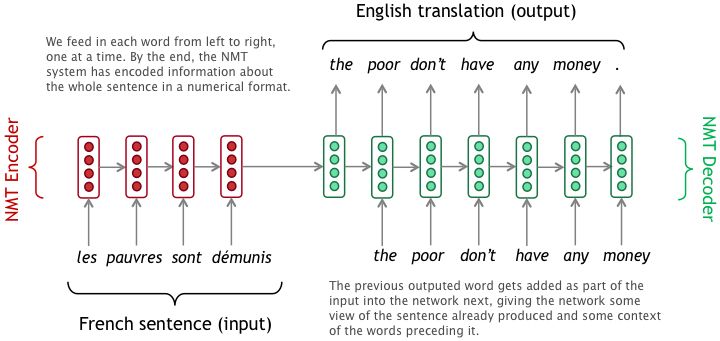
一个例子:将法语翻译成英语,引入 NMT 后质量有所提高
如果要将一句法语翻译成英语,NMT 的执行过程如下:先把需要翻译的法语句子输入网络,其中每个单词都会被编码成由数字组成的向量,这样网络才能对其进行处理。接下来,这些数字经过一系列数学公式的计算,最终生成一个新的数字序列,这个序列就代表了要输出的英文句子。
除了上述过程,在实际情况中,还有几个重要步骤:
- 在进行翻译前,人类工程师需要决定网络的具体结构;
- 工程师若要运行这样的网络,需要使用具备强大处理能力的计算机;
- 网络需要基于大量的语料数据,进行反复训练,才能具备合格的翻译水平;
- 最后,在测试 NMT 系统过程中,工程师要使用训练数据集中没有的语句进行测试,以确保系统在处理外部数据时也能正常工作。
▌强大的神经网络来源于强大的数据

引入海量数据后,深度神经网络的表现超过了其他模型
神经网络近期获得的成功源于大规模数据的出现。当有了足够多的数据作支撑,深度神经网络的提升尤为明显。同时,网络达到足够的深度,NMT 系统翻译的语句相比于过去技术翻译的结果也更为流畅。这里的“流畅”是指,输出的文本不会过于生硬,甚至有时候会被认为是人工翻译的结果。
▌NMT 存在什么问题?
回想文章开头提到的几个题目 -- NMT 听起来极其卓越,但它真的可以与人工翻译相比吗?根本不可能。事实上,与人类相比 NMT 在很多方面都存在缺陷。
这些缺陷可归为三类:可靠性、记忆力和判断力。
- 可靠性:这可能是最令人担忧的一点,NMT 翻译并不可靠。NMT 系统无法保证准确度,常常出现漏掉否定词、整个单词甚至整个短语的情况。
- 记忆力:NMT 系统还有严重的短期记忆缺陷。目前,我们所建立的系统每次只能翻译一句话,导致其忽略了上文中可能包含的信息。
- 判断力:NMT 系统对外部的信息与知识几乎没有判断能力。对翻译工作来说,把握一段内容在特定语境中的理解是很重要的,但对机器来说这很难做到。
在接下来的内容里,我会阐述有关这三个缺陷的细节。
▌可靠性
NMT 无法检查其输出的信息是否真实。例如,NMT 系统可能漏掉否定词或整段信息。这些错误会导致什么后果呢?
“The US did not attack the EU! Nothing to fear,”
这是著名报纸 Le Monde 中用法语报道的内容,然后机器翻译成英语的结果是:
“The US attacked the EU! Fearless.”
试想象,如果这样错误的翻译遍布互联网,在假新闻病毒式传播之前我们来得及更正吗?令人沮丧的是,这样的灾难几乎无法挽回。
▌记忆力
当前的 NMT 系统还有一个明显的不足:每次只能单独翻译一个句子。这意味着机器并不知道它们当前翻译的句子之前的内容。而作为人类,我们阅读文章的时候会联系上下文。
那么为什么我们在训练 NMT 系统时,每次只用一个句子而不是整段文档呢?这里面有技术原因:首先,对神经系统来说,读取一段长文档,储存所有信息并快速调用都很困难;其次,当输入的信息量过大时,系统运行的时间也会更长。所以为了提高效率,我们在训练过程中都使用了单独的语句。
总之,不能联系上下文是 NMT 的主要问题,尤其对于翻译一个故事来说至关重要。讲故事是人类的行为,是创造力、智慧和表达的结合,也因此将我们与动物区分开来。如果 AI 翻译系统连有条理地翻译一个故事都做不到,更不用说文法上是否优雅,怎么能说它们达到了人类的水平呢?
▌判断力
假设你在读一篇关于音乐会的文章,然后使用 NMT 系统把英语翻译成法语,发给了你讲法语的朋友。在英文原文中,文章记录了对许多音乐会参与者的采访,其中包括一位年轻人的感慨:
“I’m a huge metal fan!”
但这句话被翻译成了:
“Je suis un énorme ventilateur en métal” (“I’m a large ventilator made of metal.”)
在这篇文章中,系统并不知道 "metal fan" 是指热爱金属音乐的一类人,直接翻译成了由金属制造的通风装置。
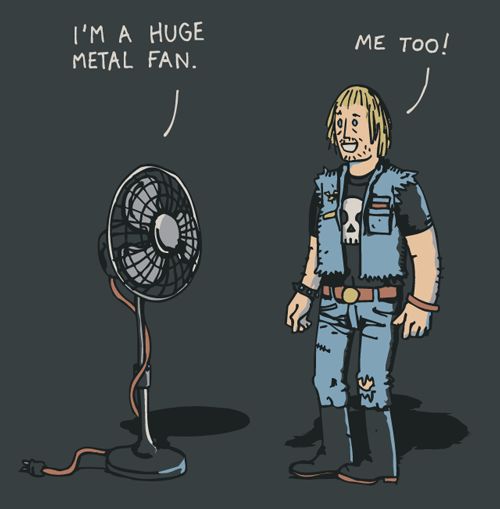
这个问题在机器发展初期就存在了,但至今无法解决。早在 1958 年的相关论文中就提到了该问题,这里有一个经典的例子:
The box was in the pen.
对此 NMT 系统会被 "pen" 这个单词困扰:它在这里指写字的工具还是围栏呢?
对 NMT 系统来说,关于世界的常识知识对翻译来说尤为重要。然而,对这些知识全部进行编码以及从大量数据中提取都是很困难的。我们需要一个有自主判断力的机制,并将常识知识引入到神经网络中。
▌什么是好的翻译?
我们应该如何评估机器翻译系统的水平?目前,最常用的方法是 BLEU score。我们把机器翻译出的内容与人工翻译的内容做对比,分别计算其 BLEU 分数。如果机器翻译结果中的单词和短语与人工的结果相似度很高,那么系统就会得到较高的 BLEU 分数。
BLEU score 是一种简单却有效的翻译评估方法,尤其在评估性能低的系统时。然而研究者发现,BLEU score 也经常与人类的观点不同。这意味着 BLEU 指标只能在若干低性能系统中挑选出最佳的一个,而面对性能更好的系统进行评估时比较吃力。
相比于 BLEU 评估方法,对翻译结果直接进行人工评估的方法更加出色,但也并非没有缺点。关于人工对机器翻译进行评估,存在两个不可忽视的问题:
- 人工评估不是自动的,所以成本较高且效率低。
- 人工评估往往会出现分歧。这个问题不仅存在于 BLEU 方法与人类之间,也存在于人类评估者之间。
总地来说,虽然人工评估效果更好,但它需要很高的成本,同时要求尽量不能出错。进一步来说,在将 NMT 系统与人类译者做对比时,要考虑到评估机制的限制因素。
▌我们仍在继续努力!未来会如何发展?
NMT 正在飞速发展,新的进步与突破也在被频繁报道着。新的研究正致力于解决以上提出的所有问题:可靠性、数据偏差、无意义输出、记忆力、对常识的判断力以及评估标准。
过去几年,NMT 在表现和效率方面都有所突破。这源于新系统不再需要连续处理数据,如按照从左到右或从右到左的顺序,从而使我们可以同时训练更多的数据,最后生成更合理的翻译结果。
同时,我们可以期待会有越来越多关于新研究的报道。哈佛的 OpenNMT -- 一个可用于 LuaTorch、PyTorch 和 Tensorflow 的开源神经机器翻译工具包,正在迅速融入新的方法,以便于大家可以建立最好的翻译系统。由前谷歌研究员开发的新型商业系统 deepL,声称已经超越谷歌的翻译系统。这是一个发展迅速的领域,这也是一个见证 NMT 不断突破的时代。
原文链接:
https://www.skynettoday.com/editorials/state_of_nmt
——【完】——
为什么AI的翻译水平还远不能和人类相比?的更多相关文章
- [tool] AI视频翻译 解决英文视频字幕问题(类似youtube自动生成字幕)
1.网易见外是网易人工智能事业部旗下的AI视频翻译产品. 字幕支持手工编辑和下载 不过网易见外 只支持WEB在线操作 并且只支持单个上传操作 目前没有客户端 2.人人译视界 (IOS 安卓 PC客户端 ...
- libgdx 启动者(个人翻译,还请不吝赐教)类和配置
本文章翻译自libGDX官方wiki,.转载请注明出处:http://blog.csdn.net/kent_todo/article/details/37942047 libGDX官方网址:http: ...
- 这样学习ZooKeeper离大厂所需技能要求还远吗
概述 定义 Apache ZooKeeper是一种用于构建分布式应用的高性能.高度可靠.开源的分布式协调服务,提供如配置信息维护.命名.分布式同步.组服务等功能,可以实现如分布式共识.组管理.领导选举 ...
- Google翻译,3个步骤灭绝人类
今儿这事儿得从一个新闻说起:<谷歌又飙车了,刚发布了神经机器翻译系统,没见过的语言它也能翻译> 大家如果懒的看原文,可以直接看我这个简单白话列表: Google又出来嘚瑟了,发布了基于神经 ...
- 新型编译器将原生代码转换为JavaScript
导读:Emscripten C/C++到JavaScript项目利用来自LLVM的后端构建起更具速度与针对性优势的编译方案. 在当初刚刚公布时,Emsripten听起来完全像是个冲劲十足的技术笑谈:一 ...
- 为什么今天的L4无人驾驶无法到达终局(转)
本文来自于公众号驭势未来,是驭势科技的微信公众平台,本博客收录的这篇文章版权作者吴甘沙,博客中仅对部分内容进行编辑. 作者:吴甘沙 原文链接:here 声明:文中的观点只代表版权作者的观点,本转载不涉 ...
- 手把手教你用 Keras 实现 LSTM 预测英语单词发音
1. 动机 我近期在研究一个 NLP 项目,根据项目的要求,需要能够通过设计算法和模型处理单词的音节 (Syllables),并对那些没有在词典中出现的单词找到其在词典中对应的押韵词(注:这类单词类似 ...
- 剖析CPU温度监控技术【转】
转自:http://blog.csdn.net/hunanchenxingyu/article/details/46476545 迄今为止还没有一种cpu散热系统能保证永不失效.失去了散热系统保护伞的 ...
- 剖析CPU温度监控技术
转载 :剖析CPU温度监控技术 标签: CPU 温度控制技术 1805 具体温度检测调整代码(转载) 迄今为止还没有一种cpu散热系统能保证永不失效.失去了散热系统保护伞的“芯”,往 ...
随机推荐
- 用C#+Selenium+ChromeDriver 生成我的咕咚跑步路线地图
先上结果: 之前 在公司业务中用过java+Selenium+ChromeDriver ,使用起来非常顺手,可以完美模拟真实的用户浏览行为.最近休息的时候想用C#也试一下,于是有了本文. 实现原理一样 ...
- Echarts 几个常用图
最近公司业务上的 需求,要求做一些图表,我们技术框架上选择方便使用的Echarts. 下面是效果图: 下面是具体代码: <!DOCTYPE html> <html> <h ...
- Python必学Django框架,入门到精通学习视频教程全都在这可以领
“人生苦短,我用python”,学python的小伙伴应该都了解这句话的含义.但是,学python,你真正了了解强大的Django框架吗!? 据说Django还是由吉普赛的一个吉他手的名字命名的呢,有 ...
- springmvc 请求参数解析细节
springmvc 的请求流程,相信大家已经很熟悉了,不熟悉的同学可以参考下资料! 有了整体流程的概念,是否对其中的实现细节就很清楚呢?我觉得不一定,比如:单是参数解析这块,就是个大学问呢? 首先,我 ...
- 【jpa】spring data jpa 配置使用
1.spring data jpa 简单介绍 jpa是用于对象持久化的API,jpa是一种规范,而其他的ORM框架(hibernate,topLink等)是其实现,所以jpa可以使用不同的实现方式,修 ...
- pytorch: 准备、训练和测试自己的图片数据
大部分的pytorch入门教程,都是使用torchvision里面的数据进行训练和测试.如果我们是自己的图片数据,又该怎么做呢? 一.我的数据 我在学习的时候,使用的是fashion-mnist.这个 ...
- H5本地存储sessionStorage和localStorage的区别
sessionStorage用于本地存储一个会话(session)中的数据,这些数据只有在同一个会话中的页面才能访问并且当会话结束后数据也随之销毁.因此sessionStorage不是一种持久化的本地 ...
- Python爬虫入门教程 13-100 斗图啦表情包多线程爬取
斗图啦表情包多线程爬取-写在前面 今天在CSDN博客,发现好多人写爬虫都在爬取一个叫做斗图啦的网站,里面很多表情包,然后瞅了瞅,各种实现方式都有,今天我给你实现一个多线程版本的.关键技术点 aioht ...
- Java开发需掌握的常用Linux命令(持续更新)
linux命令是对Linux系统进行管理的命令.对于Linux系统来说,无论是中央处理器.内存.磁盘驱动器.键盘.鼠标,还是用户等都是文件,Linux系统管理的命令是它正常运行的核心,与之前的DOS命 ...
- [深度思考]·为什么CNN是同步(并行)而RNN是异步(串行)的呢?
为什么CNN是同步(并行)而RNN是异步(串行)的呢? 个人主页--> https://xiaosongshine.github.io/ 1.问题引出 CNN与RNN都是采用parameter ...