
更简易的机器学习-pycaret的安装和环境初始化
1、安装
pip install pycaret
在谷歌colab中还要运行:
from pycaret.utils import enable_colab

enable_colab()
2、获取数据
(1)利用pandas库加载
import pandas as pd

data = pd.read_csv('c:/path_to_data/file.csv')
(2)使用自带的数据
from pycaret.datasets import get_data

data = get_data('juice')
数据集列表:
| Dataset | Data Types | Default Task | Target Variable | # Instances | # Attributes |
| anomaly | Multivariate | Anomaly Detection | None | 1000 | 10 |
| france | Multivariate | Association Rule Mining | InvoiceNo, Description | 8557 | 8 |
| germany | Multivariate | Association Rule Mining | InvoiceNo, Description | 9495 | 8 |
| bank | Multivariate | Classification (Binary) | deposit | 45211 | 17 |
| blood | Multivariate | Classification (Binary) | Class | 748 | 5 |
| cancer | Multivariate | Classification (Binary) | Class | 683 | 10 |
| credit | Multivariate | Classification (Binary) | default | 24000 | 24 |
| diabetes | Multivariate | Classification (Binary) | Class variable | 768 | 9 |
| electrical_grid | Multivariate | Classification (Binary) | stabf | 10000 | 14 |
| employee | Multivariate | Classification (Binary) | left | 14999 | 10 |
| heart | Multivariate | Classification (Binary) | DEATH | 200 | 16 |
| heart_disease | Multivariate | Classification (Binary) | Disease | 270 | 14 |
| hepatitis | Multivariate | Classification (Binary) | Class | 154 | 32 |
| income | Multivariate | Classification (Binary) | income >50K | 32561 | 14 |
| juice | Multivariate | Classification (Binary) | Purchase | 1070 | 15 |
| nba | Multivariate | Classification (Binary) | TARGET_5Yrs | 1340 | 21 |
| wine | Multivariate | Classification (Binary) | type | 6498 | 13 |
| telescope | Multivariate | Classification (Binary) | Class | 19020 | 11 |
| glass | Multivariate | Classification (Multiclass) | Type | 214 | 10 |
| iris | Multivariate | Classification (Multiclass) | species | 150 | 5 |
| poker | Multivariate | Classification (Multiclass) | CLASS | 100000 | 11 |
| questions | Multivariate | Classification (Multiclass) | Next_Question | 499 | 4 |
| satellite | Multivariate | Classification (Multiclass) | Class | 6435 | 37 |
| asia_gdp | Multivariate | Clustering | None | 40 | 11 |
| elections | Multivariate | Clustering | None | 3195 | 54 |
| Multivariate | Clustering | None | 7050 | 12 | |
| ipl | Multivariate | Clustering | None | 153 | 25 |
| jewellery | Multivariate | Clustering | None | 505 | 4 |
| mice | Multivariate | Clustering | None | 1080 | 82 |
| migration | Multivariate | Clustering | None | 233 | 12 |
| perfume | Multivariate | Clustering | None | 20 | 29 |
| pokemon | Multivariate | Clustering | None | 800 | 13 |
| population | Multivariate | Clustering | None | 255 | 56 |
| public_health | Multivariate | Clustering | None | 224 | 21 |
| seeds | Multivariate | Clustering | None | 210 | 7 |
| wholesale | Multivariate | Clustering | None | 440 | 8 |
| tweets | Text | NLP | tweet | 8594 | 2 |
| amazon | Text | NLP / Classification | reviewText | 20000 | 2 |
| kiva | Text | NLP / Classification | en | 6818 | 7 |
| spx | Text | NLP / Regression | text | 874 | 4 |
| wikipedia | Text | NLP / Classification | Text | 500 | 3 |
| automobile | Multivariate | Regression | price | 202 | 26 |
| bike | Multivariate | Regression | cnt | 17379 | 15 |
| boston | Multivariate | Regression | medv | 506 | 14 |
| concrete | Multivariate | Regression | strength | 1030 | 9 |
| diamond | Multivariate | Regression | Price | 6000 | 8 |
| energy | Multivariate | Regression | Heating Load / Cooling Load | 768 | 10 |
| forest | Multivariate | Regression | area | 517 | 13 |
| gold | Multivariate | Regression | Gold_T+22 | 2558 | 121 |
| house | Multivariate | Regression | SalePrice | 1461 | 81 |
| insurance | Multivariate | Regression | charges | 1338 | 7 |
| parkinsons | Multivariate | Regression | PPE | 5875 | 22 |
| traffic | Multivariate | Regression | traffic_volume | 48204 | 8 |
3、设置环境
(1)第一步:导入模块
pycaret提供以下6种模块,当你导入相应的模块之后,就将环境切换到了该环境下。
| S.No | Module | How to Import |
| 1 | Classification | from pycaret.classification import * |
| 2 | Regression | from pycaret.regression import * |
| 3 | Clustering | from pycaret.clustering import * |
| 4 | Anomaly Detection | from pycaret.anomaly import * |
| 5 | Natural Language Processing | from pycaret.nlp import * |
| 6 | Association Rule Mining | from pycaret.arules import * |
(2)第二步:初始化设置
对于PyCaret中的所有模块都是通用的,设置是开始任何机器学习实验的第一步,也是唯一的必需步骤。 除默认情况下执行一些基本处理任务外,PyCaret还提供了广泛的预处理功能,这些功能在结构上将普通的机器学习实验提升为高级解决方案。 在本节中,我们仅介绍了设置功能的必要部分。 可以在此处找到所有预处理功能的详细信息。 下面列出的是初始化设置时PyCaret执行的基本默认任务:
数据类型推断:在PyCaret中执行的任何实验都始于确定所有特征的正确数据类型。 设置函数执行有关数据的基本推断,并执行一些下游任务,例如忽略ID和Date列,分类编码,基于PyCaret内部算法推断的数据类型的缺失值插补。 执行设置后,将出现一个对话框(请参见以下示例),其中包含所有特征及其推断的数据类型的列表。 数据类型推断通常是正确的,但是一旦出现对话框,用户应查看列表的准确性。 如果正确推断了所有数据类型,则可以按Enter键继续,否则,请键入“ quit”以停止实验。

如果您由于无法正确推断一种或多种数据类型而选择输入“退出”,则可以在setup命令中覆盖它们,方法是传递categorical_feature参数以强制分类类型,而numeric_feature参数则强制数字类型。 同样,为了忽略某些功能以成为实验的一部分,您可以在设置程序中传递ignore_features参数。
注意:如果您不希望PyCaret显示确认数据类型的对话框,则可以在设置过程中以“ True”(静默)方式传递为True,以执行无人看管的实验。 我们不建议您这样做,除非您完全确定推断是正确的,或者您之前已经进行过实验,或者正在使用numeric_feature和categorical_feature参数覆盖数据类型。
数据清理和准备:设置功能会自动执行缺失值插补和分类编码,因为它们对于任何机器学习实验都是必不可少的。 默认情况下,平均值用于数字特征的插补,而最频繁使用的值或模式用于分类特征。 您可以使用numeric_imputation和categorical_imputation参数来更改方法。 对于分类问题,如果目标不是数字类型,则安装程序还将执行目标编码。
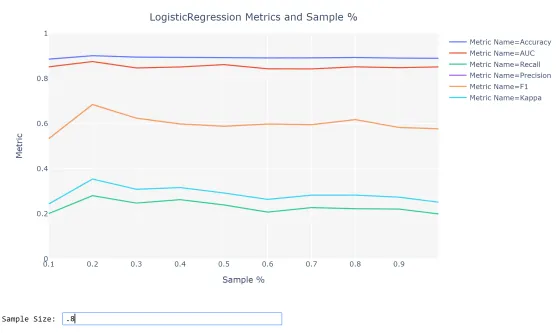
数据采样:如果样本量大于25,000,PyCaret会根据不同的样本量自动构建初步的线性模型,并提供可视化效果,以根据样本量显示模型的性能。 然后可以使用该图来评估模型的性能是否随样本数量的增加而增加。 如果不是,您可以选择较小的样本量,以提高实验的效率和性能。 请参见下面的示例,在该示例中,我们使用了pycaret存储库中的“银行”数据集,其中包含45,211个样本。
训练测试拆分:设置功能还执行训练测试拆分(针对分类问题进行了分层)。 默认的分割比例为70:30,但是您可以在设置程序中使用train_size参数进行更改。 仅在Train set上使用k倍交叉验证,才能对PyCaret中已训练好的机器学习模型和超参数优化进行评估。
将会话ID分配为种子:如果未传递session_id参数,则会话ID是默认生成的伪随机数。 PyCaret将此id作为种子分发给所有函数,以隔离随机效应。 这样可以在以后在相同或不同的环境中实现可重现性。
以下是一些例子:
分类:
from pycaret.datasets import get_data

diabetes = get_data('diabetes')

# Importing module and initializing setup

from pycaret.classification import *

clf1 = setup(data = diabetes, target = 'Class variable')

回归:
from pycaret.datasets import get_data

boston = get_data('boston')

# Importing module and initializing setup

from pycaret.regression import *

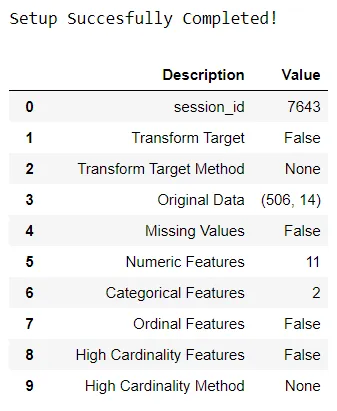
reg1 = setup(data = boston, target = 'medv')
聚类:
from pycaret.datasets import get_data

jewellery = get_data('jewellery')

# Importing module and initializing setup

from pycaret.clustering import *

clu1 = setup(data = jewellery)

异常检测:
from pycaret.datasets import get_data

anomalies = get_data('anomaly')

# Importing module and initializing setup

from pycaret.anomaly import *

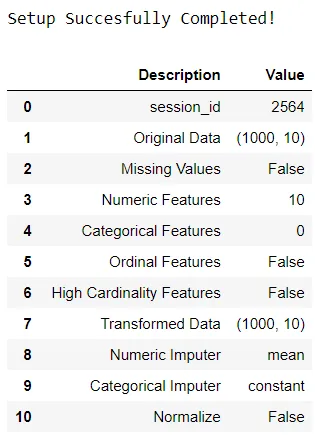
ano1 = setup(data = anomalies)
自然语言处理:
from pycaret.datasets import get_data

kiva = get_data('kiva')

# Importing module and initializing setup

from pycaret.nlp import *

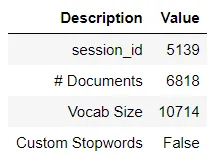
nlp1 = setup(data = kiva, target = 'en')
关联规则挖掘:
from pycaret.datasets import get_data

france = get_data('france')

# Importing module and initializing setup

from pycaret.arules import *

arules1 = setup(data = france, transaction_id = 'InvoiceNo', item_id = 'Description')

更简易的机器学习-pycaret的安装和环境初始化的更多相关文章
- 机器学习实战__安装python环境
环境:win7 64位系统 第一步:安装python 1.下载python2.7.3 64位 msi 版本(这里选择了很多2.7的其他更高版本导致安装setuptools失败,也不知道是什么原因,暂时 ...
- CentOS7+CDH5.14.0安装全流程记录,图文详解全程实测-1虚拟机安装及环境初始化
1.软件准备: VMware-workstation-full-14.1.2-8497320.exe CentOS-7-x86_64-DVD-1804.iso 2.VMare激活码: AU5WA-0E ...
- 微软开源自动机器学习工具NNI安装与使用
微软开源自动机器学习工具 – NNI安装与使用 在机器学习建模时,除了准备数据,最耗时耗力的就是尝试各种超参组合,找到最佳模型的过程了.对于初学者来说,常常是无从下手.即使是对于有经验的算法工程师 ...
- 机器学习库shark安装
经过两天的折腾,一个对c++和机器学习库的安装都一知半解的人终于在反复安装中,成功的将shark库安装好了,小小纪念一下,多亏了卡门的热心帮忙. shark的安装主要分为以下几个部分: (1)下载 s ...
- 机器学习linux系统环境安装
机器学习linux系统环境安装 安装镜像下载 可以自己去ubuntu官方网站按照提示下载amd64的desktop版本 或者考虑到国内镜像站点下载,如tuna,163, ali等 课程使用最新的17. ...
- Windows+Python+anaconda机器学习安装及环境配置步骤
Windows+Python+anaconda机器学习安装及环境配置步骤 1. 下载安装python3.6以上版本(包含pip,不用自己安装)2. 直接下载安装pycharm安装包(用于编写pytho ...
- django 简易博客开发 1 安装、创建、配置、admin使用
首先贴一下项目地址吧 https://github.com/goodspeedcheng/sblog 到现在位置项目实现的功能有: 1.后台管理使用Admin ,前端显示使用bootstrap 2. ...
- 在Windows/Ubuntu下安装OpenGL环境(GLUT/freeglut)与跨平台编译(mingw/g++)
GLUT/freeglut 是什么? OpenGL 和它们有什么关系? OpenGL只是一个标准,它的实现一般自带在操作系统里,只要确保显卡驱动足够新就可以使用.如果需要在程序里直接使用OpenGL, ...
- 第一章 andriod studio 安装与环境搭建
原文 http://blog.csdn.net/zhanghefu/article/details/9286123 第一章 andriod studio 安装与环境搭建 一.Android Stu ...
随机推荐
- 文件压缩跟解压(本地&Linux服务器)
远程解压需要的jar包: <dependency> <groupId>commons-net</groupId> <artifactId>commons ...
- Sympy解方程-求极限-微分-积分-矩阵运算
简介 Sympy是一个Python的科学计算库,用一套强大的符号计算体系完成诸如多项式求值.求极限.解方程.求积分.微分方程.级数展开.矩阵运算等等计算问题.虽然Matlab的类似科学计算能力也很强大 ...
- MySql 实现数组根据下标获取对应值逻辑(array[i]逻辑)
在使用sql模拟一段java逻辑开发时碰到有一段逻辑为从字符串数组中根据下标获取对应的值的情况,百度了一番没有发现有类似功能的函数和现成的实现方式,经过调试弄出来了,记录下来,以备参考 //举例:从数 ...
- Dockerfile使用,示例
1.dockerfile介绍 镜像分类: 基础镜像:例如centos.Ubuntu.alpine 环境镜像:例如Java.php.go 项目镜像:将项目与环境镜像打包一起 2.Dockerfile常用 ...
- Redis源码笔记--服务器日志和函数可变参数处理server.c
前言 Redis源码中定义了几个和日志相关的函数,用于将不同级别的信息打印到不同的位置(日志文件或标准输出,取决于配置文件的设置),这些函数的定义位于 server.h 和server.c 文件中,包 ...
- LG P2389 电脑班的裁员
Description ZZY有独特的裁员技巧:每个同学都有一个考试得分$a_i(-1000 \leq a_i \leq 1000)$,在$n$个同学$(n \leq 500)$中选出不大于$k$段$ ...
- 你想了解的分布式文件系统HDFS,看这一篇就够了
1.分布式文件系统 计算机集群结构 分布式文件系统把文件分布存储到多个节点(计算机)上,成千上万的计算机节点构成计算机集群. 分布式文件系统使用的计算机集群,其配置都是由普通硬件构成的,与用多个处理器 ...
- windows下nginx的配置
这里做的nginx的配置主要的功能是: 能够用localhost访问本地文件夹中的项目 输入ip地址访问本地文件夹中的项目 反向代理其他地址访问本地文件 1.nginx安装地址 2.解压之后的文件如下 ...
- 回归 | js实用代码片段的封装与总结(持续更新中...)
上一次更博还是去年10月28号了,截至今天已经有整整4个月没有更新博客了,没更新博客不是代表不学了,期间我已经用vue做了两个项目,微信小程序做了一个项目,只是毕竟找到工作了,想偷偷懒,你懂的. ...
- 抢先学鸿蒙(HarmonyOS)2.0,你就是下一个大咖!
1. 你不知道的鸿蒙(HarmonyOS) 2020年9月10日,华为开发者大会发布了鸿蒙(HarmonyOS)2.0.我在2020-9-11日也发布了全球首套鸿蒙2.0 App开发视频课 ...