
3-----Scrapy框架的命令行详解
创建爬虫项目
scrapy startproject 项目名
例子如下:
E:\crawler>scrapy startproject test1

New Scrapy project 'test1', using template directory 'd:\\python36\\lib\\site-packages\\scrapy\\templates\\project', created in:

    E:\crawler\test1

You can start your first spider with:

    cd test1

    scrapy genspider example example.com

E:\crawler>
这个时候爬虫的目录结构就已经创建完成了,目录结构如下:
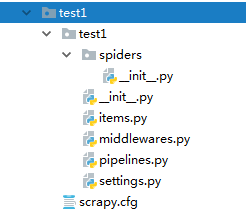
接着我们按照提示可以生成一个spider,这里以百度作为例子,生成spider的命令格式为;
scrapy genspider 爬虫名字 爬虫的网址
E:\crawler\test1>scrapy genspider baiduSpider baidu.com

Created spider 'baiduSpider' using template 'basic' in module:

  test1.spiders.baiduSpider

E:\crawler\test1>
关于命令详细使用
命令的使用范围
这里的命令分为全局的命令和项目的命令,全局的命令表示可以在任何地方使用,而项目的命令只能在项目目录下使用
全局的命令有:
startproject
genspider
settings
runspider
shell
fetch
view
version
项目命令有:
crawl
check
list
edit
parse
bench
startproject
这个命令没什么过多的用法,就是在创建爬虫项目的时候用
genspider
用于生成爬虫,这里scrapy提供给我们不同的几种模板生成spider,默认用的是basic,我们可以通过命令查看所有的模板
E:\crawler\test1>scrapy genspider -l

Available templates:

  basic

  crawl

  csvfeed

  xmlfeed

E:\crawler\test1>
当我们创建的时候可以指定模板,不指定默认用的basic,如果想要指定模板则通过
scrapy genspider -t 模板名字
E:\crawler\test1>scrapy genspider -t crawl zhihuspider zhihu.com

Created spider 'zhihuspider' using template 'crawl' in module:

  test1.spiders.zhihuspider

E:\crawler\test1>
crawl
这个是用去启动spider爬虫格式为:
scrapy crawl 爬虫名字
这里需要注意这里的爬虫名字和通过scrapy genspider 生成爬虫的名字是一致的
check
用于检查代码是否有错误,scrapy check
list
scrapy list列出所有可用的爬虫
fetch
scrapy fetch url地址
该命令会通过scrapy downloader 讲网页的源代码下载下来并显示出来
这里有一些参数:
--nolog 不打印日志
--headers 打印响应头信息
--no-redirect 不做跳转
view
scrapy view url地址
该命令会讲网页document内容下载下来,并且在浏览器显示出来
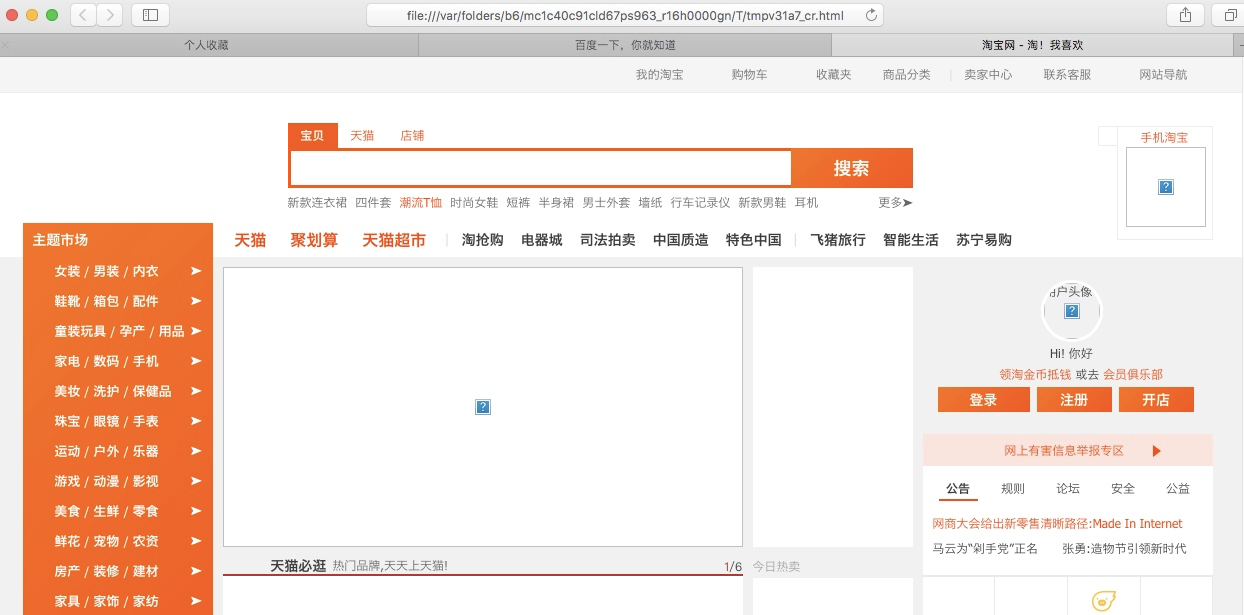
因为现在很多网站的数据都是通过ajax请求来加载的,这个时候直接通过requests请求是无法获取我们想要的数据,所以这个view命令可以帮助我们很好的判断
shell
这是一个命令行交互模式
通过scrapy shell url地址进入交互模式
这里我么可以通过css选择器以及xpath选择器获取我们想要的内容(xpath以及css选择的用法会在下个文章中详细说明),例如我们通过scrapy shell http://www.baidu.com
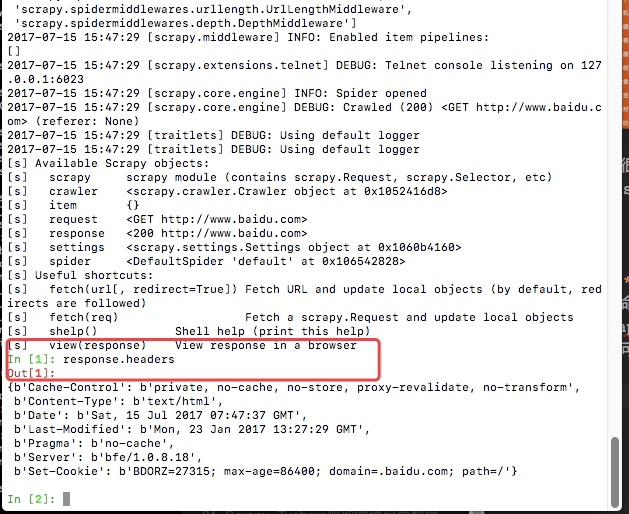
这里最后给我们返回一个response,这里的response就和我们通requests请求网页获取的数据是相同的。
view(response)会直接在浏览器显示结果
response.text 获取网页的文本
下图是css选择器的一个简单用法

settings
获取当前的配置信息
通过scrapy settings -h可以获取这个命令的所有帮助信息
E:\crawler\test1>scrapy settings -h

Usage

=====

  scrapy settings [options]

Get settings values

Options

=======

--help, -h              show this help message and exit

--get=SETTING           print raw setting value

--getbool=SETTING       print setting value, interpreted as a boolean

--getint=SETTING        print setting value, interpreted as an integer

--getfloat=SETTING      print setting value, interpreted as a float

--getlist=SETTING       print setting value, interpreted as a list

Global Options

--------------

--logfile=FILE          log file. if omitted stderr will be used

--loglevel=LEVEL, -L LEVEL

                        log level (default: DEBUG)

--nolog                 disable logging completely

--profile=FILE          write python cProfile stats to FILE

--pidfile=FILE          write process ID to FILE

--set=NAME=VALUE, -s NAME=VALUE

                        set/override setting (may be repeated)

--pdb                   enable pdb on failure

E:\crawler\test1>
拿一个例子进行简单的演示:(这里是我的这个项目的settings配置文件中配置了数据库的相关信息,可以通过这种方式获取,如果没有获取的则为None)
E:\crawler\test1>scrapy settings  --get=MYSQL_HOST

None

E:\crawler\test1>
runspider
这个和通过crawl启动爬虫不同,这里是scrapy runspider 爬虫文件名称
所有的爬虫文件都是在项目目录下的spiders文件夹中
version
查看版本信息,并查看依赖库的信息
E:\crawler\test1>scrapy version

Scrapy 1.5.1

E:\crawler\test1>scrapy version -v

Scrapy       : 1.5.1

lxml         : 4.2.5.0

libxml2      : 2.9.5

cssselect    : 1.0.3

parsel       : 1.5.0

w3lib        : 1.19.0

Twisted      : 18.7.0

Python       : 3.6.3 (v3.6.3:2c5fed8, Oct  3 2017, 18:11:49) [MSC v.1900 64 bit (AMD64)]

pyOpenSSL    : 18.0.0 (OpenSSL 1.1.0h  27 Mar 2018)

cryptography : 2.3

Platform     : Windows-7-6.1.7601-SP1

E:\crawler\test1>
3-----Scrapy框架的命令行详解的更多相关文章
- Scrapy框架的命令行详解【转】
Scrapy框架的命令行详解 请给作者点赞 --> 原文链接 这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: loca ...
- Python爬虫从入门到放弃(十三)之 Scrapy框架的命令行详解
这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy start ...
- Python之爬虫(十五) Scrapy框架的命令行详解
这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy start ...
- [转载]OpenSSL中文手册之命令行详解(未完待续)
声明:OpenSSL之命令行详解是根据卢队长发布在https://blog.csdn.net/as3luyuan123/article/details/16105475的系列文章整理修改而成,我自己 ...
- scrapy框架的命令行解释
scrapy框架的命令解释 创建爬虫项目 scrapy startproject 项目名例子如下: scrapy startproject test1 这个时候爬虫的目录结构就已经创建完成了,目录结构 ...
- 7Z命令行详解
7z.exe在CMD窗口的使用说明如下: 7-Zip (A) 4.57 Copyright (c) 1999-2007 Igor Pavlov 2007-12-06 Usage: 7za <co ...
- 7-zip命令行详解
一.简介 7z,全称7-Zip, 是一款开源软件.是目前公认的压缩比例最大的压缩解压软件. 主要特征: # 全新的LZMA算法加大了7z格式的压缩比 # 支持格式: * 压缩 / 解压缩:7z, XZ ...
- 爬虫(十):scrapy命令行详解
建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy startproject test1 New Scrapy pr ...
- gcc命令行详解
介绍] ----------------------------------------- 常见用法: GCC 选项 GCC 有超过100个的编译选项可用. 这些选项中的许多你可能永远都不会用到, 但 ...
随机推荐
- 什么是FastCGI, PHP-FPM
CGI,FastCGI都是一套接口标准:是编程语言(比如php,python; python里面也有wsgi)与web服务器(比如Nginx)的通信标准(比如你跟老外交流,那么FastCGI就相当于是 ...
- PHP微信分享
注意 : 分享需要认证微信订阅号或者服务号. php 代码(thinkphp): $appid='xxx'; $appsecret='xxxx'; $timestamp = time(); ...
- 冒泡排序的PHP实现
定义: 它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序错误就把他们交换过来.走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成. 排序思想:(从后往前) 比较相邻的 ...
- mysql--约束条件
主键的测试 PRIMARY KEY(PRIMARY可以省略) --查看创建表的标的定义,可以查看主键 SHOW CREATE TABLE user1; ,'king');--主键不能重复 ,'kin ...
- 使用Privoxy转化SSH到HTTP代理
为什么要进行转换? 一般我们很容易找到通过SOCKS5代理的方法,如SSH,但是很多浏览器或是软件只支持HTTP方式,所以就需要将我们的SSH代理模式转为HTTP代理方式 如何转换? 使用Privo ...
- CentOS6.5上Zabbix3.0的RPM安装【二】-汉化
六.汉化 zabbix实际是有中文语言的,我们可以通过修改web端源文件来开启中文语言.首先点击zabbix监控页面右上角管理员头像进入“用户基本资料设置页面“. 选择中文语言. 点击“Update” ...
- python解决最小二乘法的相关问题笔记。
计算最小二乘法求目标函数的系数,部分代码来源于张若愚老师的<Python科学计算> 题目 某检测装备输入数据: x:0.9, 2.5, 3.3, 4.5, 5.7, 6.9 g:1.1, ...
- loj #108. 多项式乘法
#108. 多项式乘法 题目描述 这是一道模板题. 输入两个多项式,输出这两个多项式的乘积. 输入格式 第一行两个整数 n nn 和 m mm,分别表示两个多项式的次数. 第二行 n+1 n + ...
- oracle 集群jndi部署方式
一般部署oracle jndi的方式: ...jdbc.url=jdbc:oracle:thin:@10.196.20.xx:1521:SID ... 集群部署方式 : ... jdbc.url= ...
- liunx一次安装多个软件包
https://blog.csdn.net/finded/article/details/44955953 编写shell脚本程序 一次安装多个软件,主要用于一些软件依赖环境配置. 1.shell脚本 ...