
scrapy框架的命令行解释
scrapy框架的命令解释
创建爬虫项目
scrapy startproject 项目名
例子如下:
scrapy startproject test1
这个时候爬虫的目录结构就已经创建完成了,目录结构如下:
|____scrapy.cfg

|____test1

| |______init__.py

| |____items.py

| |____middlewares.py

| |____pipelines.py

| |____settings.py

| |____spiders

| | |______init__.py
接着我们按照提示可以生成一个spider,这里以百度作为例子,生成spider的命令格式为;
scrapy genspider 爬虫名字 爬虫的网址
scrapy genspider baiduSpider baidu.com
关于命令详细使用
命令的使用范围
这里的命令分为全局的命令和项目的命令,全局的命令表示可以在任何地方使用,而项目的命令只能在项目目录下使用
全局的命令有:
startproject
genspider
settings
runspider
shell
fetch
view
version
项目命令有:
crawl
check
list
edit
parse
bench
startproject
这个命令没什么过多的用法,就是在创建爬虫项目的时候用
genspider
用于生成爬虫,这里scrapy提供给我们不同的几种模板生成spider,默认用的是basic,我们可以通过命令查看所有的模板
scrapy genspider -l
当我们创建的时候可以指定模板,不指定默认用的basic,如果想要指定模板则通过
scrapy genspider -t 模板名字
$ scrapy genspider -t crawl zhihuspider zhihu.com
crawl
这个是用去启动spider爬虫格式为:
scrapy crawl 爬虫名字
这里需要注意这里的爬虫名字和通过scrapy genspider 生成爬虫的名字是一致的
check
用于检查代码是否有错误,scrapy check
list
scrapy list列出所有可用的爬虫
fetch
scrapy fetch url地址
该命令会通过scrapy downloader 讲网页的源代码下载下来并显示出来
这里有一些参数:
--nolog 不打印日志
--headers 打印响应头信息
--no-redirect 不做跳转
view
scrapy view url地址
该命令会讲网页document内容下载下来,并且在浏览器显示出来
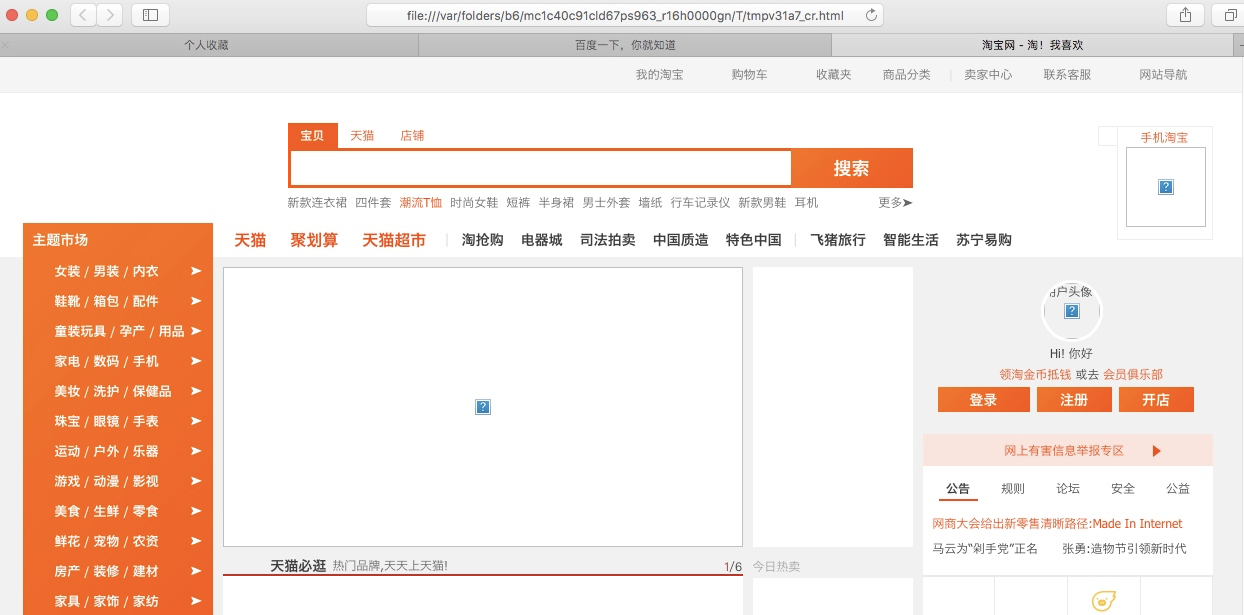
因为现在很多网站的数据都是通过ajax请求来加载的,这个时候直接通过requests请求是无法获取我们想要的数据,所以这个view命令可以帮助我们很好的判断
shell
这是一个命令行交互模式
通过scrapy shell url地址进入交互模式
这里我么可以通过css选择器以及xpath选择器获取我们想要的内容(xpath以及css选择的用法会在下个文章中详细说明),例如我们通过scrapy shell http://www.baidu.com
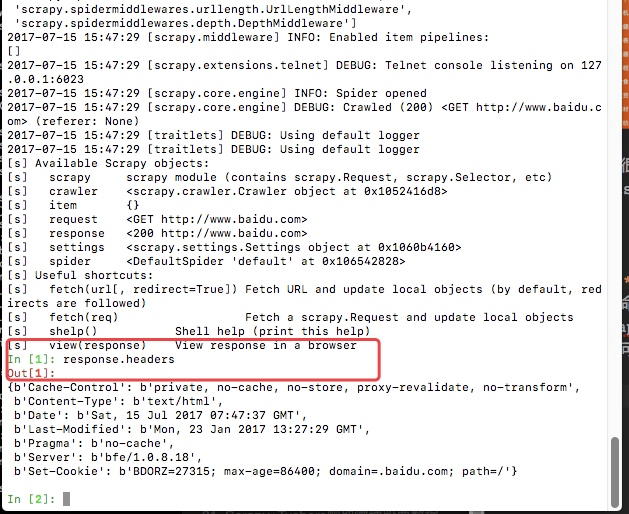
这里最后给我们返回一个response,这里的response就和我们通requests请求网页获取的数据是相同的。
view(response)会直接在浏览器显示结果
response.text 获取网页的文本
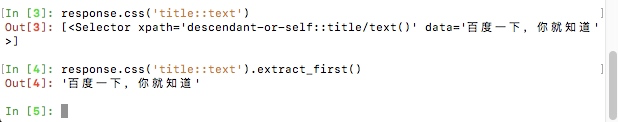
下图是css选择器的一个简单用法
settings
获取当前的配置信息
通过scrapy settings -h可以获取这个命令的所有帮助信息
scrapy settings -h
拿一个例子进行简单的演示:(这里是我的这个项目的settings配置文件中配置了数据库的相关信息,可以通过这种方式获取,如果没有获取的则为None)
scrapy settings --get=MYSQL_HOST
runspider
这个和通过crawl启动爬虫不同,这里是scrapy runspider 爬虫文件名称
所有的爬虫文件都是在项目目录下的spiders文件夹中
version
查看版本信息,并查看依赖库的信息
scrapy version
scrapy框架的命令行解释的更多相关文章
- Scrapy框架的命令行详解【转】
Scrapy框架的命令行详解 请给作者点赞 --> 原文链接 这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: loca ...
- Python爬虫从入门到放弃(十三)之 Scrapy框架的命令行详解
这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy start ...
- Python之爬虫(十五) Scrapy框架的命令行详解
这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy start ...
- pytest框架之命令行参数1
前言 pytest是一款强大的python自动化测试工具,可以胜任各种类型或者级别的软件测试工作.pytest提供了丰富的功能,包括assert重写,第三方插件,以及其他测试工具无法比拟的fixtur ...
- 3-----Scrapy框架的命令行详解
创建爬虫项目 scrapy startproject 项目名 例子如下: E:\crawler>scrapy startproject test1 New Scrapy project 'tes ...
- Python测试框架pytest命令行参数用法
在Shell执行pytest -h可以看到pytest的命令行参数有这10大类,共132个 序号 类别 中文名 包含命令行参数数量 1 positional arguments 形参 1 2 gene ...
- pytest框架之命令行参数2
前言 上篇博客说到命令行执行测试用例的部分参数如何使用?今天将继续更新其他一些命令选项的使用,和pytest收集测试用例的规则! pytest执行用例命令行参数 --collect-only:罗列出所 ...
- suricata 命令行解释【转】
suricata命令行 转载地址:http://blog.sina.com.cn/s/blog_6f8edcde0101gcha.html suricata命令行选项说明 你能两种方式使用命令行选项, ...
- cli框架 获取 命令行 参数
package main import ( "fmt" "log" "os" "github.com/urfave/cli&quo ...
随机推荐
- Codeforces Round #371 (Div. 2) C. Sonya and Queries —— 二进制压缩
题目链接:http://codeforces.com/contest/714/problem/C C. Sonya and Queries time limit per test 1 second m ...
- 脚踏实地学C#1-基元类型
基元类型:编译器直接支持的数据类型 基元类型直接映射到FCL类库上,如int 和Int32是等价的,只不过是int是c#提供的,Int32是FCL类库提供的. int只是Int32的别名 using ...
- Linux_基于Docker快速搭建个人博客网站
时间:2017年04月28日星期五 说明:基于docker技术,使用jpress开源框架搭建个人博客网站.特别感谢jpress开源项目.系统版本:CentOS 7.2-64bit. 步骤一:准备Doc ...
- MySQL丨分页查询
直奔主题 一.sql语句:select * from table limit startPageNum,everyPageNum 1)语句解析: table:你要查询的表 startPageNum:从 ...
- 最小点覆盖 hdu--1054
点击打开题目链接 最小点覆盖=最大二分匹配的 (单向图) ; 最小点覆盖=最大二分匹配的一半 (双向图) ; 证明 所以我们只需求最大匹配,用 匈牙利算法 求出最大匹配,除以二得到答案 具体算法都已经 ...
- 搜索算法 pots
题目链接 点击打开链接 Pots Time Limit: 1000MS Memory Limit: 65536KB 64bit IO Format: %I64d & %I64u Su ...
- liunx环境下安装tomcat
第一:下载tomcat的安装包
- 一个轻量级AOP的实现(开源)
事先声明,本项目参考AOP in C#和园内大神张逸的文章,思路神马的都不是自己的! 为了让项目的代码看起来更干净,需要一个AOP! 于是就实现了一个非常简单的,非常轻量级,有多轻量级呢? 实现的AO ...
- Docker 与 宿主机之间的文件cp
Docker 与 宿主机之间的文件cp 第一种方法是官方比较推荐的,其实和第二种方法实现是一样的. 第一种方法例: 将主机/www/runoob目录拷贝到容器96f7f14e99ab的/www目录下. ...
- PHP参数类型
class User{ public $name; public $password; function __construct($name,$password){ ...