
Python之爬虫(十五) Scrapy框架的命令行详解
这篇文章主要是对的scrapy命令行使用的一个介绍
创建爬虫项目
scrapy startproject 项目名
例子如下:
localhost:spider zhaofan$ scrapy startproject test1

New Scrapy project 'test1', using template directory '/Library/Frameworks/Python.framework/Versions/3.5/lib/python3.5/site-packages/scrapy/templates/project', created in:

    /Users/zhaofan/Documents/python_project/spider/test1

You can start your first spider with:

    cd test1

    scrapy genspider example example.com

localhost:spider zhaofan$
这个时候爬虫的目录结构就已经创建完成了,目录结构如下:
|____scrapy.cfg

|____test1

| |______init__.py

| |____items.py

| |____middlewares.py

| |____pipelines.py

| |____settings.py

| |____spiders

| | |______init__.py
接着我们按照提示可以生成一个spider,这里以百度作为例子,生成spider的命令格式为;
scrapy genspider 爬虫名字 爬虫的网址
localhost:test1 zhaofan$ scrapy genspider baiduSpider baidu.com

Created spider 'baiduSpider' using template 'basic' in module:

  test1.spiders.baiduSpider

localhost:test1 zhaofan$
关于命令详细使用
命令的使用范围
这里的命令分为全局的命令和项目的命令,全局的命令表示可以在任何地方使用,而项目的命令只能在项目目录下使用
全局的命令有:
startproject
genspider
settings
runspider
shell
fetch
view
version
项目命令有:
crawl
check
list
edit
parse
bench
startproject
这个命令没什么过多的用法,就是在创建爬虫项目的时候用
genspider
用于生成爬虫,这里scrapy提供给我们不同的几种模板生成spider,默认用的是basic,我们可以通过命令查看所有的模板
localhost:test1 zhaofan$ scrapy genspider -l

Available templates:

  basic

  crawl

  csvfeed

  xmlfeed

localhost:test1 zhaofan$
当我们创建的时候可以指定模板,不指定默认用的basic,如果想要指定模板则通过
scrapy genspider -t 模板名字
localhost:test1 zhaofan$ scrapy genspider -t crawl zhihuspider zhihu.com

Created spider 'zhihuspider' using template 'crawl' in module:

  test1.spiders.zhihuspider

localhost:test1 zhaofan$
crawl
这个是用去启动spider爬虫格式为:
scrapy crawl 爬虫名字
这里需要注意这里的爬虫名字和通过scrapy genspider 生成爬虫的名字是一致的
check
用于检查代码是否有错误,scrapy check
list
scrapy list列出所有可用的爬虫
fetch
scrapy fetch url地址
该命令会通过scrapy downloader 讲网页的源代码下载下来并显示出来
这里有一些参数:
--nolog 不打印日志
--headers 打印响应头信息
--no-redirect 不做跳转
view
scrapy view url地址
该命令会讲网页document内容下载下来,并且在浏览器显示出来
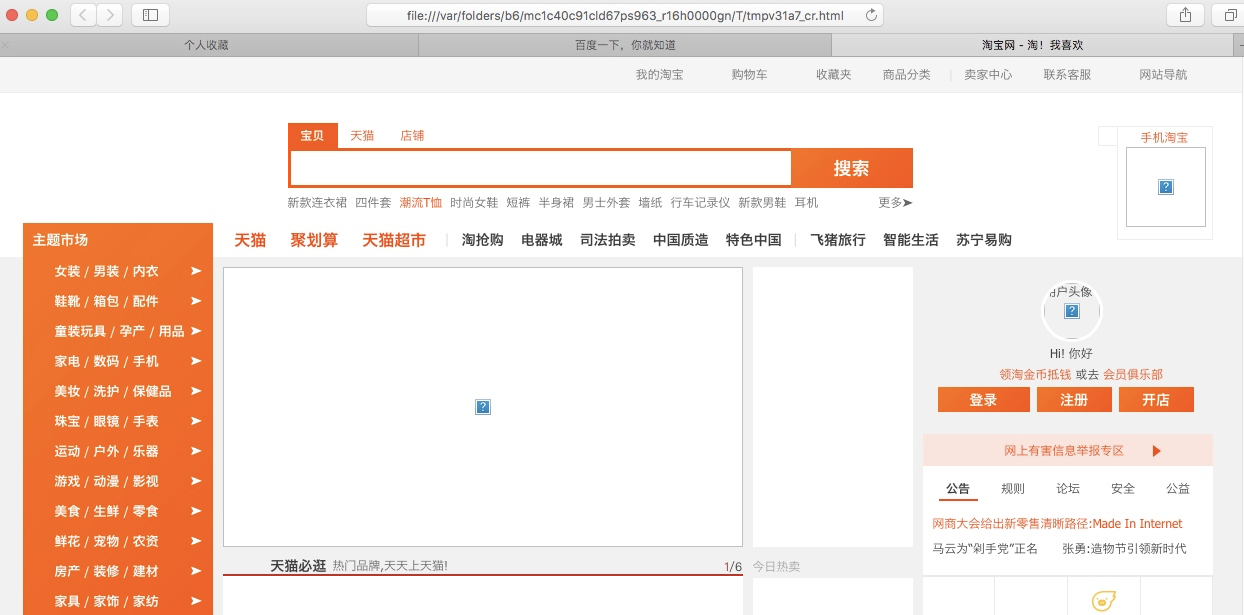
因为现在很多网站的数据都是通过ajax请求来加载的,这个时候直接通过requests请求是无法获取我们想要的数据,所以这个view命令可以帮助我们很好的判断
shell
这是一个命令行交互模式
通过scrapy shell url地址进入交互模式
这里我么可以通过css选择器以及xpath选择器获取我们想要的内容(xpath以及css选择的用法会在下个文章中详细说明),例如我们通过scrapy shell http://www.baidu.com
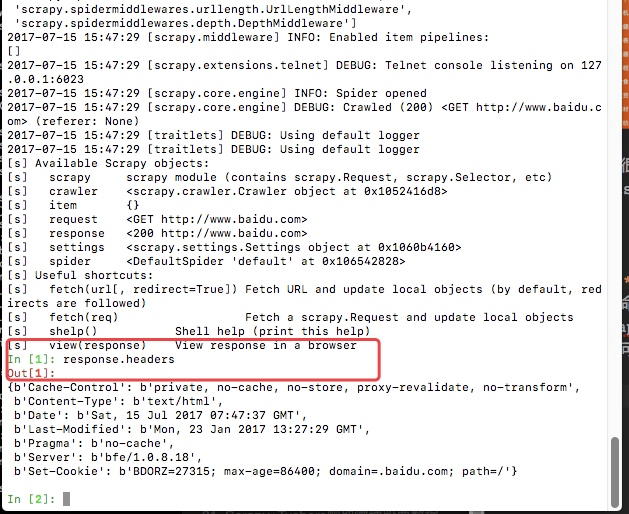
这里最后给我们返回一个response,这里的response就和我们通requests请求网页获取的数据是相同的。
view(response)会直接在浏览器显示结果
response.text 获取网页的文本
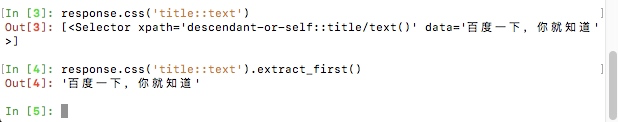
下图是css选择器的一个简单用法
settings
获取当前的配置信息
通过scrapy settings -h可以获取这个命令的所有帮助信息
localhost:jobboleSpider zhaofan$ scrapy settings -h

Usage

=====

  scrapy settings [options]

Get settings values

Options

=======

--help, -h              show this help message and exit

--get=SETTING           print raw setting value

--getbool=SETTING       print setting value, interpreted as a boolean

--getint=SETTING        print setting value, interpreted as an integer

--getfloat=SETTING      print setting value, interpreted as a float

--getlist=SETTING       print setting value, interpreted as a list

Global Options

--------------

--logfile=FILE          log file. if omitted stderr will be used

--loglevel=LEVEL, -L LEVEL

                        log level (default: DEBUG)

--nolog                 disable logging completely

--profile=FILE          write python cProfile stats to FILE

--pidfile=FILE          write process ID to FILE

--set=NAME=VALUE, -s NAME=VALUE

                        set/override setting (may be repeated)

--pdb                   enable pdb on failure
拿一个例子进行简单的演示:(这里是我的这个项目的settings配置文件中配置了数据库的相关信息,可以通过这种方式获取,如果没有获取的则为None)
localhost:jobboleSpider zhaofan$ scrapy settings --get=MYSQL_HOST

192.168.1.18

localhost:jobboleSpider zhaofan$
runspider
这个和通过crawl启动爬虫不同,这里是scrapy runspider 爬虫文件名称
所有的爬虫文件都是在项目目录下的spiders文件夹中
version
查看版本信息,并查看依赖库的信息
localhost:~ zhaofan$ scrapy version

Scrapy 1.3.2

localhost:~ zhaofan$ scrapy version -v

Scrapy    : 1.3.2

lxml      : 3.7.3.0

libxml2   : 2.9.4

cssselect : 1.0.1

parsel    : 1.1.0

w3lib     : 1.17.0

Twisted   : 17.1.0

Python    : 3.5.2 (v3.5.2:4def2a2901a5, Jun 26 2016, 10:47:25) - [GCC 4.2.1 (Apple Inc. build 5666) (dot 3)]

pyOpenSSL : 16.2.0 (OpenSSL 1.0.2k  26 Jan 2017)

Platform  : Darwin-16.6.0-x86_64-i386-64bit
Python之爬虫(十五) Scrapy框架的命令行详解的更多相关文章
- Scrapy框架的命令行详解【转】
Scrapy框架的命令行详解 请给作者点赞 --> 原文链接 这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: loca ...
- Python爬虫从入门到放弃(十三)之 Scrapy框架的命令行详解
这篇文章主要是对的scrapy命令行使用的一个介绍 创建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy start ...
- 3-----Scrapy框架的命令行详解
创建爬虫项目 scrapy startproject 项目名 例子如下: E:\crawler>scrapy startproject test1 New Scrapy project 'tes ...
- scrapy框架的命令行解释
scrapy框架的命令解释 创建爬虫项目 scrapy startproject 项目名例子如下: scrapy startproject test1 这个时候爬虫的目录结构就已经创建完成了,目录结构 ...
- PYTHON网络爬虫与信息提取[scrapy框架应用](单元十、十一)
scrapy 常用命令 startproject 创建一个新的工程 scrapy startproject <name>[dir] genspider 创建一个爬虫 ...
- 爬虫基础(五)-----scrapy框架简介
---------------------------------------------------摆脱穷人思维 <五> :拓展自己的视野,适当做一些眼前''无用''的事情,防止进入只关 ...
- 爬虫(十):scrapy命令行详解
建爬虫项目 scrapy startproject 项目名例子如下: localhost:spider zhaofan$ scrapy startproject test1 New Scrapy pr ...
- python 学习笔记十五 web框架
python Web程序 众所周知,对于所有的Web应用,本质上其实就是一个socket服务端,用户的浏览器其实就是一个socket客户端. Python的WEB框架分为两类: 自己写socket,自 ...
- python接口自动化(二十五)--unittest断言——下(详解)
简介 本篇还是回归到我们最初始的话题,想必大家都忘记了,没关系看这里:传送门 没错最初的话题就是登录,由于博客园的登录机制改变了,本篇以我找到的开源免费的登录API为案例,结合 unittest 框 ...
随机推荐
- asp.net Mvc 路由详解,非常详细.
关于路由的理解 为什么要定义路由?路由的定义在开发中的工作量非常小,但是非常重要,因为任何请求都离不开路由. 各个电商网站的 URL 使用非常灵活,都离不开路由的定义,请大家参考几家电商的 URL 如 ...
- (三)解决httpclient乱码
原文链接:https://blog.csdn.net/justry_deng/article/details/81042379
- usb串口的作用以及JLINK
usb串口的作用 (1)可以当串口使用 (2)如果usb串口连接到STM32的串口1(stm32ISP下载只能是串口1),可以用串口下载程序 (3)因为要连接到usb,可以用来供电 JLINK JLI ...
- 如何用Python从海量文本抽取主题?
摘自https://www.jianshu.com/p/fdde9fc03f94 你在工作.学习中是否曾因信息过载叫苦不迭?有一种方法能够替你读海量文章,并将不同的主题和对应的关键词抽取出来,让你谈笑 ...
- GitHub如何回滚代码?
1.git log 查看commit hash值 执行git log:查看commit hash值. 2.执行git reset --hard xxxx xxxx表示的是commit hash 值. ...
- 4.WebPack-Loader
一.什么是Loader WebPack默认只"认识"以*.js结尾的文件,如果想处理其他类型的文件,就必须添加Loader,有各种各样的Loader,每个Loader可处理不同类型 ...
- Jmeter之仿真高并发测试-集合点
场景: 大家在使用Jmeter测试的时候应该发现了, (1)线程启动了就会直接发送测试请求:--如果要模拟在一瞬间高并发量测试的时候,需要调高线程数量,这很耗测试机器的性能,往往无法支持较大的并发数, ...
- shell编程之系统环境变量2
本课程是<Tony老师聊shell——变量>课程的延续,主要介绍Linux shell编程基础中的运算符.包括declare命令.数值运算方法和变量测试.首先在declare命令中介绍了数 ...
- 【初识Redis】
1. 前言 1.1 Reis是什么 Redis 是 C 语言开发的一个开源的(遵从 BSD 协议)高性能键值对(key-value)的 NoSQL的内存数据库,可以用作缓存.消息中间件等:具有以下 ...
- Haproxy/LVS负载均衡实现+keepalived实现高可用
haproxy+keepalived 集群高可用集群转发 环境介绍 #内核版本 Ubuntu 18.04.4 LTS \n \l 107-Ubuntu SMP Thu Jun 4 11:27:52 U ...