
ML.NET 示例:二元分类之用户评论的情绪分析
写在前面
准备近期将微软的machinelearning-samples翻译成中文,水平有限,如有错漏,请大家多多指正。
如果有朋友对此感兴趣,可以加入我:https://github.com/feiyun0112/machinelearning-samples.zh-cn
用户评论的情绪分析
| ML.NET 版本 | API 类型 | 状态 | 应用程序类型 | 数据类型 | 场景 | 机器学习任务 | 算法 |
|---|---|---|---|---|---|---|---|
| v0.7 | 动态API | README.md 已更新 | 控制台应用程序 | .tsv 文件 | 情绪分析 | 二元分类 | 线性分类 |
在这个介绍性示例中,您将看到如何使用ML.NET预测客户评论的情绪(积极或消极)。在机器学习领域中,这种类型的预测被称为二元分类。
问题
这个问题集中在预测客户的评论是否具有正面或负面情绪。我们将使用小型的wikipedia-detox-datasets(一个用于训练的数据集,一个用于模型的准确性评估的数据集),这些数据集已经由人工处理过,并且每个评论都被分配了一个情绪标签:
- 0 - 好评/正面
- 1 - 差评/负面
我们将使用这些数据集构建一个模型,在预测时将分析字符串并预测情绪值为0或1。
机器学习任务 - 二元分类
二元分类一般用于将项目分类为两个类中的一个的问题(将项目分类为两个以上的类称为多类分类)。
- 预测保险索赔是否有效。
- 预测飞机是否会延误或将准时到达。
- 预测face ID(照片)是否属于设备的所有者。
所有这些示例的共同特征是我们想要预测的参数只能采用两个值中的一个。 换句话说,该值由 boolean 类型表示。
解决方案
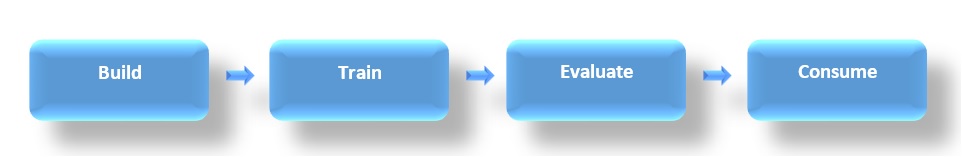
要解决这个问题,首先我们将建立一个机器学习模型。然后,我们将在现有数据上训练模型,评估其有多好,最后我们将使用该模型来预测新评论的情绪。
1. 建立模型
建立模型包括:
定义映射到数据集的数据架构,以便用DataReader读取(“wikipedia-detox-250-line-data.tsv”和“wikipedia-detox-250-line-test.tsv”)
创建一个评估器,并将数据转换为数值向量,以便它能够被机器学习算法有效地使用(使用“FeaturizeText”)
选择训练器/学习算法(如“FastTree”)来训练模型。
初始代码类似以下内容:
// STEP 1: Common data loading configuration
TextLoader textLoader = mlContext.Data.TextReader(new TextLoader.Arguments()
                                        {
                                            Separator = "tab",
                                            HasHeader = true,
                                            Column = new[]
                                                        {
                                                        new TextLoader.Column("Label", DataKind.Bool, 0),
                                                        new TextLoader.Column("Text", DataKind.Text, 1)
                                                        }
                                        });
IDataView trainingDataView = textLoader.Read(TrainDataPath);
IDataView testDataView = textLoader.Read(TestDataPath);

// STEP 2: Common data process configuration with pipeline data transformations
var dataProcessPipeline = mlContext.Transforms.Text.FeaturizeText("Text", "Features");

// STEP 3: Set the training algorithm, then create and config the modelBuilder
var trainer = mlContext.BinaryClassification.Trainers.FastTree(labelColumn: "Label", featureColumn: "Features");
var trainingPipeline = dataProcessPipeline.Append(trainer);
2. 训练模型
训练模型是在训练数据(具有已知情绪值)上运行所选算法以调整模型参数的过程。它是在评估器对象的 Fit() 方法中实现。
为了执行训练,您需要在DataView对象中提供了训练数据集(wikipedia-detox-250-line-data.tsv文件)后调用 Fit() 方法。
ITransformer trainedModel = trainingPipeline.Fit(trainingDataView);请注意,ML.NET使用延迟加载方式处理数据,所以在实际调用.Fit()方法之前,没有任何数据真正加载到内存中。
3. 评估模型
我们需要这一步骤来判定我们的模型对新数据的准确性。 为此,上一步中的模型再次针对另一个未在训练中使用的数据集(wikipedia-detox-250-line-test.tsv)运行。 此数据集也包含了已知的情绪。
Evaluate()比较测试数据集的预测值,并生成各种指标,例如准确性,您可以对其进行浏览。
var predictions = trainedModel.Transform(testDataView);
var metrics = mlContext.BinaryClassification.Evaluate(predictions, "Label", "Score");

ConsoleHelper.PrintBinaryClassificationMetrics(trainer.ToString(), metrics);
如果您对模型的质量不满意,可以通过提供更大的训练数据集,并为每个算法选择具有不同超参数的不同训练算法来尝试改进它。
请记住,对于这个示例,它的质量会低于可能的质量,因为数据集很小,以便可以很快地训练。您应该使用更大的已标记情绪的数据集来显著提高模型的质量。
4. 使用模型
训练完模型后,您可以使用Predict()API来预测新示例文本的情绪。
// Create prediction engine related to the loaded trained model
var predFunction= trainedModel.MakePredictionFunction<SentimentIssue, SentimentPrediction>(mlContext);

//Score
var resultprediction = predFunction.Predict(sampleStatement);其中resultprediction.PredictionLabel将为True或False,具体取决于它是否被预测为负面或正面的情绪。
ML.NET 示例:二元分类之用户评论的情绪分析的更多相关文章
- ML.NET 示例:目录
ML.NET 示例中文版:https://github.com/feiyun0112/machinelearning-samples.zh-cn 英文原版请访问:https://github.com/ ...
- ML.NET 示例:二元分类之信用卡欺诈检测
写在前面 准备近期将微软的machinelearning-samples翻译成中文,水平有限,如有错漏,请大家多多指正. 如果有朋友对此感兴趣,可以加入我:https://github.com/fei ...
- ML.NET 示例:二元分类之垃圾短信检测
写在前面 准备近期将微软的machinelearning-samples翻译成中文,水平有限,如有错漏,请大家多多指正. 如果有朋友对此感兴趣,可以加入我:https://github.com/fei ...
- ML.NET教程之情感分析(二元分类问题)
机器学习的工作流程分为以下几个步骤: 理解问题 准备数据 加载数据 提取特征 构建与训练 训练模型 评估模型 运行 使用模型 理解问题 本教程需要解决的问题是根据网站内评论的意见采取合适的行动. 可用 ...
- ML.NET 示例:多类分类之鸢尾花分类
写在前面 准备近期将微软的machinelearning-samples翻译成中文,水平有限,如有错漏,请大家多多指正. 如果有朋友对此感兴趣,可以加入我:https://github.com/fei ...
- 机器学习框架ML.NET学习笔记【2】入门之二元分类
一.准备样本 接上一篇文章提到的问题:根据一个人的身高.体重来判断一个人的身材是否很好.但我手上没有样本数据,只能伪造一批数据了,伪造的数据比较标准,用来学习还是蛮合适的. 下面是我用来伪造数据的代码 ...
- 【ML系列】简单的二元分类——Logistic回归
对于了解机器学习中二元分类问题的来源与分析,我认为王树义老师这篇文章讲的非常好,通俗且易懂: http://blog.sciencenet.cn/blog-377709-1121098.html 但王 ...
- ML.NET 示例:开篇
写在前面 准备近期将微软的machinelearning-samples翻译成中文,水平有限,如有错漏,请大家多多指正. 如果有朋友对此感兴趣,可以加入我:https://github.com/fei ...
- ML.NET 示例:推荐之矩阵分解
写在前面 准备近期将微软的machinelearning-samples翻译成中文,水平有限,如有错漏,请大家多多指正. 如果有朋友对此感兴趣,可以加入我:https://github.com/fei ...
随机推荐
- linux 下的ssh
ssh服务 1.检查是否有被安装,命令 rpm -qa|grep "ssh" 2.检查ssh有没有在运行,命令 rpm -qa|grep "ssh" 3.如何启 ...
- 大表分批删除脚本之MySQL版
经常需要定期对某些表删除历史数据,通常这样的表的数据又是非常巨大,为了减轻对线上环境的影响,删除时必须分成小批量来进行. 以前分享过SQLServer的版本. 下面是MySQL版本: delimite ...
- C#语言————第四章 常用Convert类的类型转换方法
方法 说明Convert.ToInt32() 转换为整型(int 型)Convert.ToStringle() 转换为单精度浮点型(float 型)Convert.ToDouble() 转换为双精度 ...
- CentOS7查询系统版本内核信息
1. 查看版本号 查看CentOS的版本号命令: [root@localhost ~]# cat /etc/centos-releaseCentOS Linux release 7.4.1708 (C ...
- Win7系统system进程句柄数一直增加解决方案
公司内部最近有个服务端的同事电脑句柄数一开机就一直增加 一台Windows7x64系统16G 其实物理内存使用情况在开机后并没有太大的变化,但虚拟内存占用明显在不停的增加. 我通过“任务管理器”一直也 ...
- Shell脚本应用(if语句的结构)
1.测试:检测表达式是否成立,成立则返回值为0,否则为非0 方法: 1)test 表达式 2)[ 表达式 ] 2.文件测试: -d:是否为目录 -f:是否为文件 -e:是否存在 -r:是否有读取权限 ...
- 17秋 软件工程 第二次作业 sudoku
2017年秋季 软件工程 作业2:个人项目 sudoku Github Project Github Project at Wasdns/sudoku. PSP Table PSP2.1 Person ...
- Java链式方法
http://blog.csdn.net/lemon_shenzhen/article/details/6358537 有两种情况可运用链式方法: 第一种 除最后一个方法外,每个方法都返回一个对象 ...
- 最长公共子序列(模板 LCSL)
博客: https://www.cnblogs.com/sasuke-/p/5396843.html 模板 #include<iostream>#include<cstdio> ...
- 【转】.htaccess详解及.htaccess参数说明
.htaccess文件(或者”分布式配置文件”)提供了针对目录改变配置的方法, 即,在一个特定的文档目录中放置一个包含一个或多个指令的文件, 以作用于此目录及其所有子目录.作为用户,所能使用的命令受到 ...