
机器学习框架ML.NET学习笔记【2】入门之二元分类
一、准备样本
接上一篇文章提到的问题:根据一个人的身高、体重来判断一个人的身材是否很好。但我手上没有样本数据,只能伪造一批数据了,伪造的数据比较标准,用来学习还是蛮合适的。
下面是我用来伪造数据的代码:
           string Filename = "./figure_full.csv";

            StreamWriter sw = new StreamWriter(Filename, false);

            sw.WriteLine("Height,Weight,Result");

            Random random = new Random();

            float height, weight;

            Result result;

            for (int i = ; i < ; i++)

            {

                height = random.Next(, );

                weight = random.Next(, );

                if (height >  && weight < )

                    result = Result.Good;

                else

                    result = Result.Bad;

                sw.WriteLine($"{height},{weight},{(int)result}");

            }

   enum Result

    {

        Bad=,

        Good=

    }
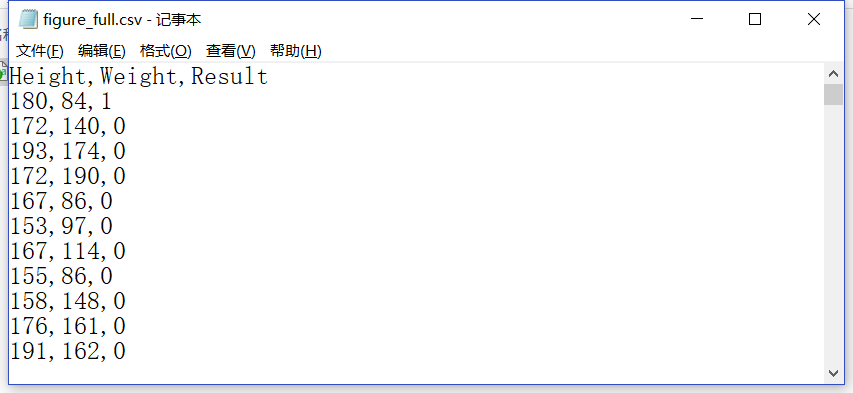
制造成功后的数据如下:

用记事本打开:
二、源码
数据准备好了,我们就用准备好的数据进行学习了,先贴出全部代码,然后再逐一解释:
namespace BinaryClassification_Figure

{

    class Program

    {

        static readonly string DataPath = Path.Combine(Environment.CurrentDirectory, "Data", "figure_full.csv");

        static readonly string ModelPath = Path.Combine(Environment.CurrentDirectory, "Data", "FastTree_Model.zip");

        static void Main(string[] args)

        {

            TrainAndSave();

            LoadAndPrediction();

            Console.WriteLine("Press any to exit!");

            Console.ReadKey();

        }

        static void TrainAndSave()

        {

            MLContext mlContext = new MLContext();

            //准备数据

            var fulldata = mlContext.Data.LoadFromTextFile<FigureData>(path: DataPath, hasHeader: true, separatorChar: ',');

            var trainTestData = mlContext.Data.TrainTestSplit(fulldata,testFraction:0.2);

            var trainData = trainTestData.TrainSet;

            var testData = trainTestData.TestSet;

            //训练

            IEstimator<ITransformer> dataProcessPipeline = mlContext.Transforms.Concatenate("Features", new[] { "Height", "Weight" })

                .Append(mlContext.Transforms.NormalizeMeanVariance(inputColumnName: "Features", outputColumnName: "FeaturesNormalizedByMeanVar"));

            IEstimator<ITransformer> trainer = mlContext.BinaryClassification.Trainers.FastTree(labelColumnName: "Result", featureColumnName: "FeaturesNormalizedByMeanVar");

            IEstimator<ITransformer> trainingPipeline = dataProcessPipeline.Append(trainer);

            ITransformer model = trainingPipeline.Fit(trainData);

            //评估

            var predictions = model.Transform(testData);

            var metrics = mlContext.BinaryClassification.Evaluate(data: predictions, labelColumnName: "Result", scoreColumnName: "Score");

            PrintBinaryClassificationMetrics(trainer.ToString(), metrics);

            //保存模型

            mlContext.Model.Save(model, trainData.Schema, ModelPath);

            Console.WriteLine($"Model file saved to :{ModelPath}");

        }

        static void LoadAndPrediction()

        {

            var mlContext = new MLContext();

            ITransformer model = mlContext.Model.Load(ModelPath, out var inputSchema);

            var predictionEngine = mlContext.Model.CreatePredictionEngine<FigureData, FigureDatePredicted>(model);

            FigureData test = new FigureData();

            test.Weight = ;

            test.Height = ;

            var prediction = predictionEngine.Predict(test);

            Console.WriteLine($"Predict Result :{prediction.PredictedLabel}");

        }

    }

    public class FigureData

    {

        [LoadColumn()]

        public float Height { get; set; }

        [LoadColumn()]

        public float Weight { get; set; }

        [LoadColumn()]

        public bool Result { get; set; }

    }

    public class FigureDatePredicted : FigureData

    {

        public bool PredictedLabel;

    }

}
三、对代码的解释
1、读取样本数据
        string DataPath = Path.Combine(Environment.CurrentDirectory, "Data", "figure_full.csv");

        MLContext mlContext = new MLContext();

            //准备数据

            var fulldata = mlContext.Data.LoadFromTextFile<FigureData>(path: DataPath, hasHeader: true, separatorChar: ',');

            var trainTestData = mlContext.Data.TrainTestSplit(fulldata,testFraction:0.2);

            var trainData = trainTestData.TrainSet;

            var testData = trainTestData.TestSet;
LoadFromTextFile<FigureData>(path: DataPath, hasHeader: true, separatorChar: ',')用来读取数据到DataView
FigureData类是和样本数据对应的实体类,LoadColumn特性指示该属性对应该条数据中的第几个数据。
    public class FigureData

    {

        [LoadColumn()]

        public float Height { get; set; }

        [LoadColumn()]

        public float Weight { get; set; }

        [LoadColumn()]

        public bool Result { get; set; }

    }
path:文件路径
hasHeader:文本文件是否包含标题
separatorChar:用来分割数据的字符,我们用的是逗号,常用的还有跳格符‘\t’
TrainTestSplit(fulldata,testFraction:0.2)用来随机分割数据,分成学习数据和评估用的数据,通常情况,如果数据较多,测试数据取20%左右比较合适,如果数据量较少,测试数据取10%左右比较合适。
如果不通过分割,准备两个数据文件,一个用来训练、一个用来评估,效果是一样的。
2、训练
            //训练

            IEstimator<ITransformer> dataProcessPipeline = mlContext.Transforms.Concatenate("Features", new[] { "Height", "Weight" })

                .Append(mlContext.Transforms.NormalizeMeanVariance(inputColumnName: "Features", outputColumnName: "FeaturesNormalizedByMeanVar"));

            IEstimator<ITransformer> trainer = mlContext.BinaryClassification.Trainers.FastTree(labelColumnName: "Result", featureColumnName: "FeaturesNormalizedByMeanVar");

            IEstimator<ITransformer> trainingPipeline = dataProcessPipeline.Append(trainer);

            ITransformer model = trainingPipeline.Fit(trainData);
IDataView这个数据集就类似一个表格,它的列(Column)是可以动态增加的,一开始我们通过LoadFromTextFile获得的数据集包括:Height、Weight、Result这几个列,在进行训练之前,我们还要对这个数据集进行处理,形成符合我们要求的数据集。
Concatenate这个方法是把多个列,组合成一个列,因为二元分类的机器学习算法只接收一个特征列,所以要把多个特征列(Height、Weight)组合成一个特征列Features(组合的结果应该是个float数组)。
NormalizeMeanVariance是对列进行归一化处理,这里输入列为:Features,输出列为:FeaturesNormalizedByMeanVar,归一化的含义见本文最后一节介绍。
数据集就绪以后,就要选择学习算法,针对二元分类,我们选择了快速决策树算法FastTree,我们需要告诉这个算法特征值放在哪个列里面(FeaturesNormalizedByMeanVar),标签值放在哪个列里面(Result)。
链接数据处理管道和算法形成学习管道,将数据集中的数据逐一通过学习管道进行学习,形成机器学习模型。
有了这个模型我们就可以通过它进行实际应用了。但我们一般不会现在就使用这个模型,我们需要先评估一下这个模型,然后把模型保存下来。以后应用时再通过文件读取出模型,然后进行应用,这样就不用等待学习的时间了,通常学习的时间都比较长。
3、评估
            //评估

            var predictions = model.Transform(testData);

            var metrics = mlContext.BinaryClassification.Evaluate(data: predictions, labelColumnName: "Result");

            PrintBinaryClassificationMetrics(trainer.ToString(), metrics);
评估的过程就是对测试数据集进行批量转换(Transform),转换过的数据集会多出一个“PredictedLabel”的列,这个就是模型评估的结果,逐条将这个结果和实际结果(Result)进行比较,就最终形成了效果评估数据。
我们可以打印这个评估结果,查看其成功率,一般成功率大于97%就是比较好的模型了。由于我们伪造的数据比较整齐,所以我们这次评估的成功率为100%。
注意:评估过程不会提升现有的模型能力,只是对现有模型的一种检测。
4、保存模型
//保存模型

           string ModelPath = Path.Combine(Environment.CurrentDirectory, "Data", "FastTree_Model.zip");

            mlContext.Model.Save(model, trainData.Schema, ModelPath);

            Console.WriteLine($"Model file saved to :{ModelPath}");
这个没啥好解释的。
5、读取模型并创建预测引擎
           //读取模型

            var mlContext = new MLContext();

            ITransformer model = mlContext.Model.Load(ModelPath, out var inputSchema);

            //创建预测引擎

            var predictionEngine = mlContext.Model.CreatePredictionEngine<FigureData, FigureDatePredicted>(model);
创建预测引擎的功能和Transform是类似的,不过Transform是处理批量记录,这里只处理一条数据,而且这里的输入输出是实体对象,定义如下:
   public class FigureData

    {

        [LoadColumn()]

        public float Height { get; set; }

        [LoadColumn()]

        public float Weight { get; set; }

        [LoadColumn()]

        public bool Result { get; set; }

    }

    public class FigureDatePredicted : FigureData

    {

        public bool PredictedLabel;

    }
由于预测结果里放在“PredictedLabel”字段中,所以FigureDatePredicted类必须要包含PredictedLabel属性,目前FigureDatePredicted 类是从FigureData类继承的,由于我们只用到PredictedLabel属性,所以不继承也没有关系,如果继承的话,后面要调试的话会方便一点。
6、应用
            FigureData test = new FigureData

            {

                Weight = ,

                Height =

            };

            var prediction = predictionEngine.Predict(test);

            Console.WriteLine($"Predict Result :{prediction.PredictedLabel}");
这部分代码就比较简单,test是我们要预测的对象,预测后打印出预测结果。
四、附:数据归一化
机器学习的算法中一般会有很多的乘法运算,当运算的数字过大时,很容易在多次运算后溢出,为了防止这种情况,就要对数据进行归一化处理。归一化的目标就是把参与运算的特征数变为(0,1)或(-1,1)之间的浮点数,常见的处理方式有:min-max标准化、Log函数转换、对数函数转换等。
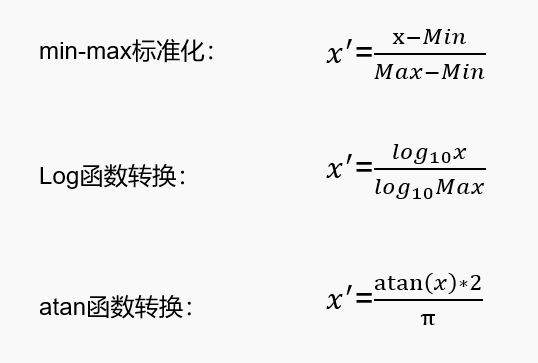
我们这次采用的是平均方差归一化方法。
五、资源
源码下载地址:https://github.com/seabluescn/Study_ML.NET
工程名称:BinaryClassification_Figure
机器学习框架ML.NET学习笔记【2】入门之二元分类的更多相关文章
- 机器学习框架ML.NET学习笔记【4】多元分类之手写数字识别
一.问题与解决方案 通过多元分类算法进行手写数字识别,手写数字的图片分辨率为8*8的灰度图片.已经预先进行过处理,读取了各像素点的灰度值,并进行了标记. 其中第0列是序号(不参与运算).1-64列是像 ...
- 机器学习框架ML.NET学习笔记【5】多元分类之手写数字识别(续)
一.概述 上一篇文章我们利用ML.NET的多元分类算法实现了一个手写数字识别的例子,这个例子存在一个问题,就是输入的数据是预处理过的,很不直观,这次我们要直接通过图片来进行学习和判断.思路很简单,就是 ...
- 机器学习框架ML.NET学习笔记【1】基本概念与系列文章目录
一.序言 微软的机器学习框架于2018年5月出了0.1版本,2019年5月发布1.0版本.期间各版本之间差异(包括命名空间.方法等)还是比较大的,随着1.0版发布,应该是趋于稳定了.之前在园子里也看到 ...
- 机器学习框架ML.NET学习笔记【3】文本特征分析
一.要解决的问题 问题:常常一些单位或组织召开会议时需要录入会议记录,我们需要通过机器学习对用户输入的文本内容进行自动评判,合格或不合格.(同样的问题还类似垃圾短信检测.工作日志质量分析等.) 处理思 ...
- 机器学习框架ML.NET学习笔记【6】TensorFlow图片分类
一.概述 通过之前两篇文章的学习,我们应该已经了解了多元分类的工作原理,图片的分类其流程和之前完全一致,其中最核心的问题就是特征的提取,只要完成特征提取,分类算法就很好处理了,具体流程如下: 之前介绍 ...
- 机器学习框架ML.NET学习笔记【7】人物图片颜值判断
一.概述 这次要解决的问题是输入一张照片,输出人物的颜值数据. 学习样本来源于华南理工大学发布的SCUT-FBP5500数据集,数据集包括 5500 人,每人按颜值魅力打分,分值在 1 到 5 分之间 ...
- 机器学习框架ML.NET学习笔记【8】目标检测(采用YOLO2模型)
一.概述 本篇文章介绍通过YOLO模型进行目标识别的应用,原始代码来源于:https://github.com/dotnet/machinelearning-samples 实现的功能是输入一张图片, ...
- 机器学习框架ML.NET学习笔记【9】自动学习
一.概述 本篇我们首先通过回归算法实现一个葡萄酒品质预测的程序,然后通过AutoML的方法再重新实现,通过对比两种实现方式来学习AutoML的应用. 首先数据集来自于竞赛网站kaggle.com的UC ...
- ML.NET学习笔记 ---- 系列文章
机器学习框架ML.NET学习笔记[1]基本概念与系列文章目录 机器学习框架ML.NET学习笔记[2]入门之二元分类 机器学习框架ML.NET学习笔记[3]文本特征分析 机器学习框架ML.NET学习笔记 ...
随机推荐
- 微服务理论之五:微服务架构 vs. SOA架构
一.面向服务的架构SOA 面向服务的架构是一种软件体系结构,应用程序的不同组件通过网络上的通信协议向其他组件提供服务.通信可以是简单的数据传递,也可以是两个或多个服务彼此协调连接.这些独特的服务执行一 ...
- java web 基础 json 和 javaBean转化
github地址: https://github.com/liufeiSAP/JavaWebStudy 实体类: package com.study.demo.domain; import com.f ...
- Centos7 忘记密码的情况下,修改root或其他用户密码
转载:https://blog.csdn.net/wcy00q/article/details/70570043 应用场景 linux管理员忘记root密码,需要进行找回操作. 注意事项:本文基于ce ...
- 问题:C#时间差;结果:C# 使用TimeSpan计算两个时间差
C# 使用TimeSpan计算两个时间差 可以加两个日期之间任何一个时间单位. private string DateDiff(DateTime DateTime1, DateTime DateTim ...
- hive 连接查询sql对比效率
准备4个表 从mysql 导出excel 转换为txt 创建hive 表的导入文件 create table bdqn_student( sno int, sname string, sbirthda ...
- C/C++常用数学函数
math.h/cmath(C++)数学函数库 1 三角函数 double sin (double); double cos (double); double tan (double) ...
- SharePoint 2013 搜索高级配置
SharePoint2013里面的搜索配置. 1.首先,新建页面,用于搜索, 2.添加搜索框.搜索结果部件: 选择<搜索>类别,找到”搜索框”.”搜索结果”两个部件,添加到页面: 3.配置 ...
- EchoServer和EchoClient模型的改进1之多线程
在之前的EchoServer模型个EchoClient模型中,客户端和服务端只是单纯的一一对应的关系,如果存在多个客户端和一个服务端,这就需要具体处理了.在这里我们明显想到的第一种方案是使用多线程处理 ...
- Spring开发环境搭建
----------------siwuxie095 Spring 是运行在 Java 环境下的开发框架,因此在开发前需要 准备以下相关软件: JDK 7 或者以上版本 Eclipse 4 或以上版本 ...
- Shrio00 Shiro角色授权、Shiro权限授权、开启Shiro缓存
1 需求01 用户进行过认证登录后,某些接口是有权限限制的:如何实现只有相应权限的用户才可以调用相应接口 2 修改shiro配置类 ShiroConfiguration package cn.xia ...