
[Spark内核] 第31课:Spark资源调度分配内幕天机彻底解密:Driver在Cluster模式下的启动、两种不同的资源调度方式源码彻底解析、资源调度内幕总结
本課主題
- Master 资源调度的源码鉴赏
[引言部份:你希望读者看完这篇博客后有那些启发、学到什么样的知识点]
更新中......
资源调度管理
- 任务调度与资源是通过 DAGScheduler、TaskScheduler、SchedulerBackend 等进行的作业调度
- 资源调度是指应用程序如何获得资源
- 任务调度是在资源调度的基础上进行的,没有资源调度那么任务调度就成为了无源之水无本之木
Master 资源调度的源码鉴赏
- 因為 Master 負責資源管理和調度,所以資源調度方法 scheduer 位於 Master.scala 這個類中,當注册程序或者資源發生改變的時候都會導致 Scheduler 的調用,例如注册的時候。
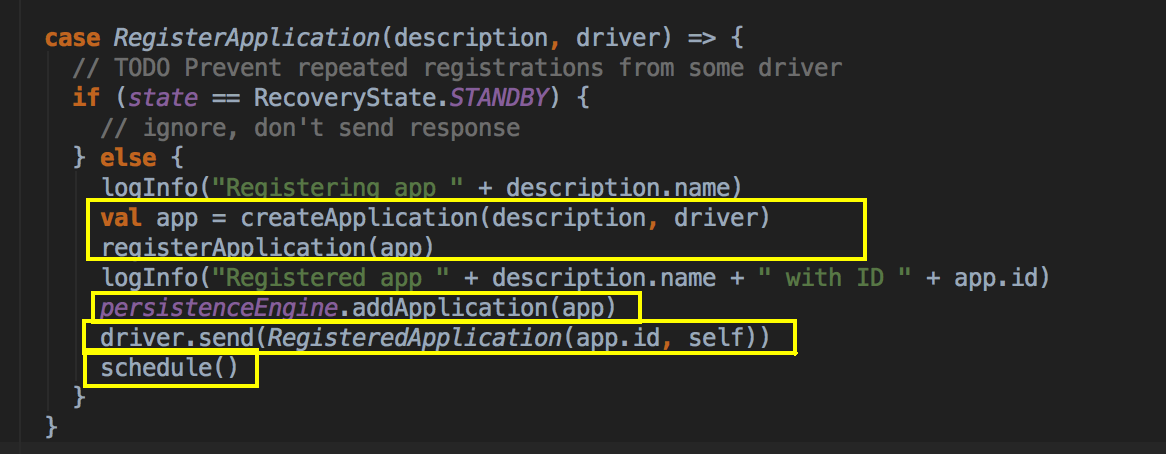
当这个应用程序向 Master 注册的时候,会把 ApplicationInfo 的信息放在一个 case class 里,过程中会新增新的 AppId,当注册的时候会分发给不同的数据结构记录起来,比如说 idToApp、endpointToApp、
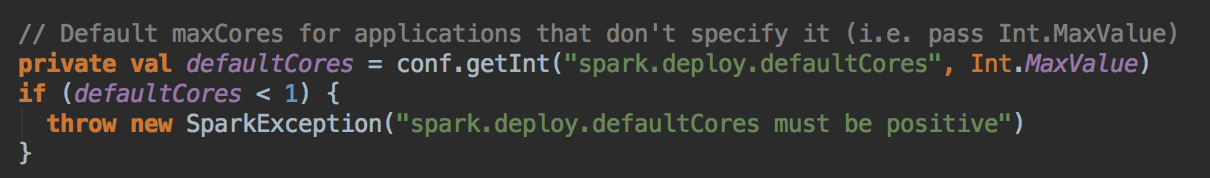
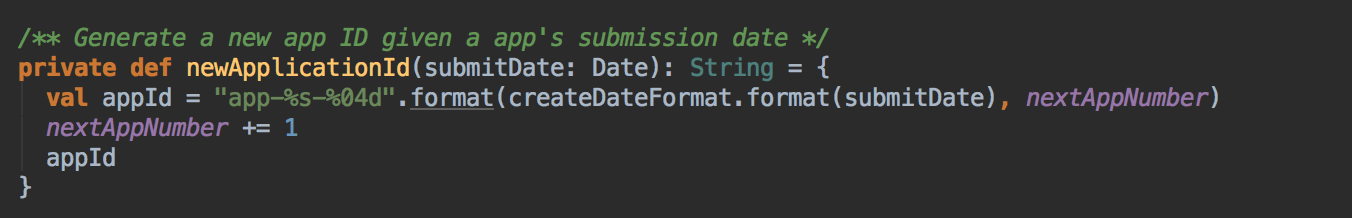

- Scheduler 調用的時機,每次都有新的應用程序提交或者集群資源狀況發生改變的時候(包括 Executor 增加或者減少、Worker 增加或者減少等)具体代码运行顺序:scheduler( ) --> Random.shuffle( ) --> 有一个for循环过滤出ALIVE的Worker --> 过滤出付合Memory和Cores的Worker --> 然后调用 lanuchDriver( ) --> startExecutorsOnWorker( )

WorkerState 有以下几种:ALIVE, DEAD, DECOMMISSIONED, UNKNOWN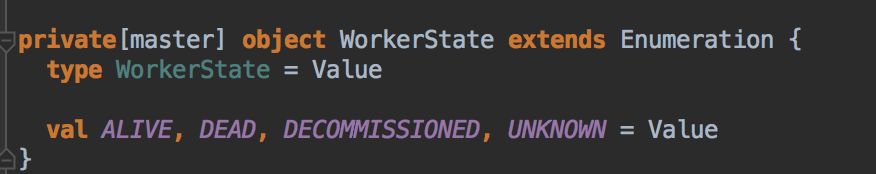
- 當前 Master 必需是 Alive 的方式才可以進行資源調度,一開始的時候會判斷一下狀態,如果不是 Alive 的狀態會直接返回,也就是 StandByMaster 不會進行 Application 的資源調用
- 使用 Random.shuffle 把 Master 中保留的集群中所有 Worker 的信息隨機打亂;其算法內部是循環隨機交換所有 Worker 在 Master 緩存的數據結構中的位置
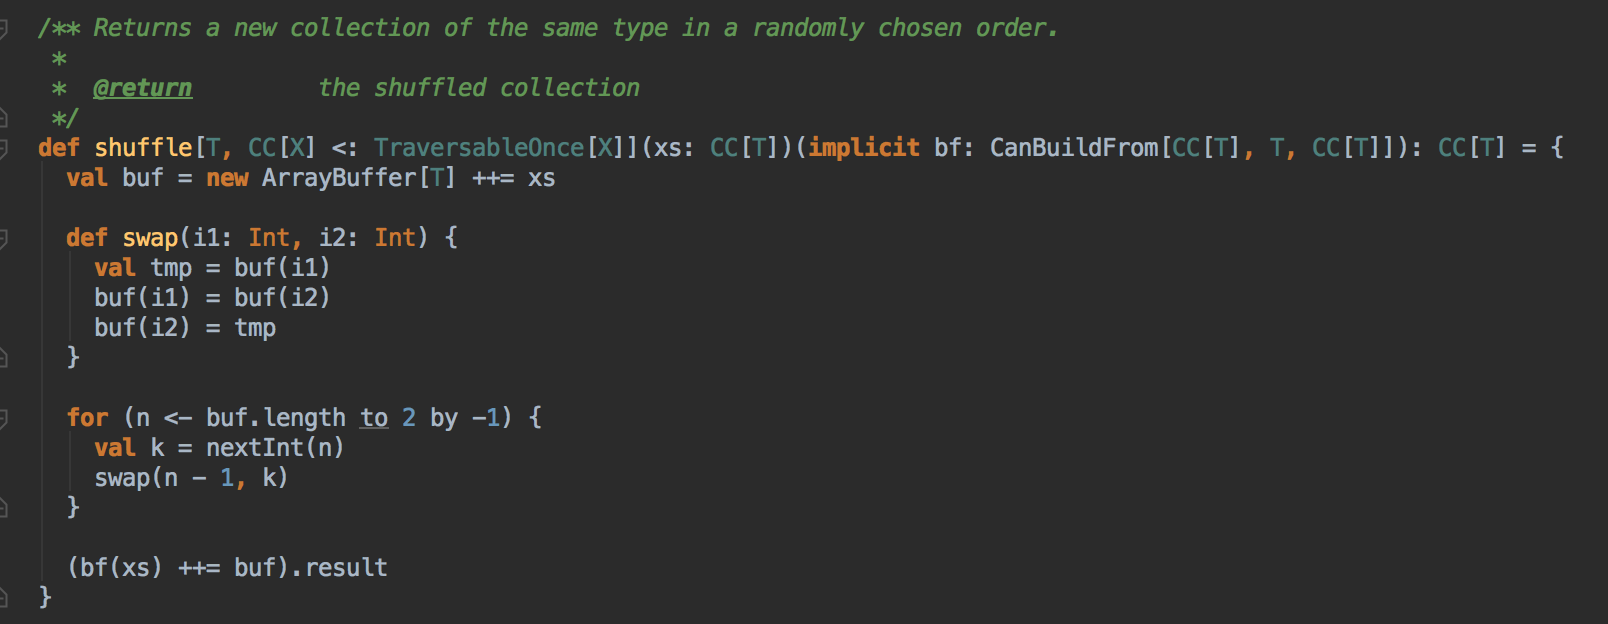
- 接下來要判斷所有 Worker 中那些是 ALIVE 級別的 Worker 才能夠參與資源的分配工作
- 當 SparkSubmit 指定 Driver 在 Cluster 模式的情況下,此時 Driver 會加入 waitingDrivers 等待列表中,在每個 DriverInfo 中的 DriverDescription 中要啟動 Driver 時候對 Worker 的內存及 CPU 要求等內容:
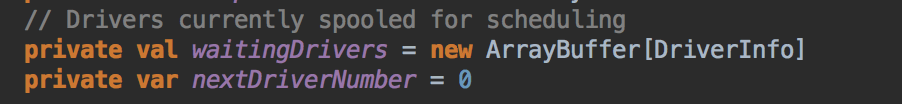

- 在符合資源要求的情況下然後採用隨時打亂後的一個 Worker 來啟動 Driver,Master 發指令給 Worker 讓遠程的 Worker 啟動 Driver,这就可以保证负载均衡。先啟動 Driver 才會發生後續的一切的資源調度的模式

正式启动在Worker中启动Executor
Spark 默认为应用程序启动 Executor 的方式是 FIFO 的方式,也就是說所有的提交的應用程序都是放在調度的等待隊列中的,先進先出,只有滿足了出面應用程序的分配的基础上才能夠滿足下一個應用程序資源的分配。正式启动在Worker中启动Executor:為应用程序具体分配 Executor 之前要判断应用程序是否還需要分配 Core 如果不需要則不会為应用程序分配 Executor
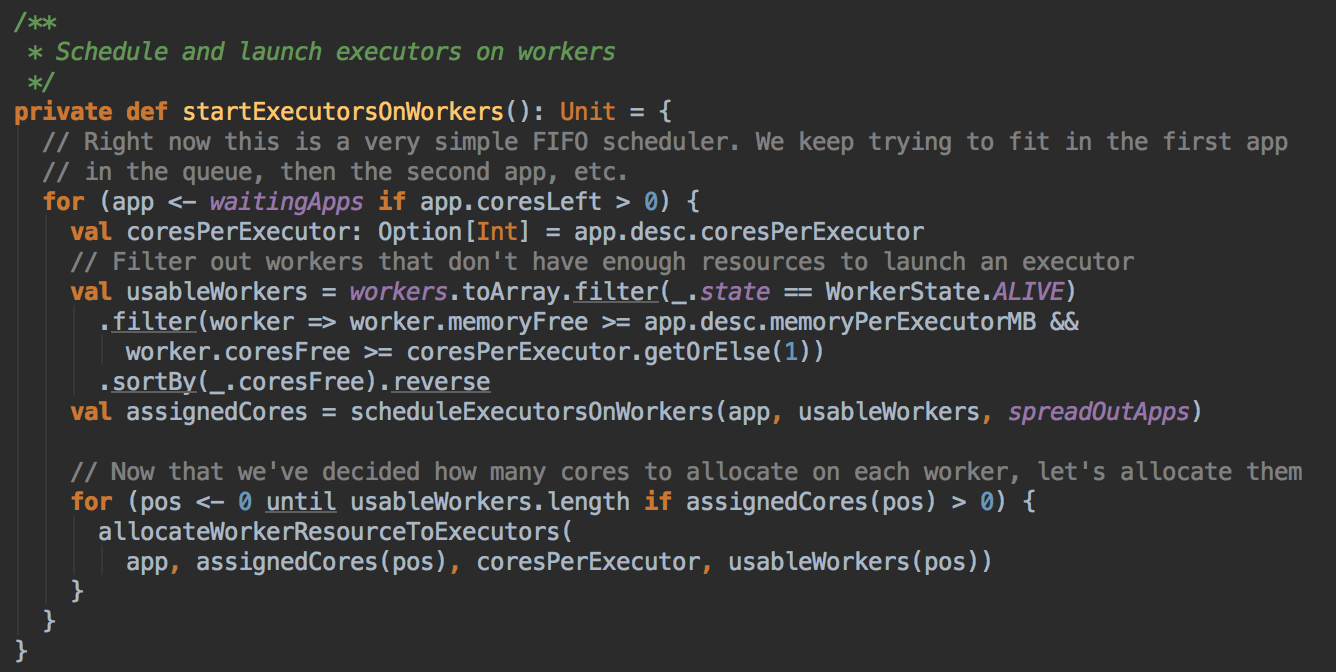
- 具體分配 Executor 之前要求 Worker 必需是 Alive 的狀態且必需滿足 Application 對每個 Executor 的內存和 Cores 的要求,並且在此基礎上進行排序,誰的 Cores 多就排在前面。計算資源由大到小的 usableWorkers 數據結構。把最好的資源放在前面。
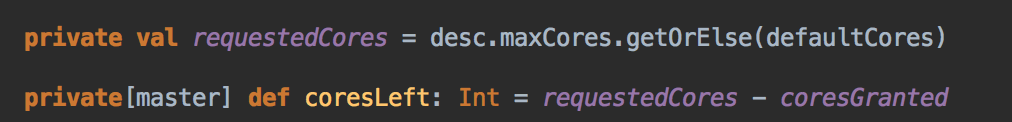

在 FIFO 的情況下默認是 spreadOutApps 來讓應用程序盡可能多的運行在所有的 Node 上。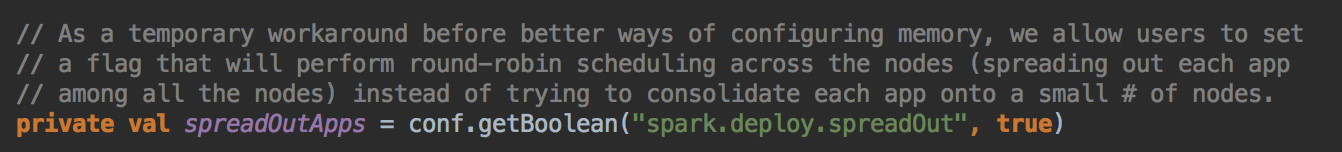
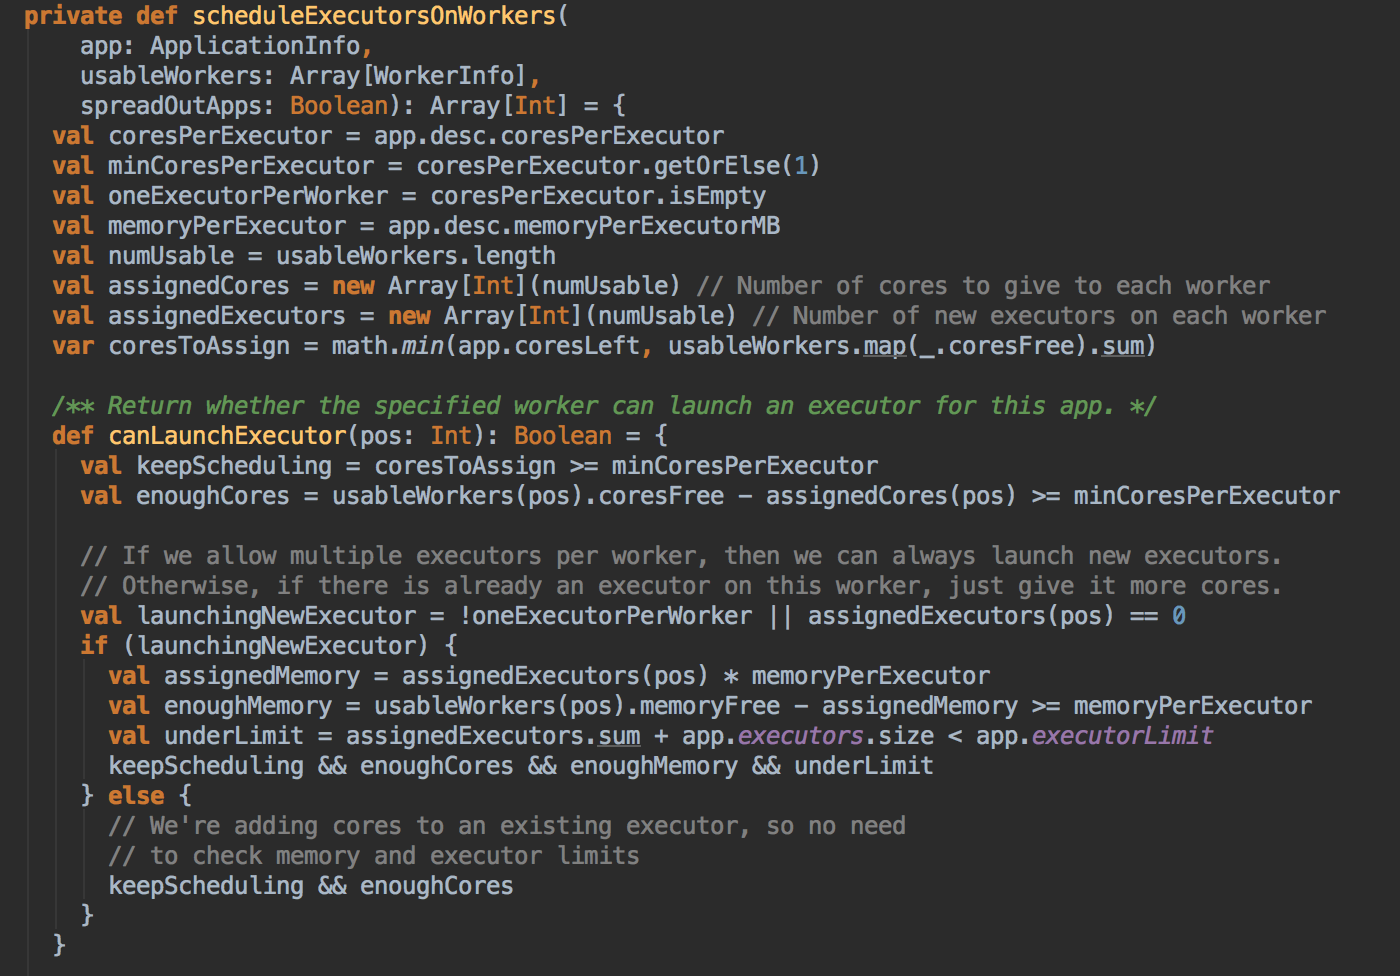
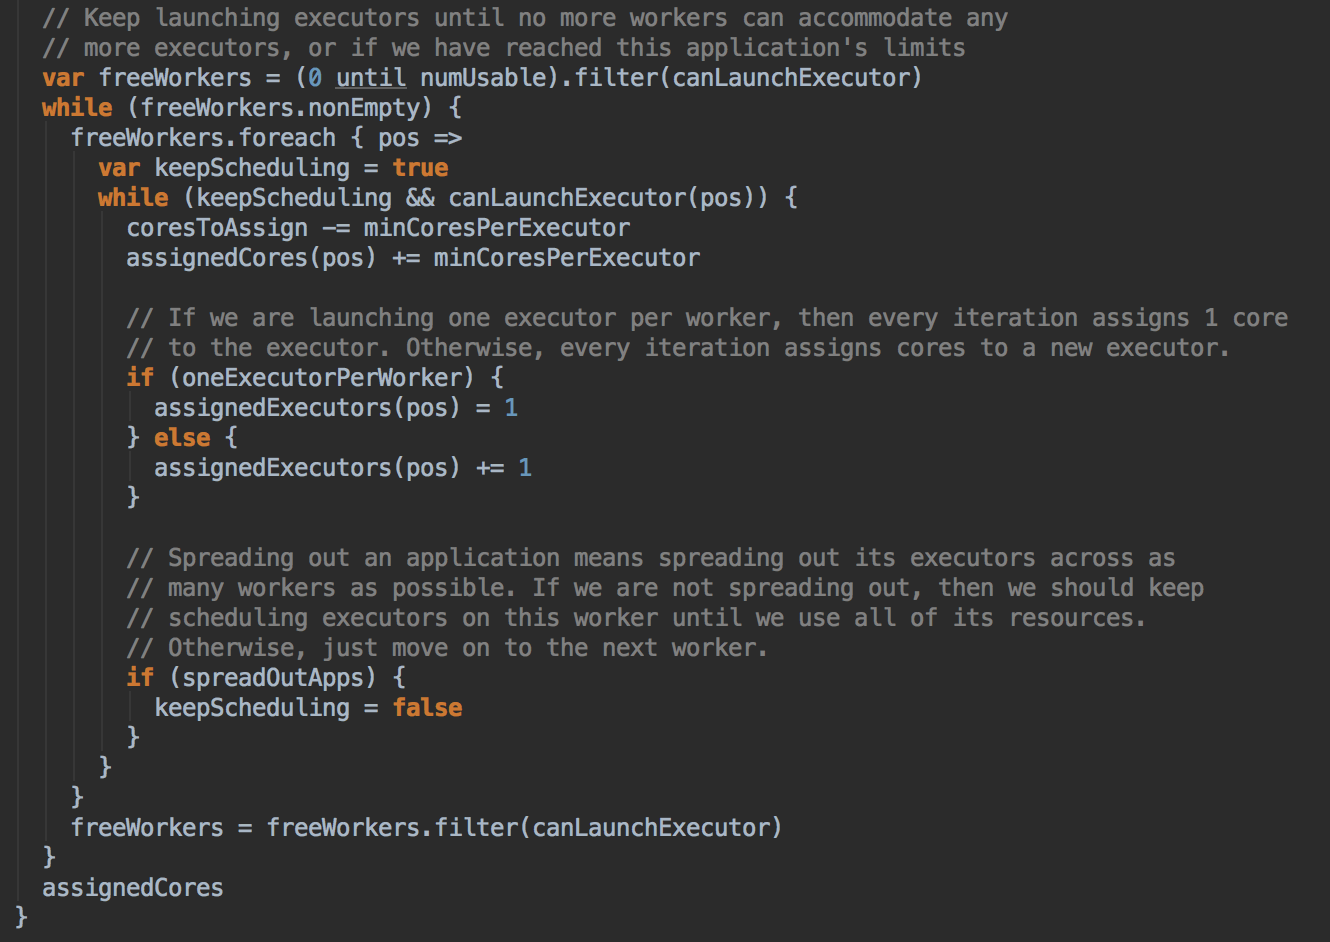
- 然后调用 scheduleExecutorsOnWorkers 方法,為應用程序分配 executor 有兩種情況,第一種方式是盡可能在集群的所有 Worker 上分配 Executor ,這種方式往往會帶來潛在的更好的數據本地性。具體在集群上分配 Cores 的時候會盡可能的滿足我們的要求,如果是每個 Worker 下面只能夠為當前的應用程序分配一個 Executor 的話,每次是分配一個 Core! (每次為這個 Executor 增加一個 Core)。每次給 Executor 增加的時候都是堵加一個 Core, 如果是 spreadout 的方式,循環一論下一論,假設有4個 Executors,如果 spreadout 的方式,它會在每個 Worker 中啟動一個 Executor, 第一次為每個 Executor 分配一個線程,第二次再次循環後再分配一條線程。
- 然后调用 allocateWorkerResourceToExecutors 方法
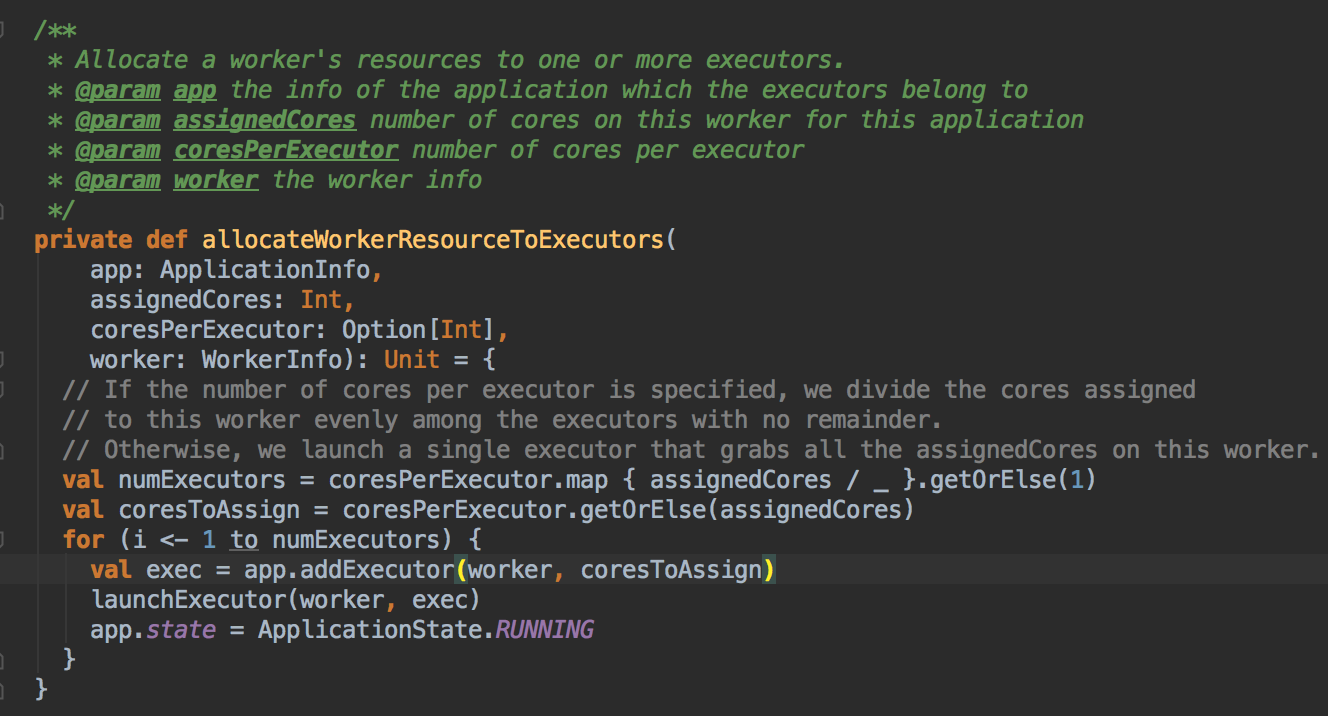
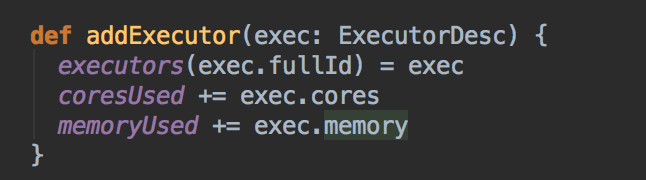
- 然后会调用 addExecutor 方法
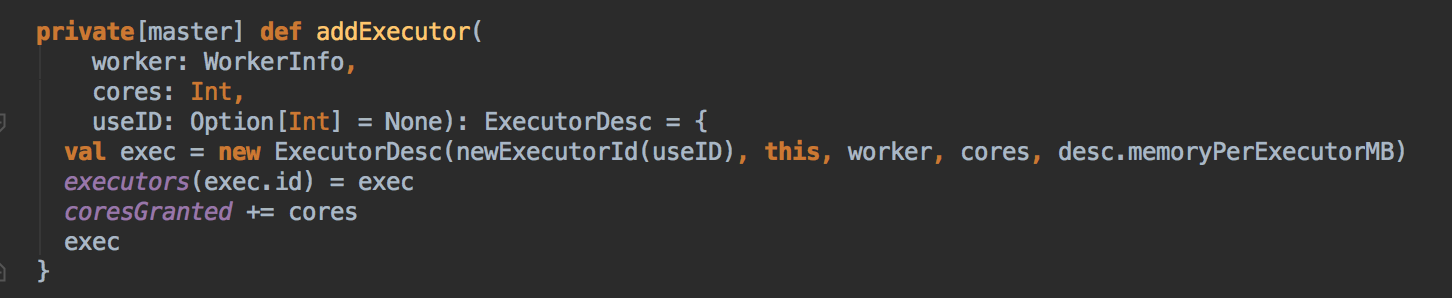
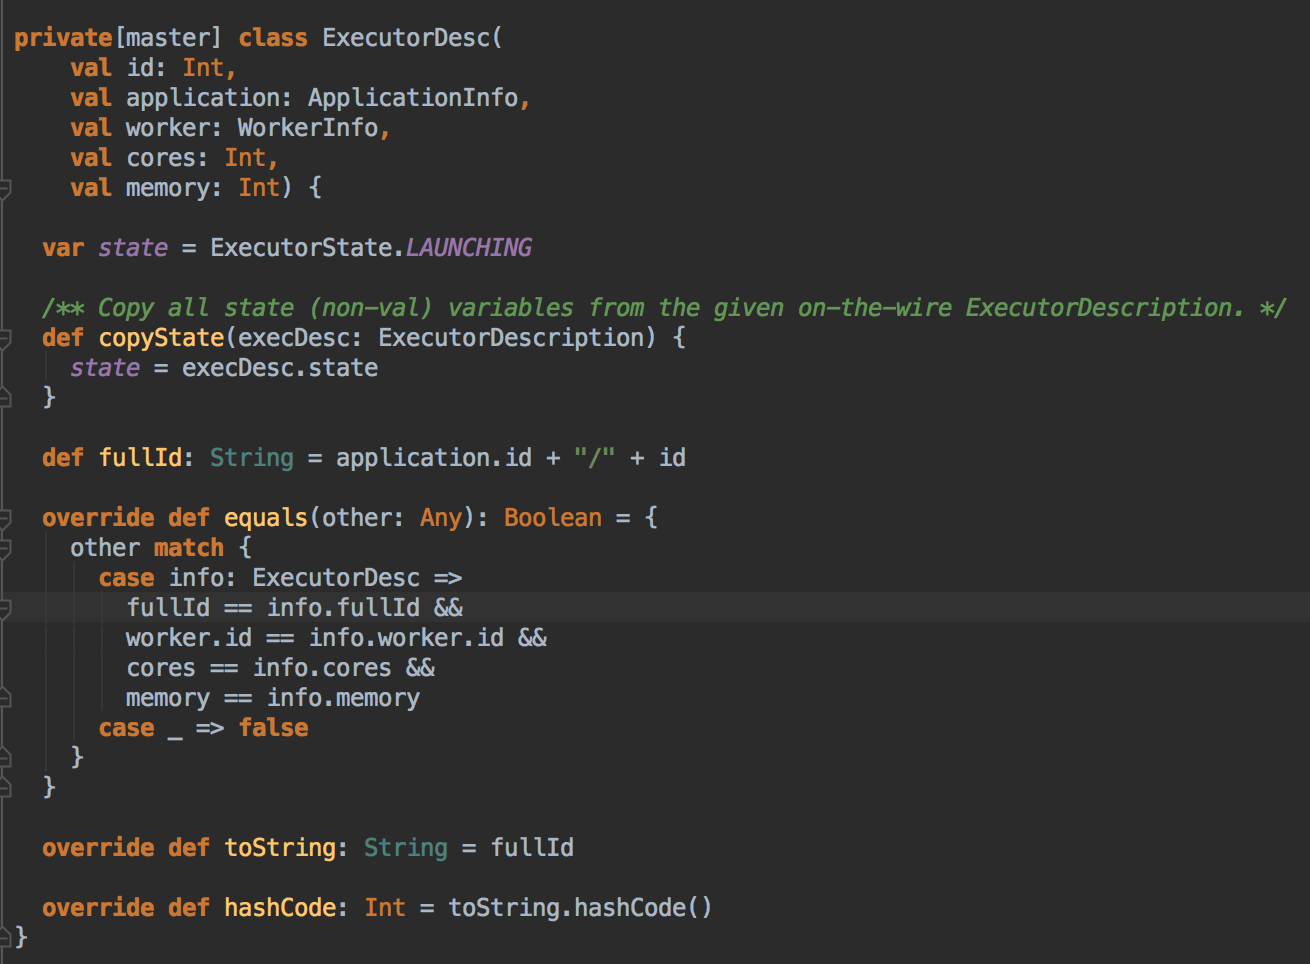
- 新增 Executor 后然后就真正的启动 Executor,準備具體要為當前應用程序分配的 Executor 信息後,Master 要通過遠程通信發指令給 Worker 來具體啟動 ExecutorBackend 進程,緊接給我們應用程序的 Driver 發送一個 ExecutorAdded 的信息。(Worker收到由Master发送LaunchExector信息之后如何处理可以参考我的下一篇博客!)
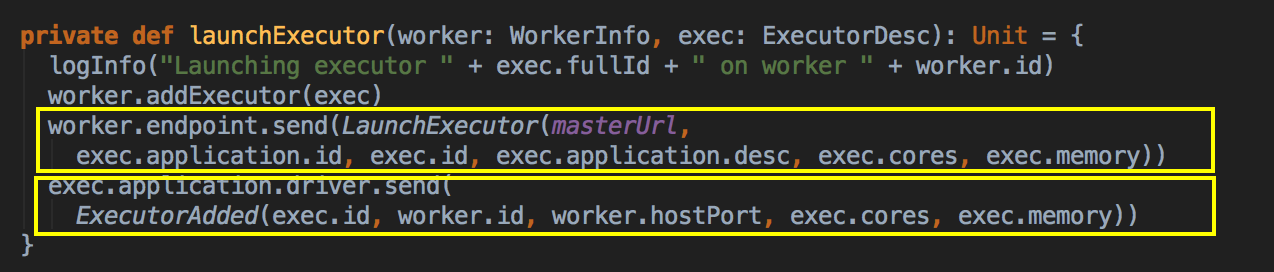
LaunchExecutor case class 数据结构,Master 会把这个数据发送到 Worker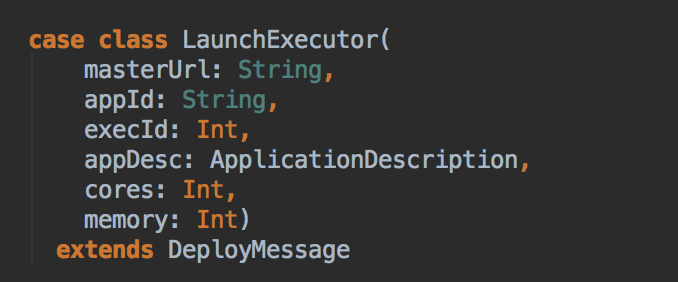
Master 会把这个数据发送到 Driver
[总结部份]
更新中......
參考資料
资料来源来至 DT大数据梦工厂 大数据传奇行动 第31课:Spark资源调度分配内幕天机彻底解密:Driver在Cluster模式下的启动、两种不同的资源调度方式源码彻底解析、资源调度内幕总结
Spark源码图片取自于 Spark 1.6.0版本
[Spark内核] 第31课:Spark资源调度分配内幕天机彻底解密:Driver在Cluster模式下的启动、两种不同的资源调度方式源码彻底解析、资源调度内幕总结的更多相关文章
- Spark资源调度分配内幕天机彻底解密:Driver在Cluster模式下的启动、两种不同的资源调度方式源码彻底解析、资源调度内幕总结
本课主题 Master 资源调度的源码鉴赏 资源调度管理 任务调度与资源是通过 DAGScheduler.TaskScheduler.SchedulerBackend 等进行的作业调度 资源调度是指应 ...
- [Spark内核] 第35课:打通 Spark 系统运行内幕机制循环流程
本课主题 打通 Spark 系统运行内幕机制循环流程 引言 通过 DAGScheduelr 面向整个 Job,然后划分成不同的 Stage,Stage 是從后往前划分的,执行的时候是從前往后执行的,每 ...
- Apache Spark源码走读之19 -- standalone cluster模式下资源的申请与释放
欢迎转载,转载请注明出处,徽沪一郎. 概要 本文主要讲述在standalone cluster部署模式下,Spark Application在整个运行期间,资源(主要是cpu core和内存)的申请与 ...
- spark yarn cluster模式下任务提交和计算流程分析
spark可以运行在standalone,yarn,mesos等多种模式下,当前我们用的最普遍的是yarn模式,在yarn模式下又分为client和cluster.本文接下来将分析yarn clust ...
- [Spark内核] 第28课:Spark天堂之门解密
本課主題 什么是 Spark 的天堂之门 Spark 天堂之门到底在那里 Spark 天堂之门源码鉴赏 引言 我说的 Spark 天堂之门就是SparkContext,这篇文章会从 SparkCont ...
- [Spark内核] 第32课:Spark Worker原理和源码剖析解密:Worker工作流程图、Worker启动Driver源码解密、Worker启动Executor源码解密等
本課主題 Spark Worker 原理 Worker 启动 Driver 源码鉴赏 Worker 启动 Executor 源码鉴赏 Worker 与 Master 的交互关系 [引言部份:你希望读者 ...
- [Spark内核] 第33课:Spark Executor内幕彻底解密:Executor工作原理图、ExecutorBackend注册源码解密、Executor实例化内幕、Executor具体工作内幕
本課主題 Spark Executor 工作原理图 ExecutorBackend 注册源码鉴赏和 Executor 实例化内幕 Executor 具体是如何工作的 [引言部份:你希望读者看完这篇博客 ...
- [Spark内核] 第36课:TaskScheduler内幕天机解密:Spark shell案例运行日志详解、TaskScheduler和SchedulerBackend、FIFO与FAIR、Task运行时本地性算法详解等
本課主題 通过 Spark-shell 窥探程序运行时的状况 TaskScheduler 与 SchedulerBackend 之间的关系 FIFO 与 FAIR 两种调度模式彻底解密 Task 数据 ...
- [Spark内核] 第29课:Master HA彻底解密
本课主题 Master HA 解析 Master HA 解析源码分享 [引言部份:你希望读者看完这篇博客后有那些启发.学到什么样的知识点] 更新中...... Master HA 解析 生产环境下一般 ...
随机推荐
- ettercap的中间人欺骗+sslstrip过滤掉https协议
环境准备:kali系统 因为kali系统自带ettercap,比较方便, 不需要安装 ifcofing命令查看当前网关 ,当前的IP是: 172.16.42.1 查找局域网所有主机 通过netdisc ...
- Unity 3D游戏开发引擎:最火的插件推荐
摘要:为了帮助使用Unity引擎的开发人员制作更完美的游戏.我们精心挑选了十款相关开发插件和工具.它们是:2D Toolkit.NGUI.Playmaker.EasyTouch & EasyJ ...
- HTML学习笔记之三(localstorage的使用)
localstorage的使用 1.获取对象 var localstroage = window.localStorage; 2.存储值 localstroage.setItem('openid',' ...
- SpringMVC实现JSON与前台交互
这几天忙着做学校的项目,感觉好久没有更新博客了,来整理一下. 由于要实现的功能是表单联动,只能自己去写ajax来实现提交给后台接口了,好久没有写前端,好多东西都忘记了,只能可怜巴巴的用原生的js去实现 ...
- 自学Python2.4-基本数据类型-字典dict(objct)
Python dict方法总结 一.字典介绍 1.字典概述 ①字典是python中唯一内建的映射类型.又称关联数组或散列②映射类型对象里哈希值(键,key)和指向的对象(值,value)是一对多的的关 ...
- CS:APP3e 深入理解计算机系统_3e Attacklab 实验
详细的题目要求和资源可以到 http://csapp.cs.cmu.edu/3e/labs.html 或者 http://www.cs.cmu.edu/~./213/schedule.html 获取. ...
- Epplus:导出Excel
看到其它大神的Epplus导出Excel,结合写出符合自己需求的将导出数据到Excel,给其它人参考一下,也可以学习http://www.cnblogs.com/caofangsheng/p/6149 ...
- .Net 异步方法, await async 使用
最近朋友问起await 和 async第一次听说这个await ,就查了一下这个await使用在于 异步方法async 中,中文意思就是等待,经过一系列的百度参考简单的明白了这个东西的意思, 异步 ...
- Python学习日记:day1
1.计算机基础 cpu:相当于人的大脑,用于计算. 内存:储存数据,运行速度快,成本高,断电数据消失. 硬盘 :固态硬盘(快).机械硬盘(有指针).储存数据,需要长期保持数据,重要文件 打开qq过程: ...
- android中Log类的封装
1.为了方便的使用Log打印日志,以及后续方便撤销日志打印,所以对Log类进行封装是一件好事. package market.phone; import android.util.Log; /** * ...