
HtmlParser应用
HtmlParser应用,使用Filter从爬取到的网页中获取需要的内容
{

        String url = "http://wenku.baidu.com/search?word=htmlparser&lm=0&od=0&fr=top_home";

        //获取页面中的<a href='xxx' [属性]>格式的链接

        nodeFilterTagClass(url, "UTF-8", LinkTag.class);

        //或取页面中的<img src='xxx' [属性='属性值']>格式的链接

        nodeFilterTagClass(url, "UTF-8", ImageTag.class);

        //或取页面<title>xxxx</title>标题

        nodeFilterTagClass(url, "UTF-8", TitleTag.class);

        //获取页面<div [属性='属性值']> xxx</div>

        //nodeFilterTagClass(url, "UTF-8", Div.class);

}

程序运行结果:
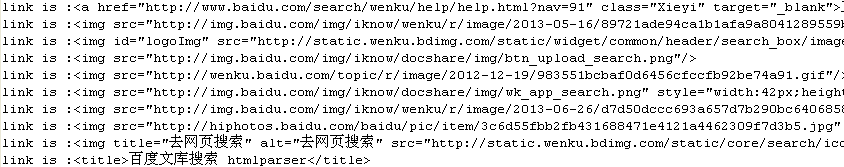
TagNameFilter实例应用
是最容易理解的一个Filter,根据Tag的名字进行过滤
    /**

     *

     * 根据标签名过滤页面中的标签信息

     *

     * @param url        要解析的url页面

     * @param encoding    使用的字符编码

     * @param tagName    标签名

     */

    public static void nodeFilterTagName(String url,String encoding,String tagName){

        try {

            Parser parser = new Parser();

            parser.setURL(url);

            if(null==encoding){

                parser.setEncoding(parser.getEncoding());

            }else{

                parser.setEncoding(encoding);

            }

            //过滤页面中的链接标签

            NodeFilter filter = new TagNameFilter(tagName);

            NodeList list = parser.extractAllNodesThatMatch(filter);

            for(int i=0; i<list.size();i++){

                Node node = (Node)list.elementAt(i);

                System.out.println("link is :" + node.toHtml());

            }

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

    public static void main(String[] args) {

        String url = "http://wenku.baidu.com/search?word=htmlparser&lm=0&od=0&fr=top_home";

        //获取页面中的<a href='xxx' [属性]>格式的链接

        nodeFilterTagName(url, "UTF-8", "a");

        //或取页面中的<img src='xxx' [属性='属性值']>格式的链接

        nodeFilterTagName(url, "UTF-8", "img");

        //获取页面中的<div>链接

        //nodeFilterTagName(url, "UTF-8", "div");

    }
程序运行结果同上
StringFilter实例应用
过滤显示字符串中包含指定内容的标签节点。注意是可显示的字符串,不可显示的字符串中的内容(例如注释,链接等等)不会被显示
    /**

     * 过滤显示字符串中包含指定内容的标签节点。注意是可显示的字符串,不可显示的字符串中的内容(例如注释,链接等等)不会被显示

     *

     * @param url        请求处理的url

     * @param encoding    字符编码

     * @param containStr包含的指定内容

     */

    public static void stringFilter(String url,String encoding,String containStr){

        try {

            Parser parser = new Parser();

            parser.setURL(url);

            if(null==encoding){

                parser.setEncoding(parser.getEncoding());

            }else{

                parser.setEncoding(encoding);

            }

            //OrFilter是结合几种过滤条件的‘或’过滤器

            NodeFilter filter = new StringFilter(containStr);

            NodeList list = parser.extractAllNodesThatMatch(filter);

            for(int i=0; i<list.size();i++){

                Node node = (Node)list.elementAt(i);

                System.out.println("link is :" + node.toHtml());

            }

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

    public static void main(String[] args) {

        String url = "http://wenku.baidu.com/search?word=htmlparser&lm=0&od=0&fr=top_home";

        stringFilter(url, "UTF-8", "img.baidu.com");

    }
程序运行结果

OrFilter实例应用
OrFilter是结合几种过滤条件的‘或’过滤器,与此相反的是AndFilter,AndFilter是集合几个过滤条件的‘与’过滤器
    /**

     * OrFilter是结合几种过滤条件的‘或’过滤器

     *

     * 一般主题信息包含在下列标签中:<table>、<tr>、<td>、<p>、<div>等。如果要过滤出这些节点标签,可以使用OrFilter过滤器

     *

     * @param url        请求处理的url

     * @param encoding    使用的字符编码

     * @param filters    多个过滤器数组

     */

    public static void orMultiFilter(String url,String encoding,NodeFilter[] filters){

        try {

            Parser parser = new Parser();

            parser.setURL(url);

            if(null==encoding){

                parser.setEncoding(parser.getEncoding());

            }else{

                parser.setEncoding(encoding);

            }

            //OrFilter是结合几种过滤条件的‘或’过滤器

            NodeFilter filter = new OrFilter(filters);

            NodeList list = parser.extractAllNodesThatMatch(filter);

            for(int i=0; i<list.size();i++){

                Node node = (Node)list.elementAt(i);

                System.out.println("link is :" + node.toHtml());

            }

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

    public static void main(String[] args) {

        String url = "http://wenku.baidu.com/search?word=htmlparser&lm=0&od=0&fr=top_home";

        //过滤多个标签 或关系

        NodeFilter[]  filters = new NodeFilter[3];

        filters[0] = new NodeClassFilter(TableTag.class);

        filters[1] = new NodeClassFilter(ParagraphTag.class);

        filters[2] = new NodeClassFilter(ImageTag.class);

        orMultiFilter(url, "UTF-8", filters);

    }
程序运行结果:
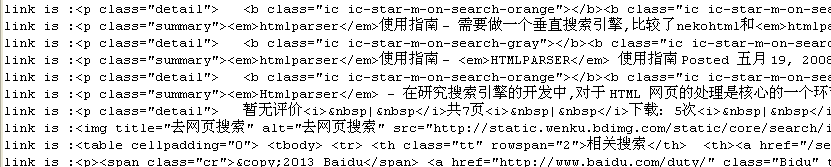
RegexFilter与LinkRegexFilter实例应用
RegexFilter根据正则表达式匹配节点.与LinkRegexFilter不同的是,LinkRegexFilter只在LinkTag中寻找匹配
    /**

     * 在文本中通过正则进行匹配

     *

     * @param url        请求处理的url

     * @param encoding    字符编码

     * @param regex        待匹配的正则表达式

     */

    public static void regexStringFilter(String url,String encoding,String regex){

        try {

            Parser parser = new Parser();

            parser.setURL(url);

            if(null==encoding){

                parser.setEncoding(parser.getEncoding());

            }else{

                parser.setEncoding(encoding);

            }

            //OrFilter是结合几种过滤条件的‘或’过滤器

            NodeFilter filter = new RegexFilter(regex);

            NodeList list = parser.extractAllNodesThatMatch(filter);

            for(int i=0; i<list.size();i++){

                Node node = (Node)list.elementAt(i);

                System.out.println("link is :" + node.toHtml());

            }

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

    /**

     * 在链接地址中进行正则匹配,返回的是Link结点

     *

     * @param url        请求url

     * @param encoding    字符编码

     * @param regex        待匹配的正则表达式

     */

    public static void linkTagRegexFilter(String url,String encoding,String regex){

        try {

            Parser parser = new Parser();

            parser.setURL(url);

            if(null==encoding){

                parser.setEncoding(parser.getEncoding());

            }else{

                parser.setEncoding(encoding);

            }

            //OrFilter是结合几种过滤条件的‘或’过滤器

            NodeFilter filter = new LinkRegexFilter(regex);

            NodeList list = parser.extractAllNodesThatMatch(filter);

            for(int i=0; i<list.size();i++){

                Node node = (Node)list.elementAt(i);

                System.out.println("link is :" + node.toHtml());

            }

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

    public static void main(String[] args) {

        String url =  "F:/dennisit/email.txt";

        String emailRegex = "[a-zA-Z0-9_-]+@\\w+\\.[a-z]+(\\.[a-z]+)?";

        regexStringFilter(url, "UTF-8", emailRegex);

        System.out.println("-------------------------------------------");

        linkTagRegexFilter(url, "UTF-8", emailRegex);

    }
程序运行结果
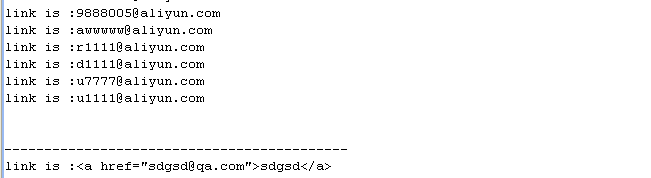
转载请注明出处:[http://www.cnblogs.com/dennisit/p/3191803.html]
HtmlParser应用的更多相关文章
- HttpClient 与 HtmlParser 简介 转载
转载地址:https://www.ibm.com/developerworks/cn/opensource/os-cn-crawler/ 本小结简单的介绍一下 HttpClinet 和 HtmlPar ...
- HTMLParser使用
htmlparser[1] 是一个纯的java写的html(标准通用标记语言下的一个应用)解析的库,它不依赖于其它的java库文件,主要用于改造或提取html.它能超高速解析html,而且不会出错.现 ...
- python--爬虫入门(八)体验HTMLParser解析网页,网页抓取解析整合练习
python系列均基于python3.4环境 基本概念 html.parser的核心是HTMLParser类.工作的流程是:当你feed给它一个类似HTML格式的字符串时,它会调用goahead方法 ...
- 使用 HttpClient 和 HtmlParser 实现简易爬虫
这篇文章介绍了 HtmlParser 开源包和 HttpClient 开源包的使用,在此基础上实现了一个简易的网络爬虫 (Crawler),来说明如何使用 HtmlParser 根据需要处理 Inte ...
- 爬虫技术 -- 基础学习(四)HtmlParser基本认识
利用爬虫技术获取网页源代码后,针对网页抽取出它的特定文本内容,利用正则表达式和抽取工具,能够更好地抽取这些内容. 下面介绍一种抽取工具 -- HtmlParser HtmlParser是一个用来解析H ...
- Delphi7的HtmlParser使用方法
uses HtmlParser procedure TForm4.Button1Click(Sender: TObject); var FNodes:IHtmlElement; aString:str ...
- 读代码之htmlParser
在以前使用HtmlParser时,并未考虑过遇到org.htmlparser.tags之外的Tag怎么处理.直到碰到这样的一个标签,如果不加处理,HtmlParser无法对其进行处理.查阅自定义标签之 ...
- 黄聪:C#解析HTML DOM解析类 HtmlParser.Net 下载
下载地址:HtmlParser.Net.rar 帮助文档:htmlparser.rar 背景: HTMLParser原本是一个在sourceforge上的一个Java开源项目,使用这个Java类库可以 ...
- HtmlParser + HttpClient 实现爬虫
简易爬虫的实现 HttpClient 提供了便利的 HTTP 协议访问,使得我们可以很容易的得到某个网页的源码并保存在本地:HtmlParser 提供了如此简便灵巧的类库,可以从网页中便捷的提取出指向 ...
- HtmlParser
HtmlParser 基本类库使用 HtmlParser 提供了强大的类库来处理 Internet 上的网页,可以实现对网页特定内容的提取和修改.下面通过几个例子来介绍 HtmlParser 的一些使 ...
随机推荐
- PHP_零基础学php_3PHP函数、传参函数、默认参数、函数返回值
<?php function say_hello() //无参数 { $name="tang"; echo "hello,".$name; echo &q ...
- boost进程间通信经常使用开发一篇全(消息队列,共享内存,信号)
本文概要: 敏捷开发大家想必知道并且评价甚高,缩短开发周期,提高开发质量.将大project独立为不同的小app开发,整个开发过程,程序可用可測,所以提高了总体的质量.基于这样的开发模式和开发理念,进 ...
- Java设计模式(八)观察者模式 迭代器模式
(十五)观察者模式 观察者模式,定义对象间一对多关系,一个对象状态发生改变,全部依赖于它的对象都收到通知而且自己主动更新,观察者与被观察者分开.比如邮件订阅.RSS订阅,假设有更新就会邮件通知你. i ...
- C语言学习之路,第一篇章。
看的书是 C primer plus ,这本书好评很多, 学过C#,没有精通,了解Java,所以看这本书会很容易上手,编译器用的是VC++6.0,因为VS2010好像不支持C99标准,有些代码功能 ...
- HDU 5001 概率DP || 记忆化搜索
2014 ACM/ICPC Asia Regional Anshan Online 给N个点,M条边组成的图,每一步能够从一个点走到相邻任一点,概率同样,问D步后没走到过每一个点的概率 概率DP 測 ...
- bootstrap3-datepicker and jquery.form.js
bootstrap3-datepicker 和 jquery.form.js 这两个控件又起来都比较简单,就一起介绍了. 先说datepicker. github上的地址是:https://githu ...
- [译]Java 设计模式之迭代器
(文章翻译自java-design-pattern-iterator) 迭代器模式用于迭代遍历一个集合对象.它是一个经常被用到的模式,你可能以前使用过它.不管在任何时候你看见一些方法像hasNext( ...
- java这些东西发展(4)-------无穷time of error
今天,有些郁闷的心情啊.空指针下午折磨.到现在为止仍然没有得到解决,专家的招募结果没拿到,我们必须继续自己的,进而改变一点点一点点地找到它,但现在我不想搞,准备回家,这浪费了一个多小时,之前记录的下一 ...
- Asp.Net Identity 深度解析 之 注册登录的扩展
关于权限每个系统都有自己的解决方案,今天我们来讨论一下微软的权限框架Asp.Net Identity ,介绍如下 http://www.asp.net/identity 这里不在赘余. 很多人认为 ...
- MVC 过滤器1
ASP.NET MVC 过滤器(一) 前言 前面的篇幅中,了解到了控制器的生成的过程以及在生成的过程中的各种注入点,按照常理来说篇幅应该到了讲解控制器内部的执行过程以及模型绑定.验证这些知识了.但是呢 ...