
Python学习笔记之爬虫
爬虫调度端:启动爬虫,停止爬虫,监视爬虫运行情况
URL管理器:对将要爬取的和已经爬取过的URL进行管理;可取出带爬取的URL,将其传送给“网页下载器”
网页下载器:将URL指定的网页下载,存储成一个字符串,在传送给“网页解析器”
网页解析器:解析网页可解析出①有价值的数据②另一方面,每个网页都包含有指向其他网页的URL,解析出来后可补充进“URL管理器”

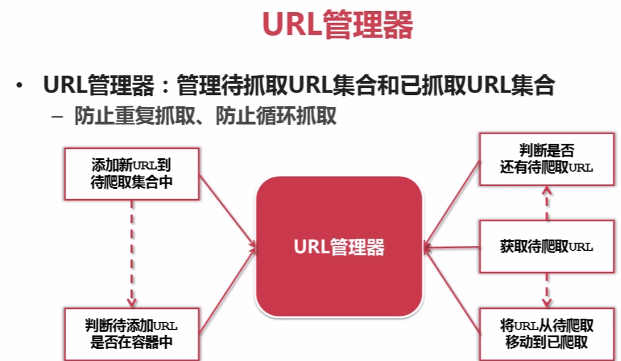
网页解析器——Beautiful Soup-语法:
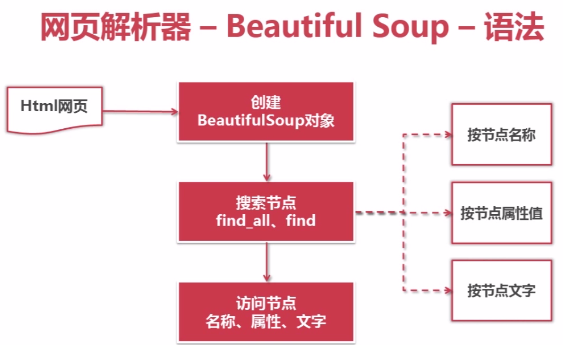
例如以下代码:

对应的代码:
1、创建BeautifulSoap对象
2、搜索节点(find_all,find)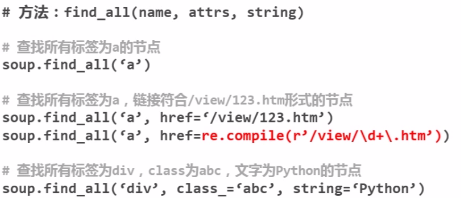
3、访问节点信息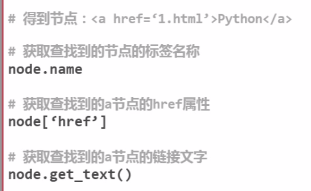
# -*- coding: UTF-8 -*-

from bs4 import BeautifulSoup

import re

html_doc = """

<html><head><title>The Dormouse's story</title></head>

<body>

<p class="title"><b>The Dormouse's story</b></p>

<p class="story">Once upon a time there were three little sisters; and their names were

<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,

<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and

<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;

and they lived at the bottom of a well.</p>

<p class="story">...</p>

"""

soup = BeautifulSoup(html_doc,'html.parser', from_encoding='utf-8')#(文档字符串,解析器,指定编码utf-8)

print('获取所有的连接:')

links = soup.find_all('a')

for link in links:

    print link.name, link['href'],link.get_text()

print('获取Lacie的连接:')

link_node = soup.find('a', href='http://example.com/lacie')#text='Lacie'

print link_node.name,link_node['href'],link_node.get_text()

print('正则匹配')

link_node = soup.find('a', href=re.compile(r'ill'))

print link_node.name,link_node['href'],link.get_text()

print('获取p段落文字:')

p_node = soup.find('p', class_='title')#class_

print p_node.name, p_node.get_text()
Python学习笔记之爬虫的更多相关文章
- python学习笔记:"爬虫+有道词典"实现一个简单的英译汉程序
1.有道的翻译 网页:www.youdao.com Fig1 Fig2 Fig3 Fig4 再次点击"自动翻译"->选中'Network'->选中'第一项',如下: F ...
- 吴裕雄--python学习笔记:爬虫基础
一.什么是爬虫 爬虫:一段自动抓取互联网信息的程序,从互联网上抓取对于我们有价值的信息. 二.Python爬虫架构 Python 爬虫架构主要由五个部分组成,分别是调度器.URL管理器.网页下载器.网 ...
- Python学习笔记——与爬虫相关的网络知识
1 关于URL URL(Uniform / Universal Resource Locator):统一资源定位符,用于完整地描述Internet上网页和其他资源的地址的一种标识方法 URL是爬虫的入 ...
- 吴裕雄--python学习笔记:爬虫包的更换
python 3.x报错:No module named 'cookielib'或No module named 'urllib2' 1. ModuleNotFoundError: No module ...
- 吴裕雄--python学习笔记:爬虫
import chardet import urllib.request page = urllib.request.urlopen('http://photo.sina.com.cn/') #打开网 ...
- Python学习笔记_爬虫数据存储为xlsx格式的方法
import requests from bs4 import BeautifulSoup import openpyxl wb=openpyxl.Workbook() sheet=wb.active ...
- golang学习笔记17 爬虫技术路线图,python,java,nodejs,go语言,scrapy主流框架介绍
golang学习笔记17 爬虫技术路线图,python,java,nodejs,go语言,scrapy主流框架介绍 go语言爬虫框架:gocolly/colly,goquery,colly,chrom ...
- python学习笔记目录
人生苦短,我学python学习笔记目录: week1 python入门week2 python基础week3 python进阶week4 python模块week5 python高阶week6 数据结 ...
- Python学习笔记之基础篇(-)python介绍与安装
Python学习笔记之基础篇(-)初识python Python的理念:崇尚优美.清晰.简单,是一个优秀并广泛使用的语言. python的历史: 1989年,为了打发圣诞节假期,作者Guido开始写P ...
随机推荐
- bzoj千题计划111:bzoj1021: [SHOI2008]Debt 循环的债务
http://www.lydsy.com/JudgeOnline/problem.php?id=1021 如果A收到了B的1张10元,那么A绝对不会把这张10元再给C 因为这样不如B直接给C优 由此可 ...
- 一个愚蠢的python逻辑语法错误
这个事情再次佐证了一个莫名其妙的现象背后一定会有一个愚蠢到无以复加的错误的真理. 写python单元测试的时候发现一个莫名其妙的问题: def xmlStandander(self,s): retur ...
- JS比较两个数字大小
js不能直降比较两·个数大小,要先转化为整数再比较大小. parseInt()转化. 出处:http://www.jb51.net/article/98251.htm
- 配置SpringBoot-从日志系统配置说起
大小系统都需要打日志. 系统在不同环境下对日志的配置要求是不一样的 比如 开发本地: 直接输出到控制台 生产环境: 输出到文件或者额外的日志收集系统, 比如 graylog. (本文不探讨具体日志系统 ...
- Python的类变量和成员变量、类静态方法和类成员方法
先说明几个相关的术语:attribute.function.method. attribute:类对象的数据成员.我们经常会在Python代码出错时遇到:“AttributeError: 'My_Cl ...
- Strusts2笔记6--拦截器
拦截器: Struts2的大多数核心功能都是通过拦截器实现的.拦截器之所以称之为“拦截器”,是因为它可以在执行Action之前或之后拦截下用户请求,执行一些操作,以增强Action方法的功能. Str ...
- 【读书笔记::深入理解linux内核】内存寻址【转】
转自:http://www.cnblogs.com/likeyiyy/p/3837272.html 我对linux高端内存的错误理解都是从这篇文章得来的,这篇文章里讲的 物理地址 = 逻辑地址 – 0 ...
- select()函数用法三之poll函数
poll是Linux中的字符设备驱动中有一个函数,Linux 2.5.44版本后被epoll取代,作用是把当前的文件指针挂到等待队列,和select实现功能差不多. poll()函数:这个函数是某些U ...
- 使用PyMongo访问需要认证的MongoDB
Windows 10家庭中文版,Python 3.6.4,PyMongo 3.7.0,MongoDB 3.6.3,Scrapy 1.5.0, 前言 在Python中,使用PyMongo访问Mongod ...
- Scrapy:运行爬虫程序的方式
Windows 10家庭中文版,Python 3.6.4,Scrapy 1.5.0, 在创建了爬虫程序后,就可以运行爬虫程序了.Scrapy中介绍了几种运行爬虫程序的方式,列举如下: -命令行工具之s ...