
Go语言实战-爬取校花网图片
一、目标网站分析
爬取校花网http://www.xiaohuar.com/大学校花所有图片。

经过分析,所有图片分为四个页面,http://www.xiaohuar.com/list-1-0.html,到 http://www.xiaohuar.com/list-1-3.html。
二、go代码实现
// 知识点

// 1. http 的用法,返回数据的格式、编码

// 2. 正则表达式

// 3. 文件读写

package main

import (

	"bytes"

	"fmt"

	"io/ioutil"

	"net/http"

	"os"

	"path/filepath"

	"regexp"

	"strings"

	"sync"

	"time"

	"github.com/axgle/mahonia"

)

var workResultLock sync.WaitGroup

func check(e error) {

	if e != nil {

		panic(e)

	}

}

func ConvertToString(src string, srcCode string, tagCode string) string {

	srcCoder := mahonia.NewDecoder(srcCode)

	srcResult := srcCoder.ConvertString(src)

	tagCoder := mahonia.NewDecoder(tagCode)

	_, cdata, _ := tagCoder.Translate([]byte(srcResult), true)

	result := string(cdata)

	return result

}

func download_img(request_url string, name string, dir_path string) {

	image, err := http.Get(request_url)

	check(err)

	image_byte, err := ioutil.ReadAll(image.Body)

	defer image.Body.Close()

	file_path := filepath.Join(dir_path, name+".jpg")

	err = ioutil.WriteFile(file_path, image_byte, 0644)

	check(err)

	fmt.Println(request_url + "\t下载成功")

}

func spider(i int, dir_path string) {

	defer workResultLock.Done()

	url := fmt.Sprintf("http://www.xiaohuar.com/list-1-%d.html", i)

	response, err2 := http.Get(url)

	check(err2)

	content, err3 := ioutil.ReadAll(response.Body)

	check(err3)

	defer response.Body.Close()

	html := string(content)

	html = ConvertToString(html, "gbk", "utf-8")

	// fmt.Println(html)

	match := regexp.MustCompile(`<img width="210".*alt="(.*?)".*src="(.*?)" />`)

	matched_str := match.FindAllString(html, -1)

	for _, match_str := range matched_str {

		var img_url string

		name := match.FindStringSubmatch(match_str)[1]

		src := match.FindStringSubmatch(match_str)[2]

		if strings.HasPrefix(src, "http") != true {

			var buffer bytes.Buffer

			buffer.WriteString("http://www.xiaohuar.com")

			buffer.WriteString(src)

			img_url = buffer.String()

		} else {

			img_url = src

		}

		download_img(img_url, name, dir_path)

	}

}

func main() {

	start := time.Now()

	dir := filepath.Dir(os.Args[0])

	dir_path := filepath.Join(dir, "images")

	err1 := os.MkdirAll(dir_path, os.ModePerm)

	check(err1)

	for i := 0; i < 4; i++ {

		workResultLock.Add(1)

		go spider(i, dir_path)

	}

	workResultLock.Wait()

	fmt.Println(time.Now().Sub(start))

}
编译
go build -o go_spider/xiaohua/xiaohua_spider.exe .\go_spider\xiaohua\main.go
运行go文件


下载的图片
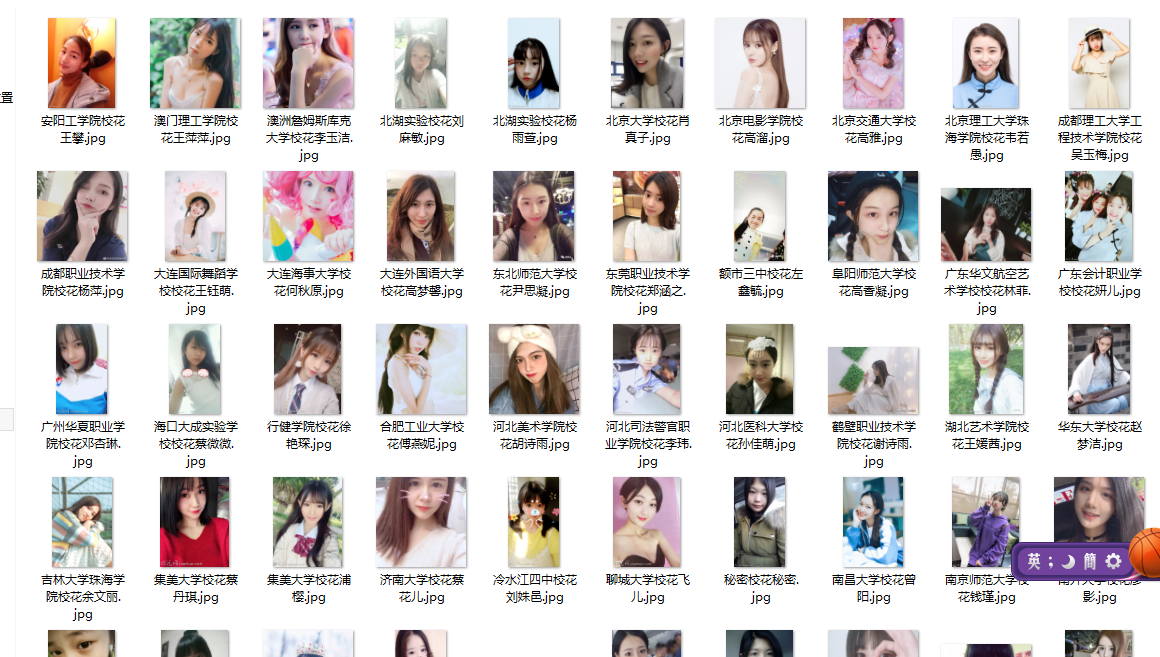
短短14秒钟下载了全部98张图片。看来go的速度就是这么快。
go第一次项目实战,成功!
Go语言实战-爬取校花网图片的更多相关文章
- python实战项目 — 爬取 校花网图片
重点: 1. 指定路径创建文件夹,判断是否存在 2. 保存图片文件 # 获得校花网的地址,图片的链接 import re import requests import time import os ...
- Scrapy爬虫框架之爬取校花网图片
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- python爬虫基础应用----爬取校花网视频
一.爬虫简单介绍 爬虫是什么? 爬虫是首先使用模拟浏览器访问网站获取数据,然后通过解析过滤获得有价值的信息,最后保存到到自己库中的程序. 爬虫程序包括哪些模块? python中的爬虫程序主要包括,re ...
- scrapy爬取校花网男神图片保存到本地
爬虫四部曲,本人按自己的步骤来写,可能有很多漏洞,望各位大神指点指点 1.创建项目 scrapy startproject xiaohuawang scrapy.cfg: 项目的配置文件xiaohua ...
- 第六篇 - bs4爬取校花网
环境:python3 pycharm 模块:requests bs4 urlretrieve os time 第一步:获取网页源代码 import requests from bs4 imp ...
- Python-爬取校花网视频(单线程和多线程版本)
一.参考文章 python爬虫爬取校花网视频,单线程爬取 爬虫----爬取校花网视频,包含多线程版本 上述两篇文章都是对校花网视频的爬取,由于时间相隔很久了,校花网上的一些视频已经不存在了,因此上述文 ...
- 爬取斗图网图片,使用xpath格式来匹配内容,对请求伪装成浏览器, Referer 防跨域请求
6.21自我总结 一.爬取斗图网 1.摘要 使用xpath匹配规则查找对应信息文件 将请求伪装成浏览器 Referer 防跨域请求 2.爬取代码 #导入模块 import requests #爬取网址 ...
- Requests 校花网图片爬取
纪念我们闹过的矛盾,只想平淡如水 import requestsimport reurl = 'http://www.xiaohuar.com/list-1-%s.html'for i in rang ...
- 二、Item Pipeline和Spider-----基于scrapy取校花网的信息
Item Pipeline 当Item在Spider中被收集之后,它将会被传递到Item Pipeline,这些Item Pipeline组件按定义的顺序处理Item. 每个Item Pipeline ...
随机推荐
- Jenkins实例 自由风格项目
目录 一.General 二.源码管理 三..构建触发器 四.构建环境 五.构建 六.构建后操作 一.General General是构建任务的一些基本配置.名称,描述之类的. 项目名称:是刚才创建构 ...
- 资源分配单位(Project)
<Project2016 企业项目管理实践>张会斌 董方好 编著 那些分配了资源的任务,其中的资源是有数量单位的,默认工时单位是100%,材料单位是1. 比如某吃货,为了完成吃米饭这一任务 ...
- sublime打开中文文件乱码以及打开文件出现.dump
一.中文乱码 原因:中文文件由gbk编码,刚安装的sublime不支持转码 解决方法:调用ctrl+shift+p,输入:install package,回车,在稍后弹出的安装包框中搜索:Conver ...
- java 图形化小工具Abstract Window Toolit 事件处理
事件处理设计到了三个对象: EventSource(事件源):事件发生的场所,通常就是各个组件,例如按钮.窗口,菜单等. Event (事件封装了GUI组件上发生的特定事情(通常就是一次用户操作).如 ...
- ACwing1212. 地宫取宝
题目: X 国王有一个地宫宝库,是 n×m 个格子的矩阵,每个格子放一件宝贝,每个宝贝贴着价值标签. 地宫的入口在左上角,出口在右下角. 小明被带到地宫的入口,国王要求他只能向右或向下行走. 走过某个 ...
- JAVA微信公众号网页开发——获取公众号关注的所有用户(微信公众号粉丝)
package com.weixin.sendmessage; import org.apache.commons.lang.StringUtils; import org.apache.http.H ...
- JAVA中数组(Array)、字符串(String)、集合(List、Set)相互转换
1.数组转List String[] arr = new String[]{"A", "B", "C"}; List list = Arra ...
- linux 设备文件的操作
文件:包含数据,具有属性,通过目录中的名字被标识, 可以从文件读数据,可以向文件写数据. 设备也支持文件的操作. 每个设备都被当作一个文件,具有文件名,i-节点号,文件所有者,权限位的集合,最新修改时 ...
- 【LeetCode】1222. Queens That Can Attack the King 解题报告 (C++)
作者: 负雪明烛 id: fuxuemingzhu 个人博客:http://fuxuemingzhu.cn/ 目录 题目描述 题目大意 解题方法 遍历 日期 题目地址:https://leetcode ...
- 【LeetCode】187. Repeated DNA Sequences 解题报告(Python)
作者: 负雪明烛 id: fuxuemingzhu 个人博客: http://fuxuemingzhu.cn/ 题目地址: https://leetcode.com/problems/repeated ...