
如何用elasticsearch构架亿级数据采集系统(第1集:非生产环境windows安装篇)
(一)做啥的?
基于Elasticsearch,可以为实现,大数据量(亿级)的实时统计查询的方案设计,提供底层数据框架。
本小节jacky会在非生产环境下,在 window 系统下,给大家分享着部分的相关内容。
(二)Elasticsearch的安装
2.1 版本选择:elasticsearch-rtf
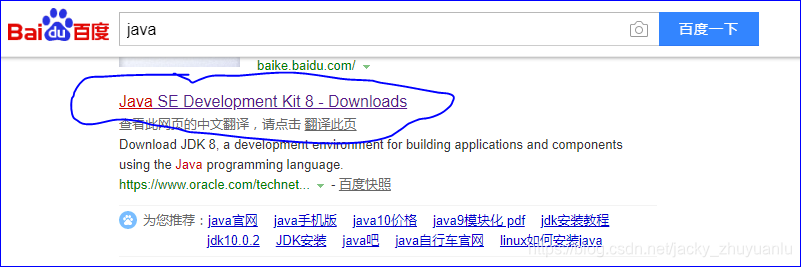
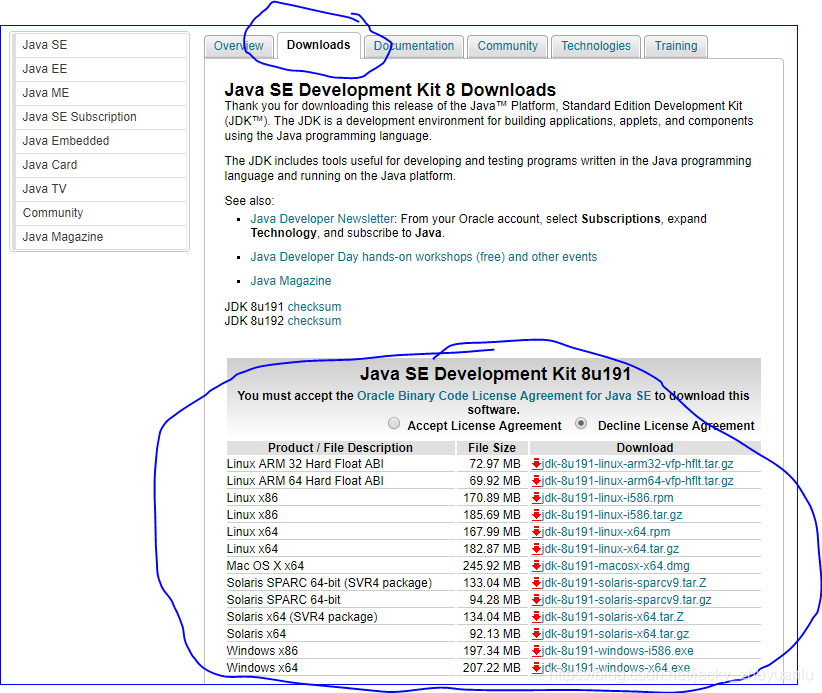
第1步:安装java
验证java是否安装成功:
- 这里java要兼容elasticsearch,必须安装java8以上的版本
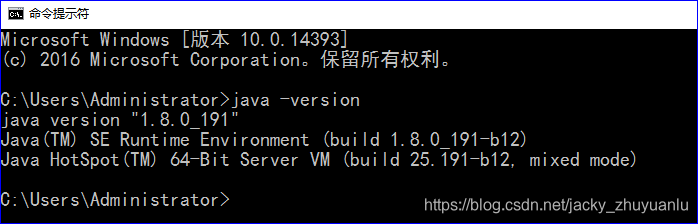
- 这里java要兼容elasticsearch,必须安装java8以上的版本
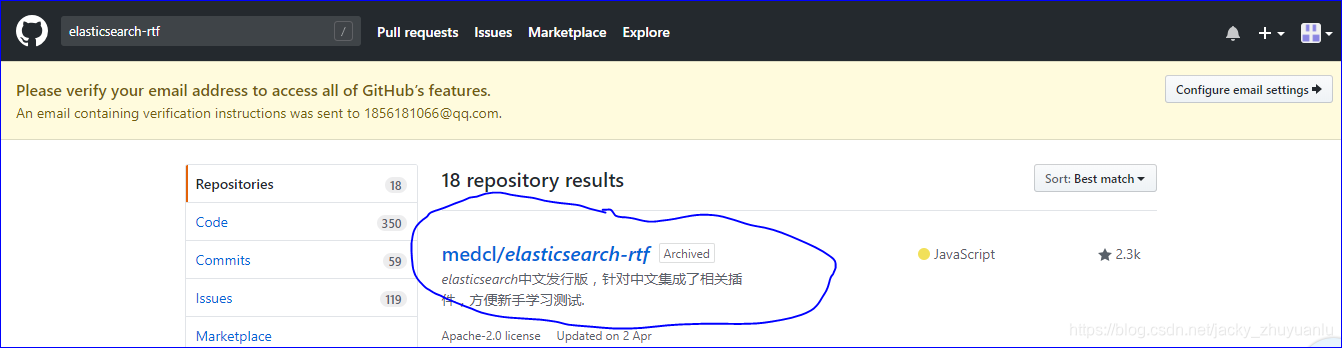
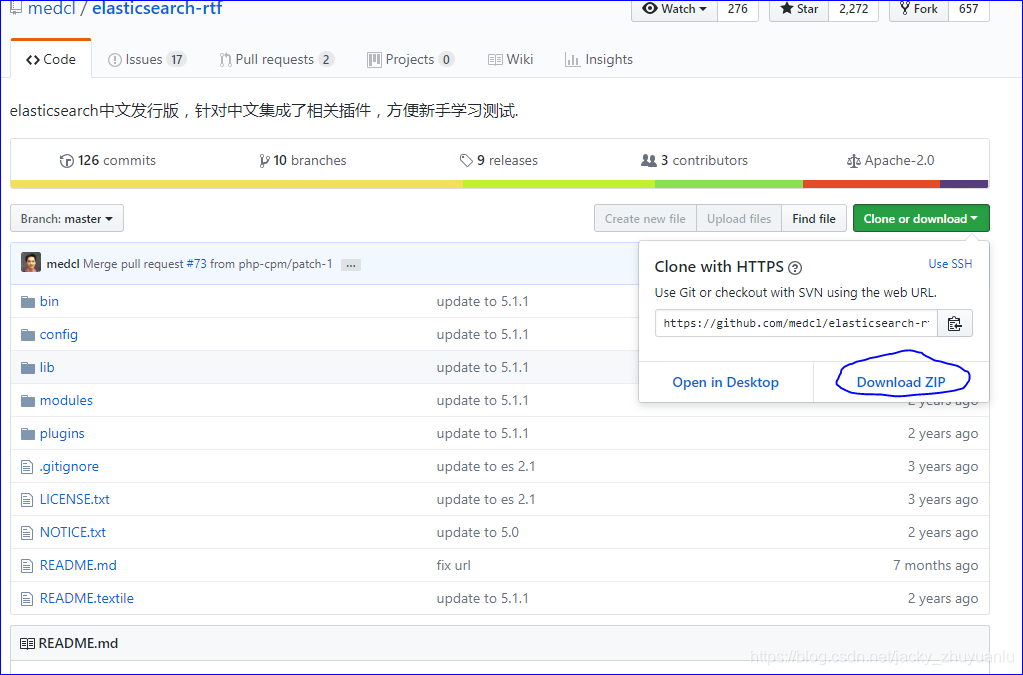
第2步:下载elasticsearch-rtf
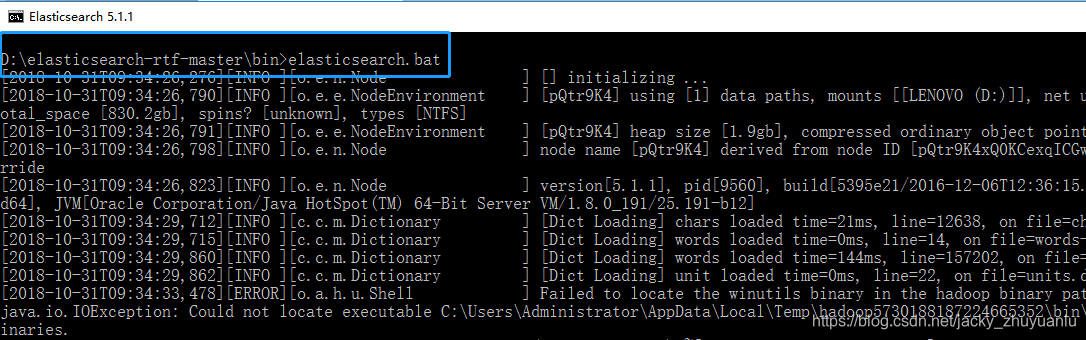
第3步:在bin目录下用命令行安装elasticsearch
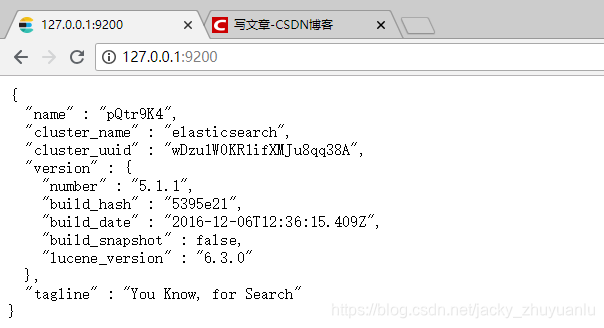
第4步:查看9200访问接口,如果看到以下界面,说明我们的elasticsearch就安装成功了
(三)head 插件的安装
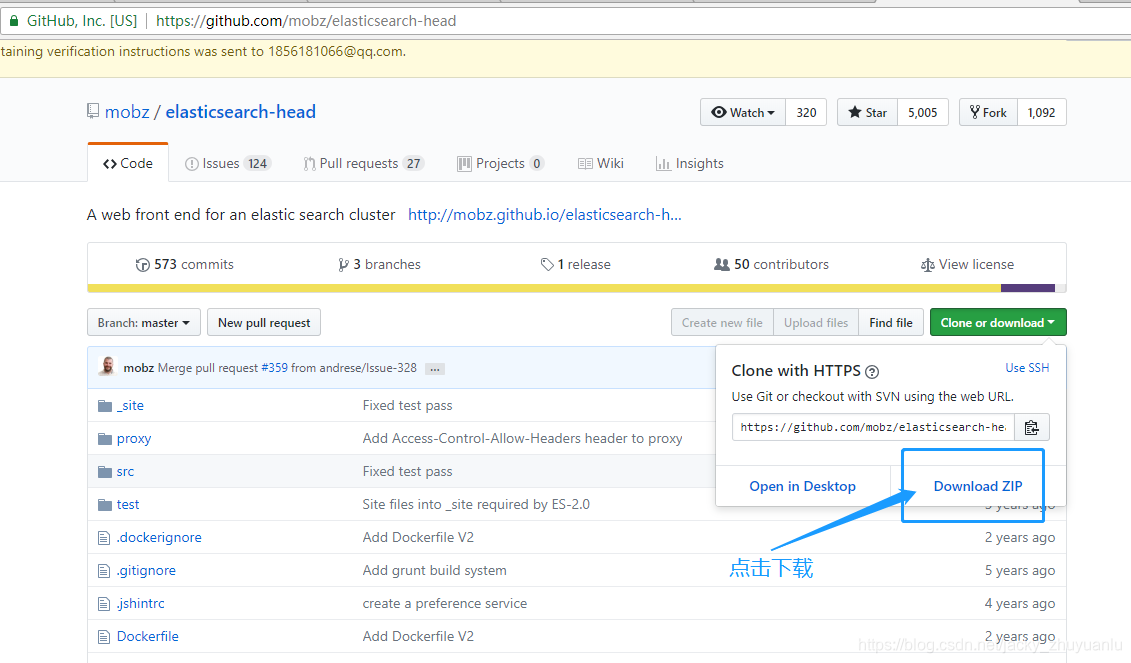
第1步,在github中下载head插件
第二步:下载npm
- 下载安装npm的前置环境-nodejs
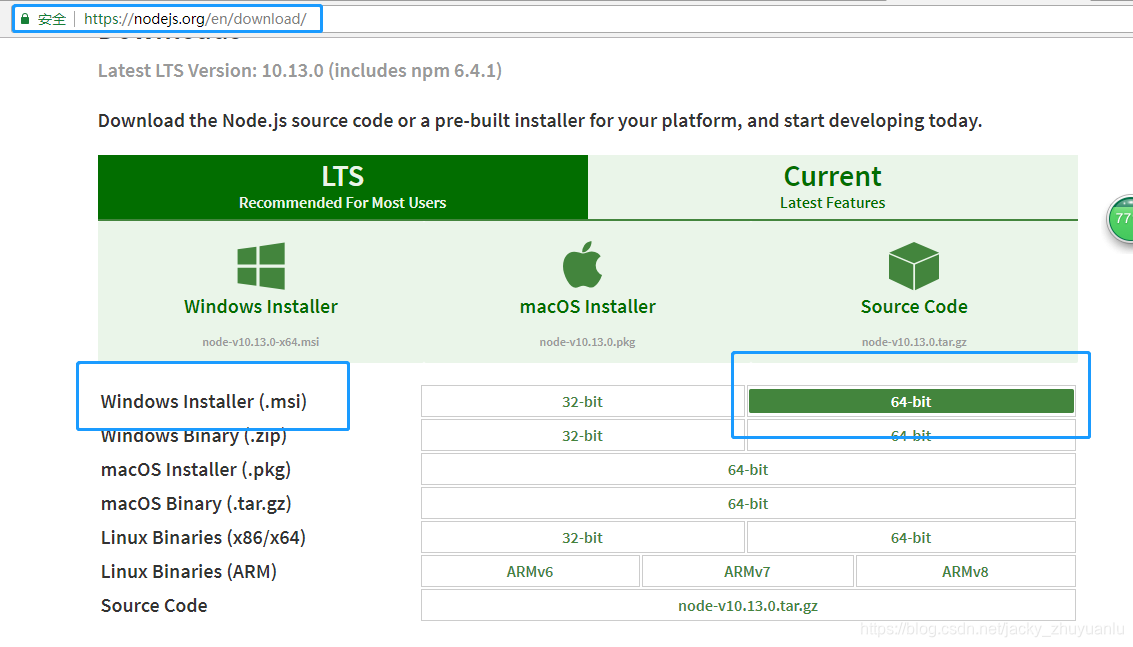
- 下载安装npm的前置环境-nodejs
验证npm是否下载成功
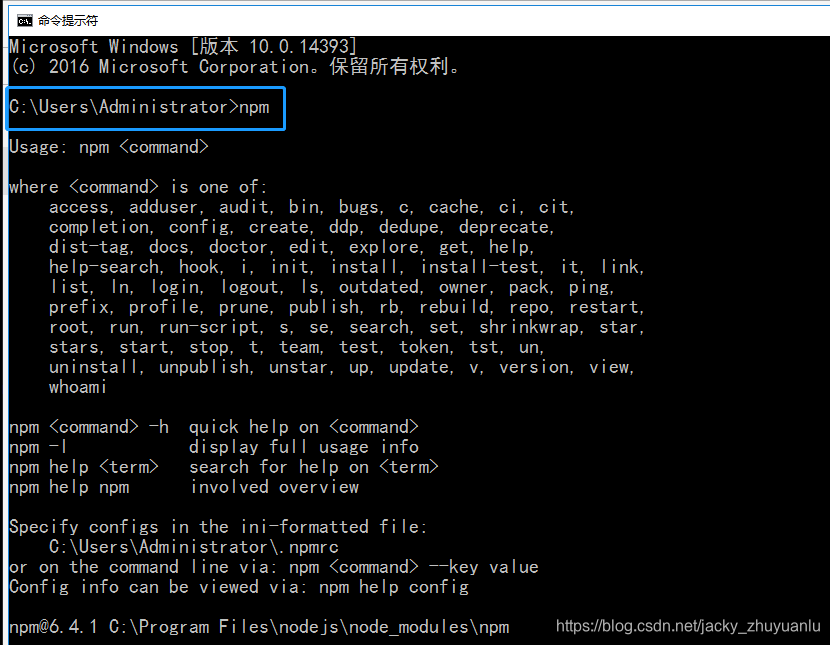
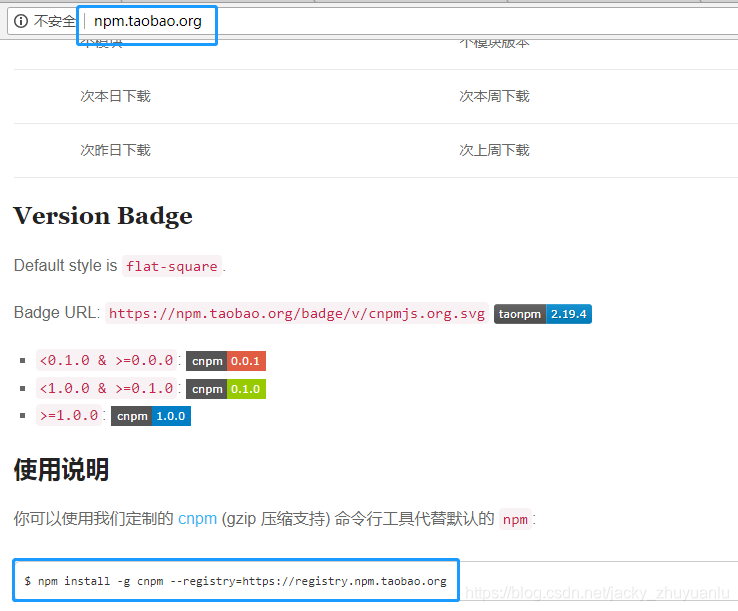
第三步:安装cnpm
npm就相当于python中的pip,中央仓库在国外,下载速度极慢,所以选择淘宝镜像的cnpm代替npm;
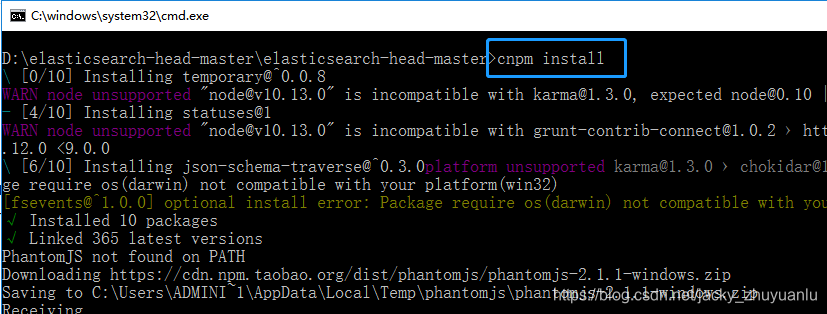
第4步:安装head插件
第5步 : 运行head插件
- head 文件下:cnpm run start
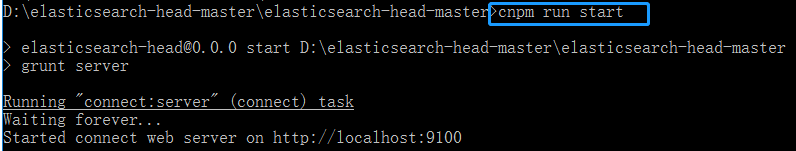
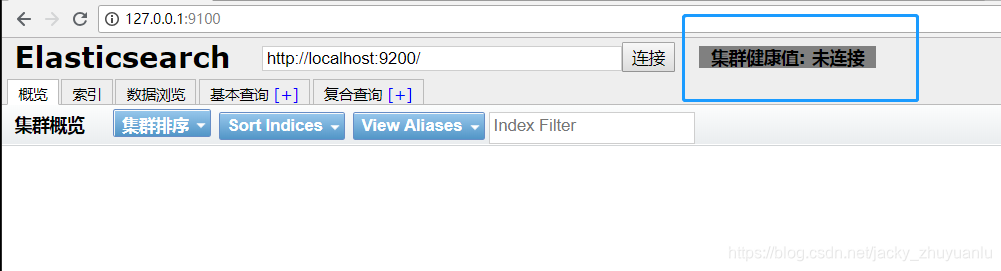
- head 文件下:cnpm run start
elasticsearch安全策略规定:elasitcsearch默认不允许使用第三方的服务,为了可以满足head这个代理服务可以访问elasticsearch,我们要对elasticsearch进行一些配置上的改动;
第6步 : 重新配置elasticsearch
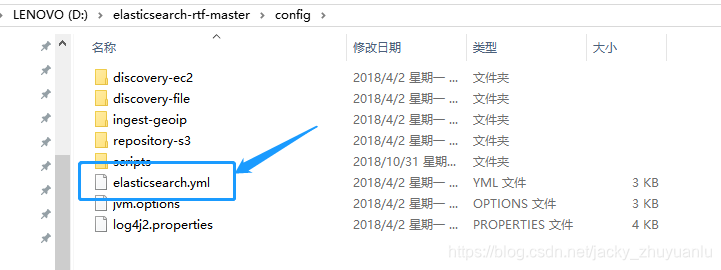
我们看到显示未连接,我们需要配置elasticsearch-rtf(搜索引擎)连接,在elasticsearch-rtf/config/elasticsearch.yml 这个文件里配置,在文件的最后面写入:
http.cors.enabled: true

http.cors.allow-origin: "*"

http.cors.allow-methods: OPTIONS, HEAD, GET, POST, PUT, DELETE
- 第7步:重启elasticsearch-rtf(搜索引擎)后就可以连接了
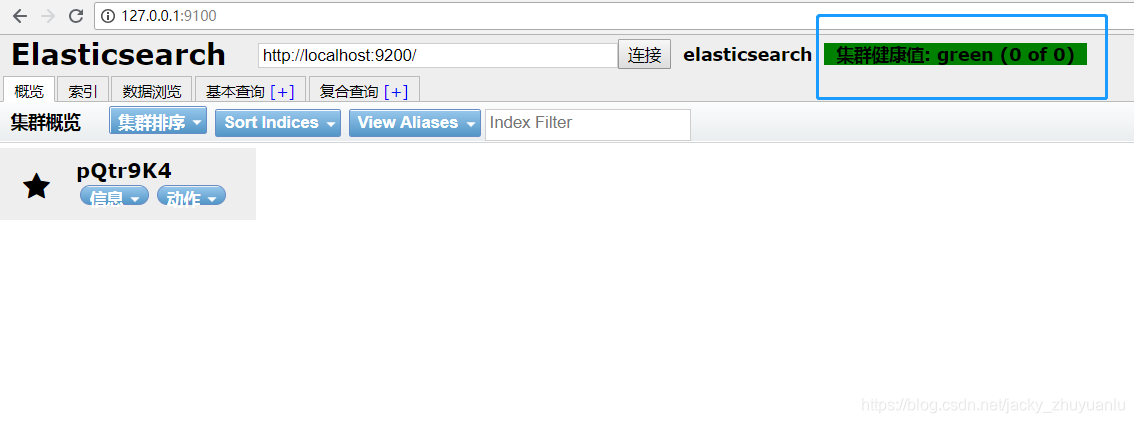
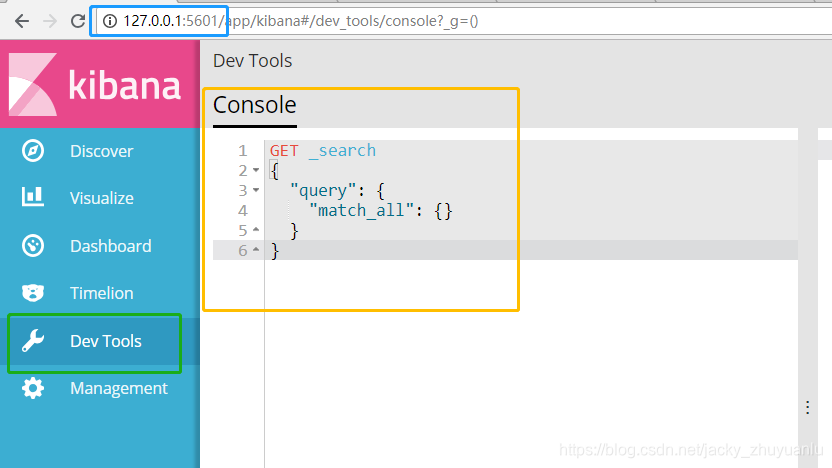
(四)Kibana 插件的安装
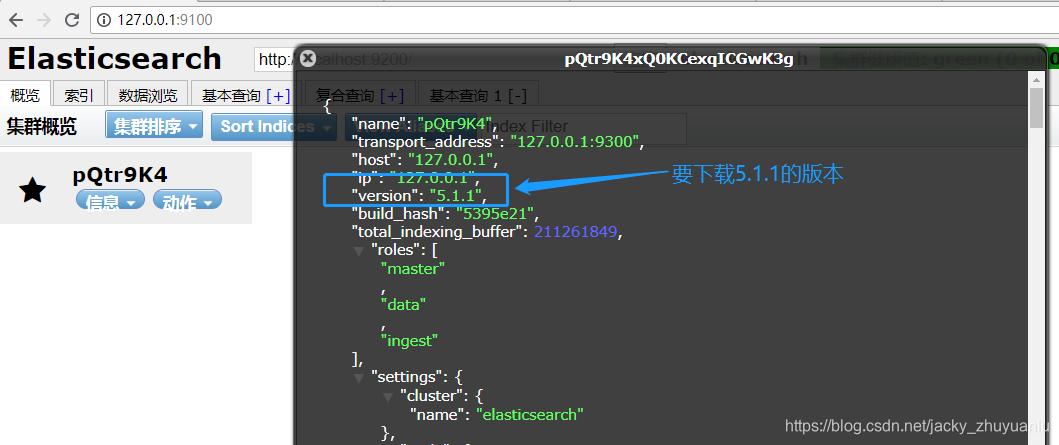
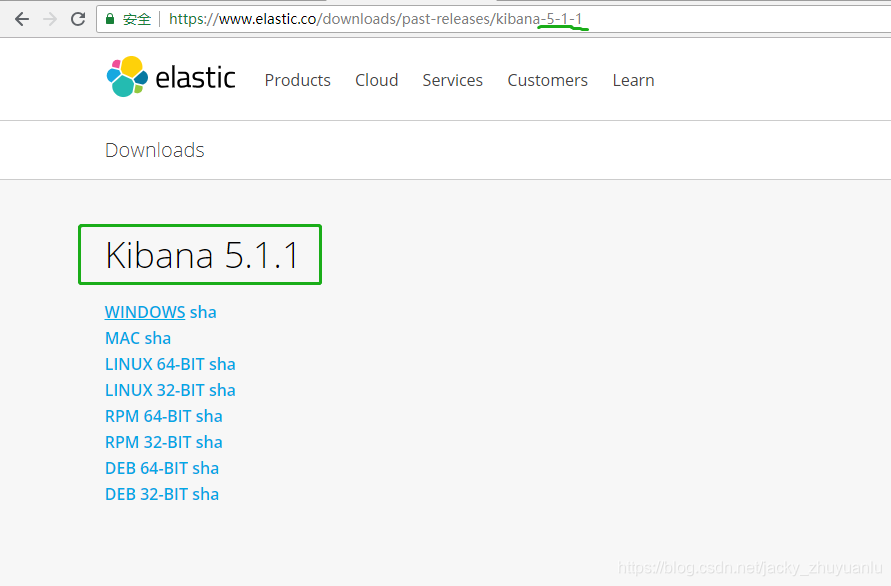
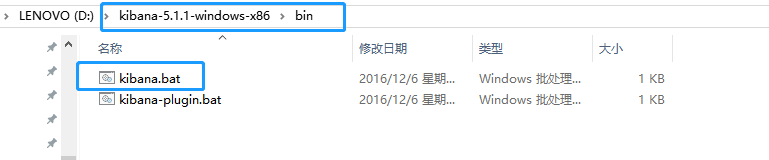
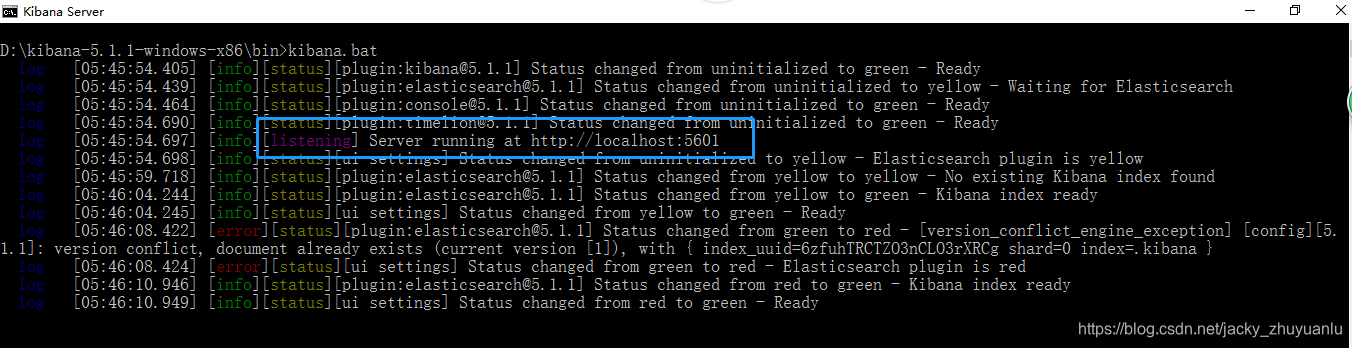
- 注意:Kibana的版本要对应elasticsearch-head里信息里的版本
如何用elasticsearch构架亿级数据采集系统(第1集:非生产环境windows安装篇)的更多相关文章
- MySQL使用pt-online-change-schema工具在线修改1.6亿级数据表结构
摘 要:本文阐述了MySQL DDL 的问题现状.pt-online-schema-change的工作原理,并实际利用pt-online-schema-change工具在线修改生产环境下1.6亿级数 ...
- 通用技术 mysql 亿级数据优化
通用技术 mysql 亿级数据优化 一定要正确设计索引 一定要避免SQL语句全表扫描,所以SQL一定要走索引(如:一切的 > < != 等等之类的写法都会导致全表扫描) 一定要避免 lim ...
- 不停机不停服务,MYSQL可以这样修改亿级数据表结构
摘 要:本文阐述了MySQL DDL 的问题现状.pt-online-schema-change的工作原理,并实际利用pt-online-schema-change工具在线修改生产环境下1.6亿级数 ...
- 基于Mysql数据库亿级数据下的分库分表方案
移动互联网时代,海量的用户数据每天都在产生,基于用户使用数据的用户行为分析等这样的分析,都需要依靠数据都统计和分析,当数据量小时,问题没有暴露出来,数据库方面的优化显得不太重要,一旦数据量越来越大时, ...
- Mongodb亿级数据量的性能测试
进行了一下Mongodb亿级数据量的性能测试,分别测试如下几个项目: (所有插入都是单线程进行,所有读取都是多线程进行) 1) 普通插入性能 (插入的数据每条大约在1KB左右) 2) 批量插入性能 ...
- 巧用redis位图存储亿级数据与访问 - 简书
原文:巧用redis位图存储亿级数据与访问 - 简书 业务背景 现有一个业务需求,需要从一批很大的用户活跃数据(2亿+)中判断用户是否是活跃用户.由于此数据是基于用户的各种行为日志清洗才能得到,数据部 ...
- NEO4J亿级数据导入导出以及数据更新
1.添加配置 apoc.export.file.enabled=true apoc.import.file.enabled=true dbms.directories.import=import db ...
- NEO4J亿级数据全文索引构建优化
NEO4J亿级数据全文索引构建优化 一.数据量规模(亿级) 二.构建索引的方式 三.构建索引发生的异常 四.全文索引代码优化 1.Java.lang.OutOfMemoryError 2.访问数据库时 ...
- Mybatis 使用分页查询亿级数据 性能问题 DB使用ORACLE
一般用到了mybatis框架分页就不用自己写了 直接用RowBounds对象就可以实现,但这个性能确实很低 今天我用到10w级得数据分页查询,到后面几页就迭代了很慢 用于记录 1.10万级数据如下 [ ...
随机推荐
- .net core使用ocelot---第八篇 Consul
简介 .net core使用ocelot---第一篇 简单使用 .net core使用ocelot---第二篇 身份验证使用 .net core使用ocelot---第三篇 日志记录 .net ...
- Java调用WebService方法总结(2)--JAX-WS调用WebService
用JAX-WS(Java API for XML Web Services)调用WebService不需要引入其他框架,都是JDK自带的:文中所使用到的软件版本:Java 1.8.0_191.Dom4 ...
- Jmeter学习笔记(十三)——xpath断言
1.什么是XPath断言 XPath即为XML路径语言,它是一种用来确定XML(标准通用标记语言的子集)文档中某部分位置的语言.XPath基于XML的树状结构,提供在数据结构树中找寻节点的能力. Ap ...
- JavaSE字符串日期与时间拼接小列子与JSON小列子
1.在对象中有个字段为Timestamp类型,需要将数据库的开始日期字段和开始时间字段拼接成一个字段开始字段 private static Timestamp getDateTime(String d ...
- CentOS7怎样安装Jenkins
参考 http://pkg.jenkins-ci.org/redhat/ wget -O /etc/yum.repos.d/jenkins.repo http://pkg.jenkins-ci.org ...
- ModelForm的简单使用-注册用modelform编写
1.前端的ajax代码不用改动 2.modelform,在原来基础上稍作改动 from django import forms from app01.models import UserInfo fr ...
- 用 Python 加密文件
生活中,有时候我们需要对一些重要的文件进行加密,Python 提供了诸如 hashlib,base64 等便于使用的加密库. 但对于日常学习而言,我们可以借助异或操作,实现一个简单的文件加密程序,从而 ...
- Scikit-learn库
1 简介 对Python语言有所了解的科研人员可能都知道SciPy——一个开源的基于Python的科学计算工具包.基于SciPy,目前开发者们针对不同的应用领域已经发展出了为数众多的分支版本,它们被统 ...
- DT二次开发之-采购页面加入好看的倒计时
加入采购页面倒计时,个人感觉挺漂亮的,做下笔记. <span id="timer" ></span> {if $totime} <script typ ...
- django项目部署服务器后无法发送邮箱 错误信息:Connection unexpectedly closed
使用配置: python 3.7 + django 2.2.1 发送邮件模块 : from django.core.mail import send_mail 服务器:Centos7 阿里云轻 ...