
ubuntu之路——day9.2 Covariate shift问题和Batch Norm的解决方案
Batch Norm的意义:Covariate shift的问题
在传统的机器学习中,我们通常会认为source domain和target domain的分布是一致的,也就是说,训练数据和测试数据是满足相同分布的。这是通过训练数据获得的模型能够在测试集上获得好的效果的一个基本保障。
Convariate Shift是指训练集的样本数据和目标样本集分布不一致时,训练得到的模型无法很好的Generalization。它是分布不一致假设之下的一个分支问题,也就是指Sorce Domain和Target Domain的条件概率一致的,但是其边缘概率不同。的确,对于神经网络的各层输出,在经过了层内操作后,各层输出分布就会与对应的输入信号分布不同,而且差异会随着网络深度增大而加大了,但每一层所指向的Label仍然是不变的。
解决办法:一般是根据训练样本和目标样本的比例对训练样本做一个矫正。所以,通过引入Bactch Normalization来标准化某些层或者所有层的输入,从而固定每层输入信息的均值和方差。
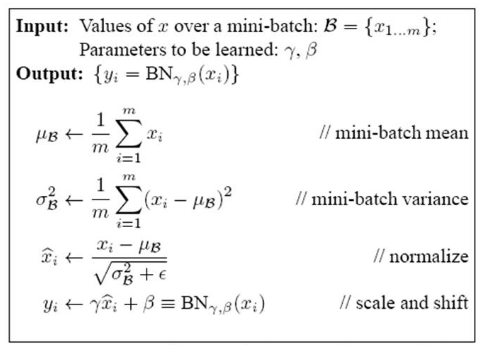
BN的本质:对于每个隐层神经元,把逐渐向非线性函数映射后向取值区间极限饱和区靠拢的输入分布强制拉回到均值为0方差为1的比较标准的正态分布,使得非线性变换函数的输入值落入对输入比较敏感的区域,以此避免梯度消失问题。
详情请参照:https://www.cnblogs.com/guoyaohua/p/8724433.html这位博主的文章详细介绍了Batch Norm的操作过程
在深度网络中BN相当于在z=wx+b和a = ξ(z)中间添加了一个z~= BN(z)的过程
BatchNorm在深度网络中的应用:
for t = 1, 2,...,n(n = mini-batch size)
compute forward prop on mini-batch X{t}
in each hidden layer,using BatchNorm to replace Z[l] with Z~[l]
use back prop to compute dw[l],db[l],dβ[l],dγ[l]
update parameters :w[l] := w - αdw[l]
β[l] := β - αdβ[l]
γ[l] := γ - αdγ[l] 注意参数更新的过程可以使用momentum、RMSprop、Adam代替
ubuntu之路——day9.2 Covariate shift问题和Batch Norm的解决方案的更多相关文章
- ubuntu之路——day9.3 softmax regression激活函数
Softmax 用于在深度学习中处理多分类(C > 2)问题,分类器最后的输出单元需要Softmax 函数进行数值处理.关于Softmax 函数的定义如下所示: 其中vi表示 vi = z[L] ...
- ubuntu之路——day9.1 深度学习超参数的调优
参数重要性: 第一阶:α即learning rate 第二阶:momentum中的β,hidden units的数量,mini-batch的大小 第三阶:hidden layers的数量,learni ...
- 图像分类(二)GoogLenet Inception_v2:Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift
Inception V2网络中的代表是加入了BN(Batch Normalization)层,并且使用 2个 3*3卷积替代 1个5*5卷积的改进版,如下图所示: 其特点如下: 学习VGG用2个 3* ...
- Batch normalization:accelerating deep network training by reducing internal covariate shift的笔记
说实话,这篇paper看了很久,,到现在对里面的一些东西还不是很好的理解. 下面是我的理解,当同行看到的话,留言交流交流啊!!!!! 这篇文章的中心点:围绕着如何降低 internal covari ...
- Batch Normalization原理及其TensorFlow实现——为了减少深度神经网络中的internal covariate shift,论文中提出了Batch Normalization算法,首先是对”每一层“的输入做一个Batch Normalization 变换
批标准化(Bactch Normalization,BN)是为了克服神经网络加深导致难以训练而诞生的,随着神经网络深度加深,训练起来就会越来越困难,收敛速度回很慢,常常会导致梯度弥散问题(Vanish ...
- Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift
1. 摘要 训练深层的神经网络非常困难,因为在训练的过程中,随着前面层数参数的改变,每层输入的分布也会随之改变.这需要我们设置较小的学习率并且谨慎地对参数进行初始化,因此训练过程比较缓慢. 作者将这种 ...
- 论文笔记:Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift
ICML, 2015 S. Ioffe and C. Szegedy 解决什么问题(What) 分布不一致导致训练慢:每一层的分布会受到前层的影响,当前层分布发生变化时,后层网络需要去适应这个分布,训 ...
- Batch Normalization:Accelerating Deep Network Training by Reducing Internal Covariate Shift(BN)
internal covariate shift(ics):训练深度神经网络是复杂的,因为在训练过程中,每层的输入分布会随着之前层的参数变化而发生变化.所以训练需要更小的学习速度和careful参数初 ...
- Deep Learning 27:Batch normalization理解——读论文“Batch normalization: Accelerating deep network training by reducing internal covariate shift ”——ICML 2015
这篇经典论文,甚至可以说是2015年最牛的一篇论文,早就有很多人解读,不需要自己着摸,但是看了论文原文Batch normalization: Accelerating deep network tr ...
随机推荐
- 解决问题 inner element must either be a resource reference or empty.
-Q: 错误<item>内部元素必须是资源引用或空 升级Andriod Studio之后编译发现如下错误 Android resource compilation failed ***\a ...
- HashMap的put()与扩容
1. put() final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { HashMap.Nod ...
- MySQL Backup--innobackupex操作日志
备份脚本: innobackupex \ --defaults-file="/export/servers/mysql/etc/my.cnf" \ --host="loc ...
- 大数据技术之Hadoop3.1.2版本HA模式
大数据技术之Hadoop3.1.2版本HA模式 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Hadoop的HA特点 1>.主备NameNode 2>.解决单点故障 ...
- 基于STM8的IIC协议--实例篇--时钟模块(DS3231)读取
1. 综述 由上篇博客可知道IIC协议如何用代码实现,本篇博客就不涉及协议内容,只讲解如何使用. 本次的实验传感为:DS3231(时钟模块),对于时钟模块的具体信息我也就不多介绍,大家可以自行度娘,具 ...
- jmeter + ant + jenkins 自动化集成环境搭建
所需工具 一.jmeter 工具下载 https://jmeter.apache.org/ 配置环境JDK等及各种插件 二.Ant安装(http://ant.apache.org/) 安装Ant是为 ...
- 51nod 2517 最少01翻转次数
小b有一个01序列,她每次可以翻转一个元素,即将该元素异或上1. 现在她希望序列不降,求最少翻转次数. 收起 输入 第一行输入一个数n,其中1≤n≤20000: 第二行输入一个由‘0’和‘1’组成 ...
- 结构型模式(六) 享元模式(Flyweight)
一.动机(Motivate) 在软件系统中,采用纯粹对象方案的问题在于大量细粒度的对象会很快充斥在系统中,从而带来很高的运行时代价--主要指内存需求方面的代价.如何在避免大量细粒度对象问题的同时,让外 ...
- 结构型模式(三) 装饰模式(Decorator)
一.动机(Motivate) 在房子装修的过程中,各种功能可以相互组合,来增加房子的功用.类似的,如果我们在软件系统中,要给某个类型或者对象增加功能,如果使用"继承"的方案来写代码 ...
- 软件测试过程中如何区分什么是功能bug,什么是需求bug,什么是设计bug?
问题描述: 测试过程中如何区分什么是功能bug,什么是需求bug,什么是设计bug? 精彩答案: 会员 土土的豆豆: 本期问题其实主要是针对不同方面或纬度上对于bug的一个归类和定位. 个人认为,从软 ...