
hadoop综合
对CSV文件进行预处理生成无标题文本文件,将爬虫大作业产生的csv文件上传到HDFS
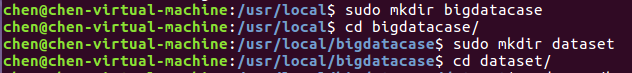
首先,我们需要在本地中创建一个/usr/local/bigdatacase/dataset文件夹,具体的步骤为:
① cd /usr/local
② sudo mkdir bigdatacase
③ cd bigdatacase/
④ sudo mkdir dataset
⑤ cd dataset/
如下图所示:
其次,我们把lagoupy.csv文件放到下载这个文件夹中,并使用命令把lagoupy.csv文件拷贝到我们刚刚所创建的文件夹中,具体步骤如下:
① sudo cp /home/chen/下载/lagoupy.csv /usr/local/bigdatacase/dataset/ #把lagoupy.csv文件拷到刚刚所创建的文件夹中
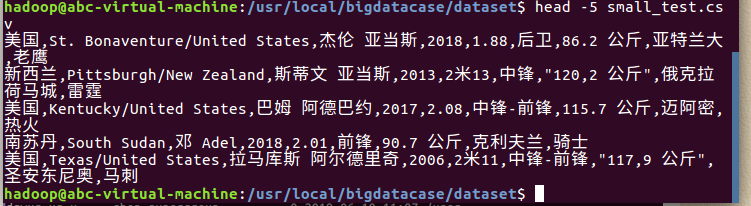
② head -5 small_test.csv #查看这个文件的前五行

对CSV文件进行预处理生成无标题文本文件,步骤如下:
① sudo sed -i '1d' lagoupy.csv #删除第一行记录
② head -5 small_test.csv #查看前五行记录
如下图所示:
接着,启动hadoop,步骤如下:
① start-all.sh #启动hadoop
② jps #查看hadoop是否启动成功
如下图所示:

最后,我们把本地的文件上传至HDFS中,步骤如下:
① hdfs dfs -mkdir -p /bigdatacase/dataset #在hdfs上新建/bigdatacase/dataset
② hdfs dfs -ls /
③ hdfs dfs -put ./lagoupy.csv /bigdatacase/dataset #把本地文件small_test.csv上传至hdfs中
④ hdfs dfs -ls /bigdatacase/dataset #查看
⑤ hdfs dfs -cat /bigdatacase/dataset/small_test.csv | head -5 #查看hdfs中small_test.csv的前五行
如下图所示:

把hdfs中的文本文件最终导入到数据仓库Hive中
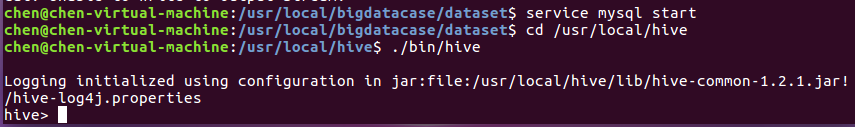
首先,启动hive,步骤如下:
① service mysql start #启动mysql数据库
② cd /usr/local/hive
③ ./bin/hive #启动hive
如下图所示:
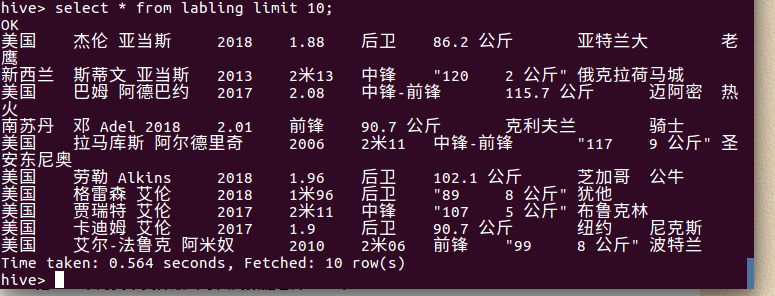
① create database db; -- 创建数据库dbpy
② use db;
③ create external table labling
④ select * from labling limit 10; -- 查看lagou_py中前10行的数据
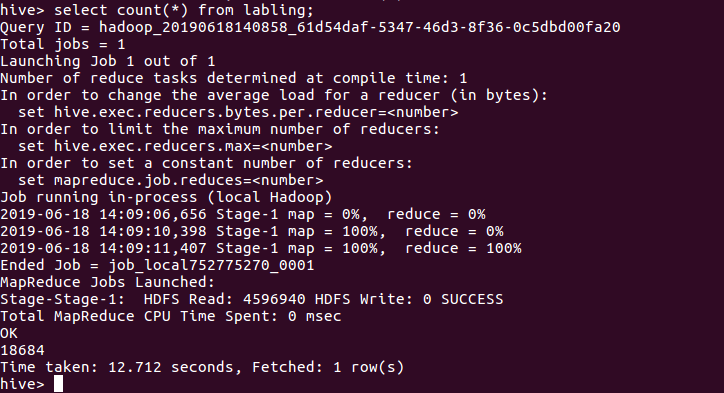
查询条数统计分析
用聚合函数count()计算出表内有多少条行数据 hive> select count(*) from labling;
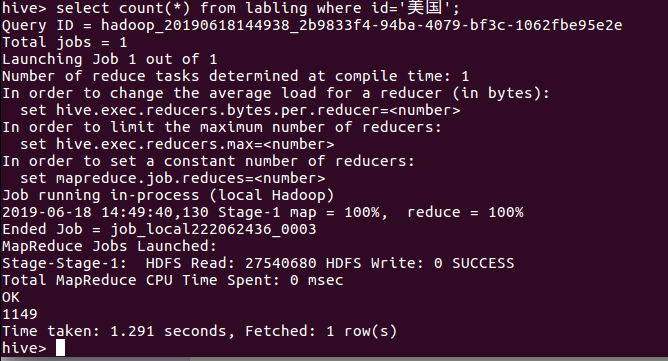
美国国籍的球员数:
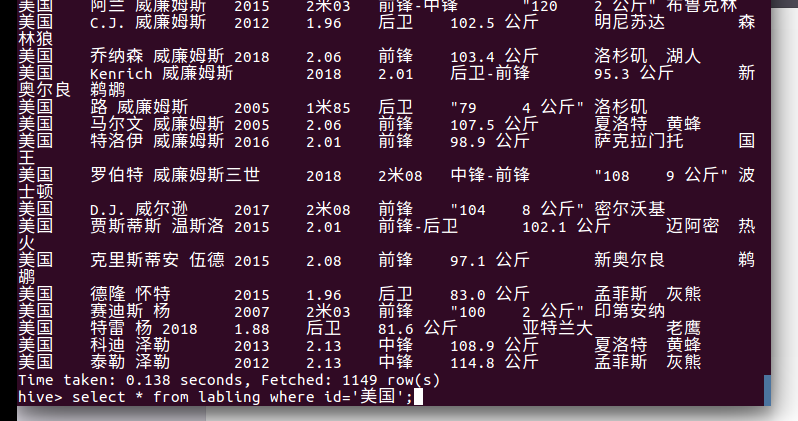
美国国籍的球员:
查询老鹰的球员:
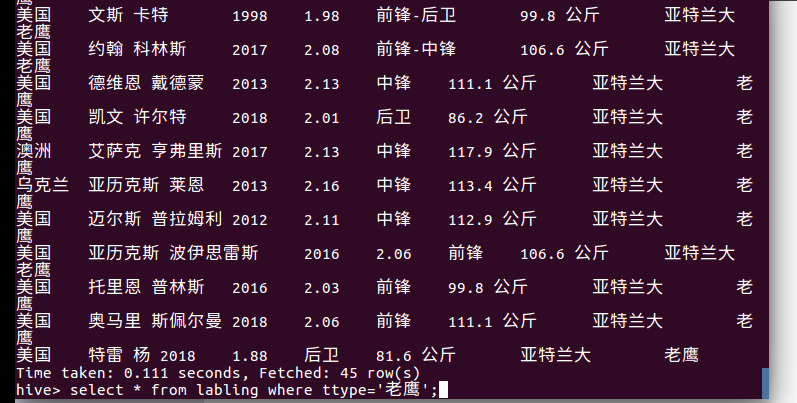
查询老鹰的球员数:
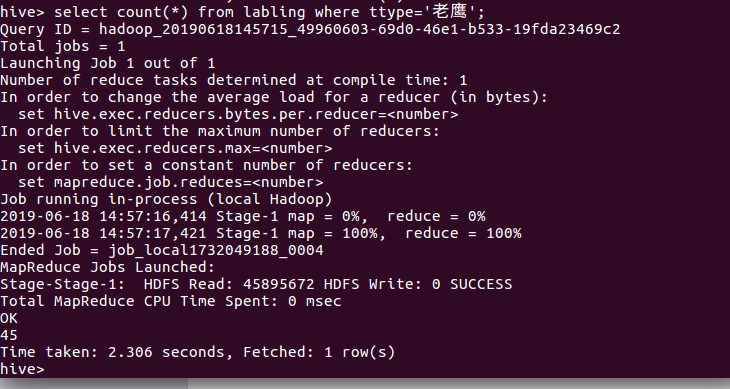
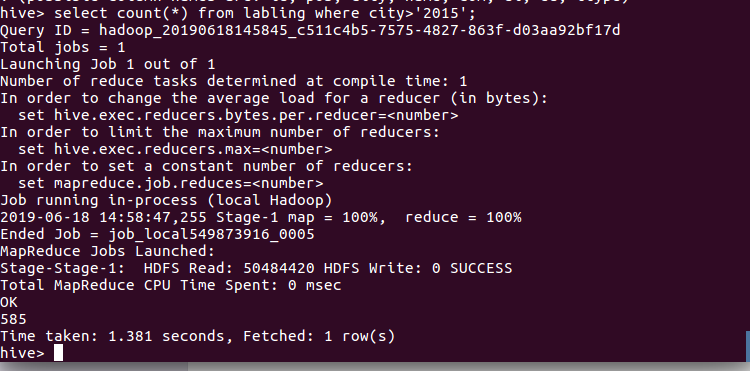
查询球员2015年以后进入NBA的人数:
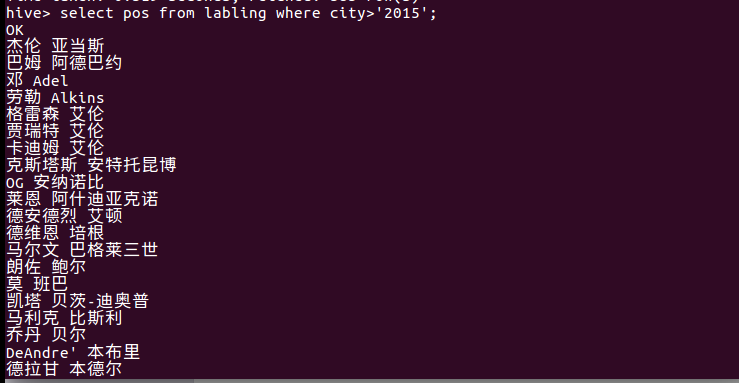
查询2015年以后进入NBA球员的名字
hadoop综合的更多相关文章
- Hadoop综合大作业
Hadoop综合大作业 要求: 用Hive对爬虫大作业产生的文本文件(或者英文词频统计下载的英文长篇小说)词频统计. 用Hive对爬虫大作业产生的csv文件进行数据分析 1. 用Hive对爬虫大作业产 ...
- Hadoop 综合揭秘——HBase的原理与应用
前言 现今互联网科技发展日新月异,大数据.云计算.人工智能等技术已经成为前瞻性产品,海量数据和超高并发让传统的 Web2.0 网站有点力不从心,暴露了很多难以克服的问题.为此,Google.Amazo ...
- Hadoop 综合揭秘——MapReduce 基础编程(介绍 Combine、Partitioner、WritableComparable、WritableComparator 使用方式)
前言 本文主要介绍 MapReduce 的原理及开发,讲解如何利用 Combine.Partitioner.WritableComparator等组件对数据进行排序筛选聚合分组的功能.由于文章是针对开 ...
- 大数据应用期末总评——Hadoop综合大作业
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 Hadoop综合大作业 要求: 1.将爬虫大作业产生的csv文件 ...
- 【大数据应用期末总评】Hadoop综合大作业
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 一.Hadoop综合大作业 要求: 1.将爬虫大作业产生的csv ...
- 《Hadoop综合大作业》
作业要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 我主要的爬取内容是关于热门微博文章“996”与日剧<我要 ...
- 菜鸟学IT之Hadoop综合大作业
Hadoop综合大作业 作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 1.将爬虫大作业产生的csv文件上传到HDF ...
- 大数据应用期末总评Hadoop综合大作业
作业要求来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 1.将爬虫大作业产生的csv文件上传到HDFS 此次作业选取的 ...
- Hadoop综合大作业1
本次作业来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 一.课程评分标准: 分数组成: 考勤 10 平时作业 30 爬 ...
- 【大数据应用技术】作业十二|Hadoop综合大作业
本次作业的要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 前言 本次作业是在<爬虫大作业>的基础上进行的 ...
随机推荐
- JQ实现购物车全选跟总计全选
//GoodsCheck购物车每个店铺的checkBox//goods-check购物车所有的checkBox//ShopCheck店铺全选的按钮//commlistFrm店铺商品的模块//allCh ...
- WPF弹出进度条
环境:vs2015 ,.net 4.6 源码地址:https://pan.baidu.com/s/1FoujUMst1luomPf0ZfCLUQ 提取码:trzj 说明: 1.进度条是在winFrom ...
- VS2017 密钥
需要的请自取- Enterprise: NJVYC-BMHX2-G77MM-4XJMR-6Q8QF Professional: KBJFW-NXHK6-W4WJM-CRMQB-G3CDH
- 深入理解JVM-hotspot虚拟机对象探秘
1.背景与大纲 在我们了解了java虚拟机的运行时数据区后,我们大概知道了虚拟机内存的概况,但是我们还是不清楚具体怎么存放的访问的: 接下来,我们将深入探讨HotSport虚拟机在java堆中对象的分 ...
- SQL必知必会实践--mysql
-- mysql安装 -- https://www.mysql.com/downloads/
- MySQL/MariaDB数据库的主主复制
MySQL/MariaDB数据库的主主复制 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.主主复制概述 1>.什么是主主复制 所谓的主主复制,说白了就是两台节点互为 ...
- CentOS Linux更改MySQL数据库目录位置
引言: 由于MySQL的数据库太大,默认安装的/var盘已经再也无法容纳新增加的数据,没有办法,只能想办法转移数据的目录. 下面我整理一下把MySQL从/var/lib/mysql目录下面转移到/ho ...
- Codeforces C. Jzzhu and Cities(dijkstra最短路)
题目描述: Jzzhu and Cities time limit per test 2 seconds memory limit per test 256 megabytes input stand ...
- selenium常用的API(四)设置get方法最大加载时间
我们在进行自动化测试的时候,使用get方法打开页面时会等到页面完全加载完才会执行后续操作, 有时我们需要的元素已加载完成,而部分JS未加载完导致加载时间很长,这无疑增加了自动化测试的时间, 针对此情况 ...
- ML.NET学习笔记 ---- 系列文章
机器学习框架ML.NET学习笔记[1]基本概念与系列文章目录 机器学习框架ML.NET学习笔记[2]入门之二元分类 机器学习框架ML.NET学习笔记[3]文本特征分析 机器学习框架ML.NET学习笔记 ...