
大数据应用期末总评——Hadoop综合大作业
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339
Hadoop综合大作业 要求:
1.将爬虫大作业产生的csv文件上传到HDFS
此处选取的是爬虫大作业——对猫眼电影上《小偷家族》电影的影评。
此处选取的是comment.csv文件,共计20865条数据。
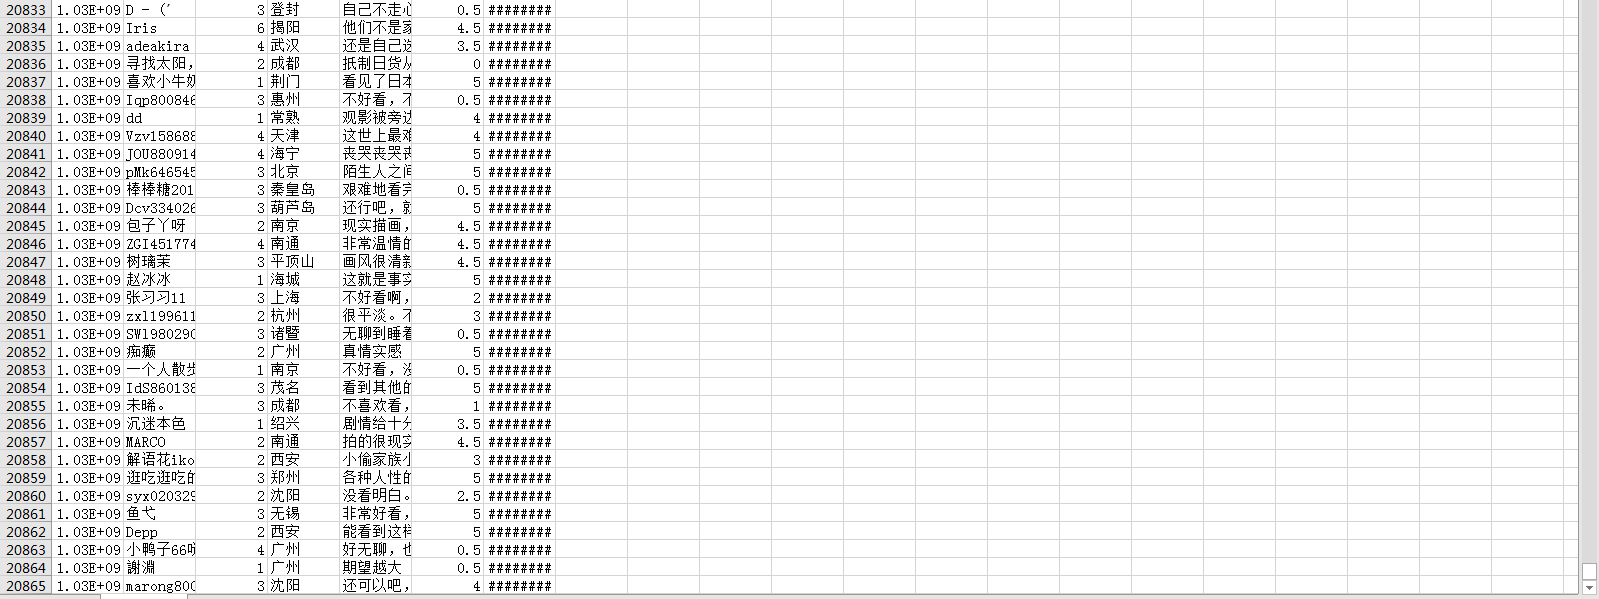
将comment.csv上传到HDFS
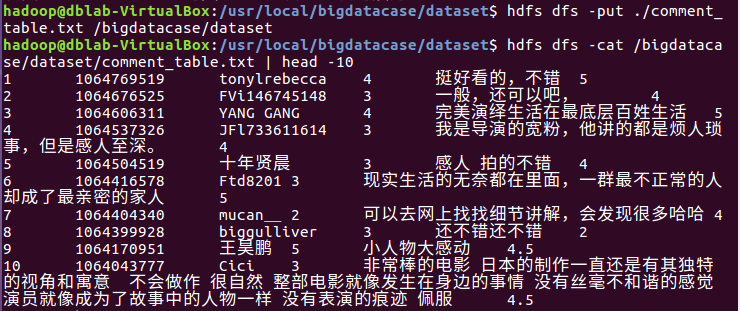
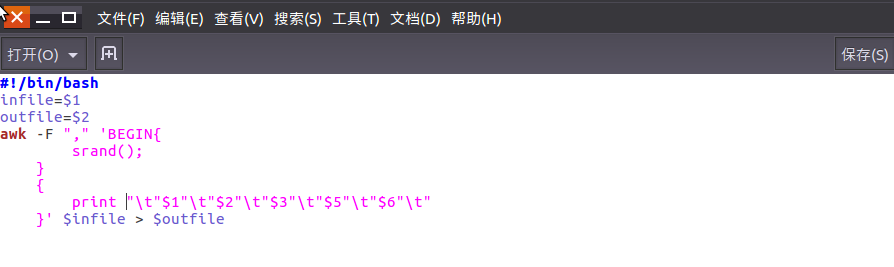
2.对CSV文件进行预处理生成无标题文本文件
编辑pre_deal.sh文件对csv文件进行数据预处理。
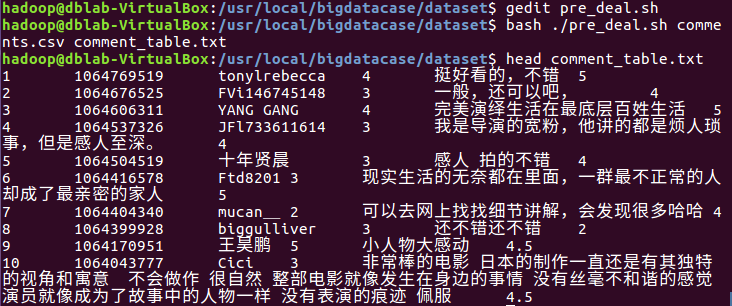
使得pre_deal.sh中的内容生效。
3.把hdfs中的文本文件最终导入到数据仓库Hive中
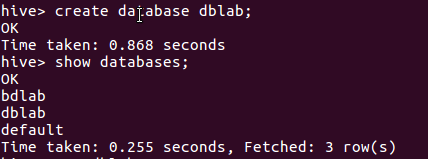
创建数据库dblab;
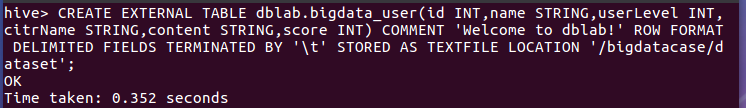
在数据库dblab中创建相应的表,此处是bigdata_user。
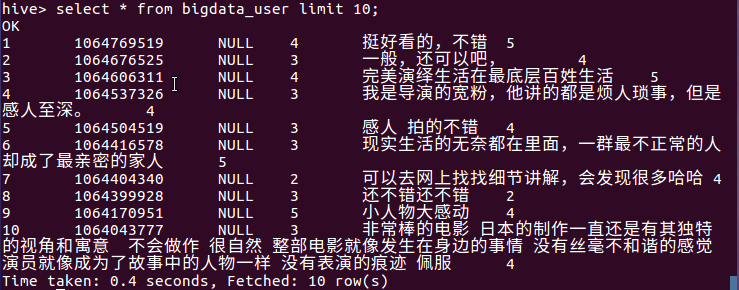
4.在Hive中查看并分析数据
5.用Hive对爬虫大作业产生的进行数据分析,写一篇博客描述你的分析过程和分析结果。(10条以上的查询分析)
- 查询前20位猫眼电影用户对《小偷家族》电影的评分
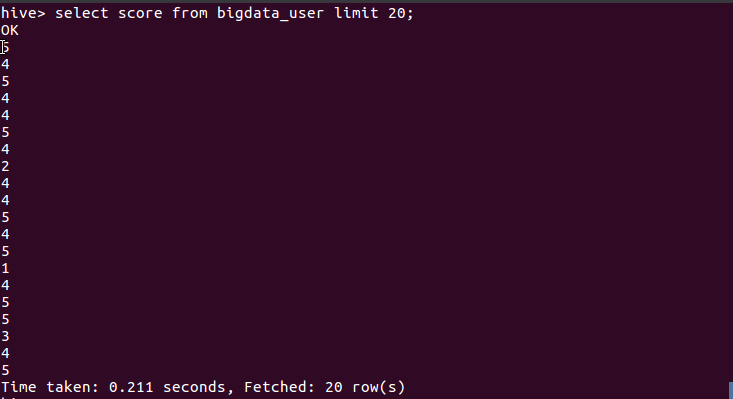
由上图可以看出大部分用户评分都在4分以上(5分评分为满分),这也就说明大部分用户对此部电影的评价都非常高。
- 查询给此电影1分评分的用户的评论

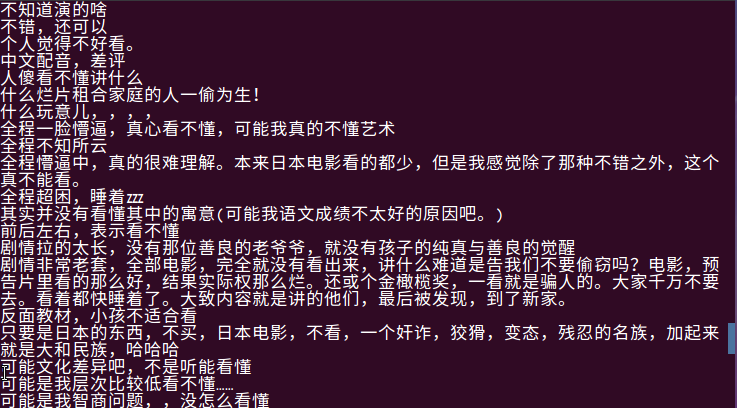
由上图可以看出给低分评价的用户多半为没看懂与难以理解所给出的低评分,由此可以得出用户对于电影的理解都不完全相同,一千个读者就有一千个哈姆雷特,大部分用户都是靠着主观意识来给与电影评分。
- 查询给此电影5分评分的用户的评论

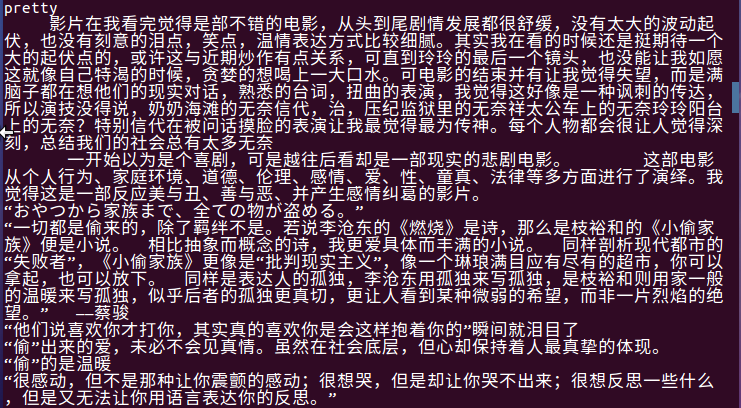
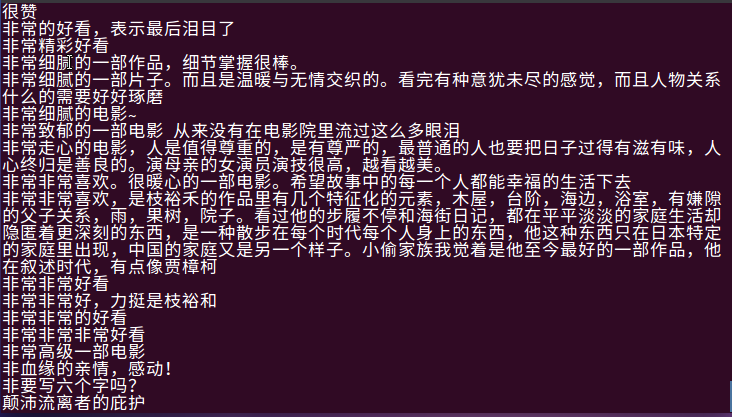
由5分评价也可以得出此部电影的主旨与想向观众表达的东西,可看出此部电影主要是围绕着亲情,感动为主题来叙述的。
- 查询对比5评分用户与1分评分用户的人数
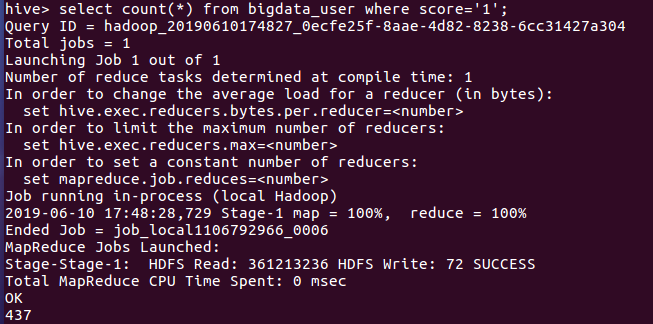
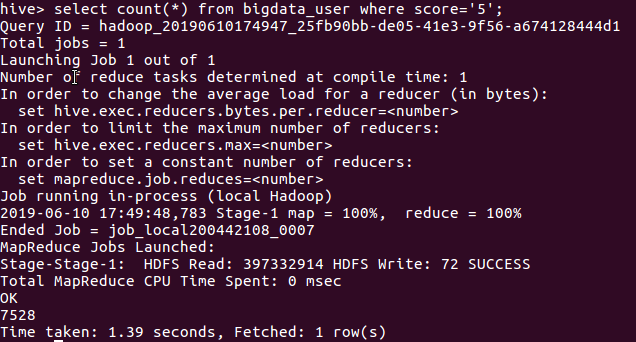
由上图可知给5分高分评价的用户人数为7528人,给1分低分评价用户人数为437人。由此可以知道这是一部优秀的电影。
- 查询评分为3的用户人数
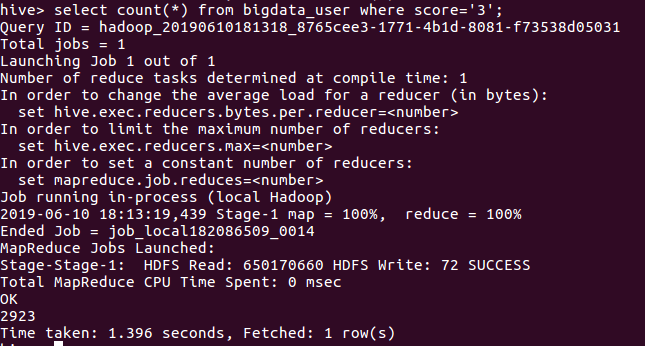
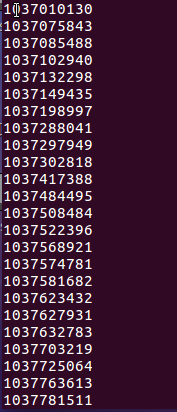
- 查询评分为1的用户id

- 查询评分为4的用户的评论

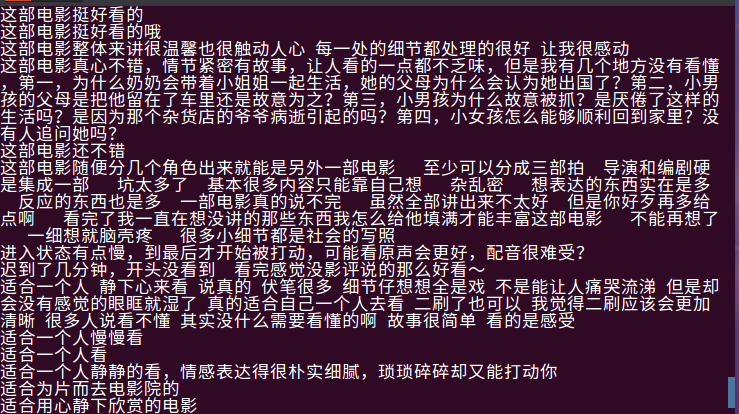
与评分为5的评论相差不多,基本都是对整个电影的好评与受到的感动。
- 查询城市葫芦岛的评论用户人数
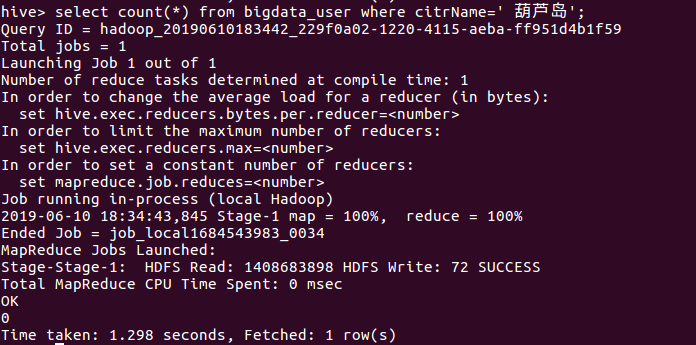
由此可看出此部电影还是比较小众,在较为不发达的城市基本无人问津。
- 查询评分为5的处于表格的序号

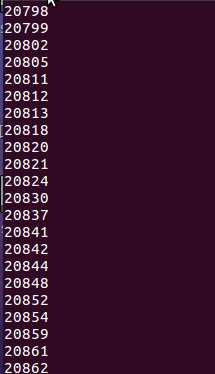
- 查询表格的数据中名字不重合的数据的数量
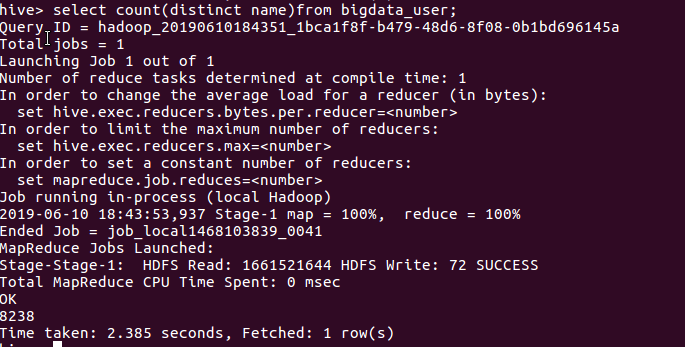
由上图可以看出由8238名用户没有重复评论数据的产生。说明爬取的数据仍然具备较大的重复性,需要注意。
- 查询表格数据中评论未重合的数据数量
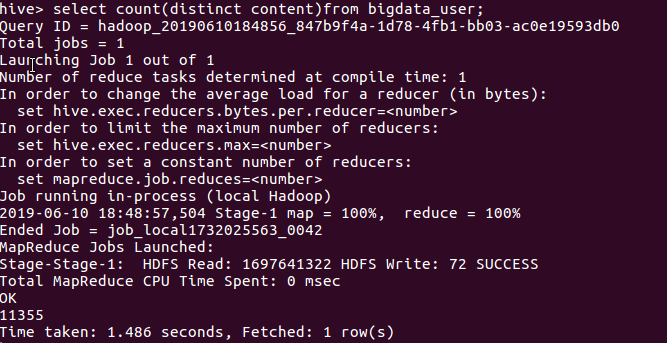
由上图可看出11355名用户评论没有重复数据的产生,基本可以视为有效数据。
总结:对于此次作业的完成,最大的问题就在于对于整个Hadoop环境的配置,就算是按部就班的按照步骤走,在这个过程中也遇到了非常多的问题,只要有一步的配置出现错误,会导致整个环境的配置失败。
但是总体来说还是基本按照要求完成了本次作业,在这个过程中我也是受益匪浅。
大数据应用期末总评——Hadoop综合大作业的更多相关文章
- 大数据应用期末总评Hadoop综合大作业
作业要求来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 1.将爬虫大作业产生的csv文件上传到HDFS 此次作业选取的 ...
- 【大数据应用期末总评】Hadoop综合大作业
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 一.Hadoop综合大作业 要求: 1.将爬虫大作业产生的csv ...
- 大数据应用期末总评(hadoop综合大作业)
作业要求源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 一.将爬虫大作业产生的csv文件上传到HDFS (1)在/usr ...
- Hadoop综合大作业
Hadoop综合大作业 要求: 用Hive对爬虫大作业产生的文本文件(或者英文词频统计下载的英文长篇小说)词频统计. 用Hive对爬虫大作业产生的csv文件进行数据分析 1. 用Hive对爬虫大作业产 ...
- 《Hadoop综合大作业》
作业要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3339 我主要的爬取内容是关于热门微博文章“996”与日剧<我要 ...
- 菜鸟学IT之Hadoop综合大作业
Hadoop综合大作业 作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 1.将爬虫大作业产生的csv文件上传到HDF ...
- Hadoop综合大作业1
本次作业来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3363 一.课程评分标准: 分数组成: 考勤 10 平时作业 30 爬 ...
- 大数据平台搭建(hadoop+spark)
大数据平台搭建(hadoop+spark) 一.基本信息 1. 服务器基本信息 主机名 ip地址 安装服务 spark-master 172.16.200.81 jdk.hadoop.spark.sc ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
随机推荐
- IDEA配置自己的注释
File-->Setting-->Live Templates,点击+,选择2.Template Group... 创建Group,我的命名为MyAnnotation,然后选中MyAnnt ...
- 【知识点整理】Oracle中NOLOGGING、APPEND、ARCHIVE和PARALLEL下,REDO、UNDO和执行速度的比较
[知识点整理]Oracle中NOLOGGING.APPEND.ARCHIVE和PARALLEL下,REDO.UNDO和执行速度的比较 1 BLOG文档结构图 2 前言部分 2.1 导读和注意事项 ...
- MySQL Replication--复制延迟01--源码瞎猜
本人完全不懂MySQL源码,以下文字纯属瞎猜,如有误导,概不负责!. 源码版本:MySQL 5.6.28 在sql/rpl_slave.cc文件中,time_diff的计算代码为: /* The ps ...
- Android开发之常用Intent.Action【转】
1.从google搜索内容 Intent intent = new Intent(); intent.setAction(Intent.ACTION_WEB_SEARCH); intent.putEx ...
- Linux命令——gdisk、fdisk、partprobe
gdisk.fdisk MBR分区表请使用fdisk分区,GPT分区表请使用gdisk分区 MBR与GPT区别参考:Linux磁盘管理——MBR 与 GPT gdisk.gdisk这两个命令参数不需要 ...
- 石子归并(区间dp 模板)
区间dp入门 #include<iostream> #include<cstdio> #include <cctype> #include<algorithm ...
- Codeforces E. Alyona and a tree(二分树上差分)
题目描述: Alyona and a tree time limit per test 2 seconds memory limit per test 256 megabytes input stan ...
- JAVA的概念理解:JavaSE、JavaEE、JavaME、jdk、jre、ide
JavaSE是Java Standard Edtion的缩写,译成中文就是Java标准版,也是Java的核心.无论是 JavaEE(Java企业版)还是JavaME(Java微型版)都是以JavaSE ...
- 【转】什么时候 i = i + 1 并不等于 i += 1?
增强型赋值语句是经常被使用到的,因为从各种学习渠道中,我们能够得知 i += 1 的效率往往要比 i = i + 1 更高一些(这里以 += 为例,实际上增强型赋值语句不仅限于此). 所以我们会乐此不 ...
- python开发总结
1.思维缜密的编程逻辑 2.满足明确的目的需求 3.运用现成的轮子加以改造 4.学会装饰自己的程序 5.化繁为简 6.多用配置文件作为入口 7.注意扩展兼容