
Beautiful Soup库入门
1.安装:pip install beautifulsoup4
Beautiful Soup库是解析、遍历、维护“标签树”的功能库
2.引用:(1)from bs4 import BeautifulSoup (2)import bs4
BeautifulSoup对应一个HTML/XML文档的全部内容
3.解析器:(1)html.parser (2)lxml pip install lxml (3)html5lib pip install html5lib
4.BeautifulSoup类的基本元素: <p class = "title">...</p>
| Tag | 标签,最基本的信息组成单元,分别用<>和</>标明开头和结尾 |
| Name | 标签的名字,<p>...</p>的名字是'P',格式:<tag>.name |
| Attributes | 标签的属性,字典形式组织,格式:<tag>.attrs |
| NavigableString | 标签内非属性字符串,<>...</>中字符串,格式:<tag>.string |
| Comment | 标签内字符串的注释部分,一种特殊的Comment类型 |
5.BeabutifulSoup类型是标签树的根节点
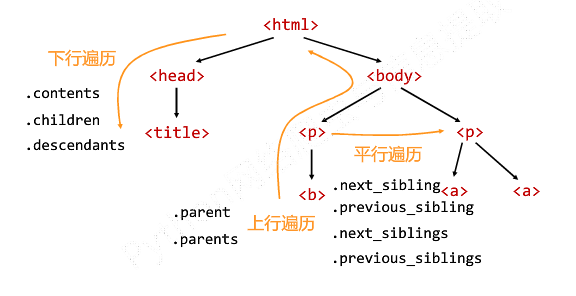
(1)标签树的下行遍历:
| .contents | 子节点的列表,将<tag>所有儿子节点存入列表 |
| .children | 子节点的迭代类型,与.contents类似,用于循环遍历儿子节点 |
| .descendants | 子孙节点的迭代类型,包含所有子孙节点,用于循环遍历 |
(2)标签树的上行遍历:
| .parent | 节点的父亲标签 |
| .parents | 节点先辈标签的迭代类型,用于循环遍历先辈节点 |
(3)标签树的平行遍历:
| .next_sibling | 返回按照HTML文本顺序的下一个平行节点标签 |
| .previous_sibling | 返回按照HTML文本顺序的上一个平行节点标签 |
| .next_siblings | 迭代类型,返回按照HTML文本顺序的后续所有平行节点标签 |
| .previous_siblings | 迭代类型,返回按照HTML文本顺序的前续所有平行节点标签 |
上行遍历需判断是否为本身(例下:)
for parent in soup.a.parents:
if parent is None:
print(parent)
else:
print(parent.name)
6.bs4库的prettify()方法:
| .prettify()为HTML文本<>及其内容增加更加'\n' | |
| .prettify()可用于标签,方法:<tag>.prettify() |
bs4库将任何HTML输入都变成utf-8编码
7.信息标记的三种形式:XML JSON YAML
信息提取的一般方法:
方法一:完整解析信息的标记形式,再提取关键信息 方法二:无视标记形式,直接搜索关键信息
融合方法:结合形式解析与搜索方法,提取关键信息
8.HTML内容查找方法:<>.find_all(name, attrs, recursive, string, **kwargs)
| name | 对标签名称的检索字符串 |
| attrs | 对标签属性值的检索字符串,可标注属性检索 |
| recursive | 是否对子孙全部检索,默认True |
| string | <>...</>中字符串区域的检索字符串 |
<tag>(...) 等价于 <tag>.find_all(..) soup(..) 等价于 soup.find_all(..)
| <>.find() | 搜索且只返回一个结果,同.find_all()参数 |
| <>.find_parents() | 在先辈节点中搜索,返回列表类型,同.find_all()参数 |
| <>.find_parent() | 在先辈节点中返回一个结果,同.find()参数 |
| <>.find_next_siblings() | 在后续平行节点中搜索,返回列表类型,同.find_all()参数 |
| <>.find_next_sibling() | 在后续平行节点中返回一个结果,同.find()参数 |
| <>.find_previous_siblings() | 在前序平行节点中搜索,返回列表类型,同.find_all()参数 |
| <>.find_previous_sibling() | 在前序平行节点中返回一个结果,同.find()参数 |
Beautiful Soup库入门的更多相关文章
- python Beautiful Soup库入门
bs4库的HTML内容遍历方法 基于bs4库的HTML格式输出 显示:友好的显示 <tag>.prettify() 编码:bs4库将任何HTML输入都变成utf-8编码(python 3. ...
- 【转载】Beautiful Soup库(bs4)入门
转载自:Beautiful Soup库(bs4)入门 该库能够解析HTML和XML 使用Beautiful Soup库: from bs4 import BeautifulSoup impo ...
- Beautiful Soup库基础用法(爬虫)
初识Beautiful Soup 官方文档:https://www.crummy.com/software/BeautifulSoup/bs4/doc/# 中文文档:https://www.crumm ...
- Python Beautiful Soup库
Beautiful Soup库 Beautiful Soup库:https://www.crummy.com/software/BeautifulSoup/ 安装Beautiful Soup: 使用B ...
- python beautiful soup库的超详细用法
原文地址https://blog.csdn.net/love666666shen/article/details/77512353 参考文章https://cuiqingcai.com/1319.ht ...
- 【Python爬虫学习笔记(3)】Beautiful Soup库相关知识点总结
1. Beautiful Soup简介 Beautiful Soup是将数据从HTML和XML文件中解析出来的一个python库,它能够提供一种符合习惯的方法去遍历搜索和修改解析树,这将大大减 ...
- python之Beautiful Soup库
1.简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据.官方解释如下: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索 ...
- Beautiful Soup库介绍
开始前需安装Beautiful Soup 和lxml. Beautiful Soup在解析时依赖解析器,下表列出bs4支持的解析器. 解析器 使用方法 Python标准库 BeautifulSoup( ...
- Beautiful Soup库
原文传送门:静觅 » Python爬虫利器二之Beautiful Soup的用法
随机推荐
- 每隔15s异步刷新手机页面
前台异步js发请求代码: <script type="text/javascript"> var lightArr; var lightHistoryArr; /* 每 ...
- GPU的主要工作:图像合成、图形操作、光线表达
GPU的主要工作:图像合成.图形操作 gpu不产生图片, 只表达和处理图片.图形:
- UI系统的作用
1.向用户展示信息: 2.将用于与系统的交互解释为指令.
- match 和 search 和 indexOf 查找及 正则表达式的 exec 和 test 用法
function test(){ var name= "1.087"; var abc = "abd wor66k ne78xt"; var reg = /\d ...
- SQL基础-存储过程&触发器
一.存储过程 1.存储过程简介 存储过程: 一组为了完成特定功能的SQL语句集,经编译后存储在数据库中,然后通过指定存储过程的名字并给定参数(如果该存储过程带有参数)来调用执行它. 存储过程的创建: ...
- 【BigData】Java基础_数组
什么是数组?数据是可以装一组数据的变量 1.定义数组 float[] arr1 = new float[10]; // 可以装10个float数据 int[] arr2 = new int[10]; ...
- Cookie 的 SameSite 属性
转自http://www.ruanyifeng.com/blog/2019/09/cookie-samesite.html Chrome 51 开始,浏览器的 Cookie 新增加了一个SameSit ...
- 一大波 Facebook Libra 技术文章来袭
由于 Libra 具有真正的稳定的可编程货币的特性, Libra 或许可以带来又一波平台红利. 上周我们(深入浅出区块链技术社区)发起了 Libra 技术文档的翻译计划,到这周文档已经翻译了一半.欢迎 ...
- 分布式系统 与 Google
google 论文 http://duanple.com/?p=170 google 论文与开源 http://duanple.com/?p=1096 分布式系统论文集 https://github. ...
- 分析WordPress数据表之评论表(功能篇)
数据表分析 wp_comments(评论表) 该表字段,如下:comment_ID(评论ID)comment_post_ID(评论文章ID)comment_author(评论者用户名)comment_ ...