
十三 web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址
有多网站,当你浏览器访问时看到的信息,在html源文件里却找不到,由得信息还是滚动条滚动到对应的位置后才显示信息,那么这种一般都是 js 的 Ajax 动态请求生成的信息
我们以百度新闻为列:
1、分析网站
首先我们浏览器打开百度新闻,在网页中间部分找一条新闻信息

然后查看源码,看看在源码里是否有这条新闻,可以看到源文件里没有这条信息,这种情况爬虫是无法爬取到信息的
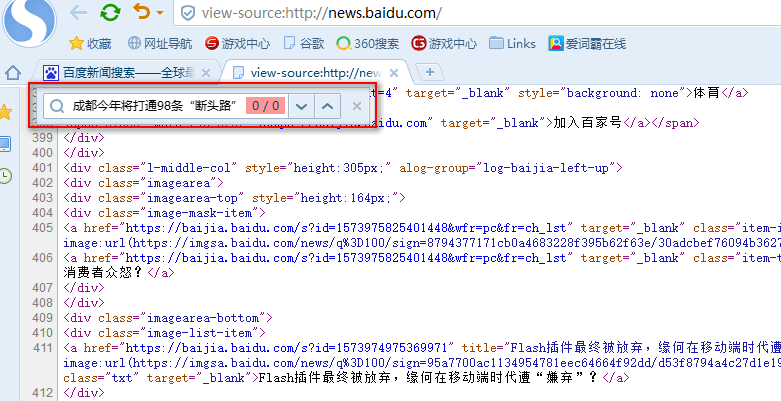
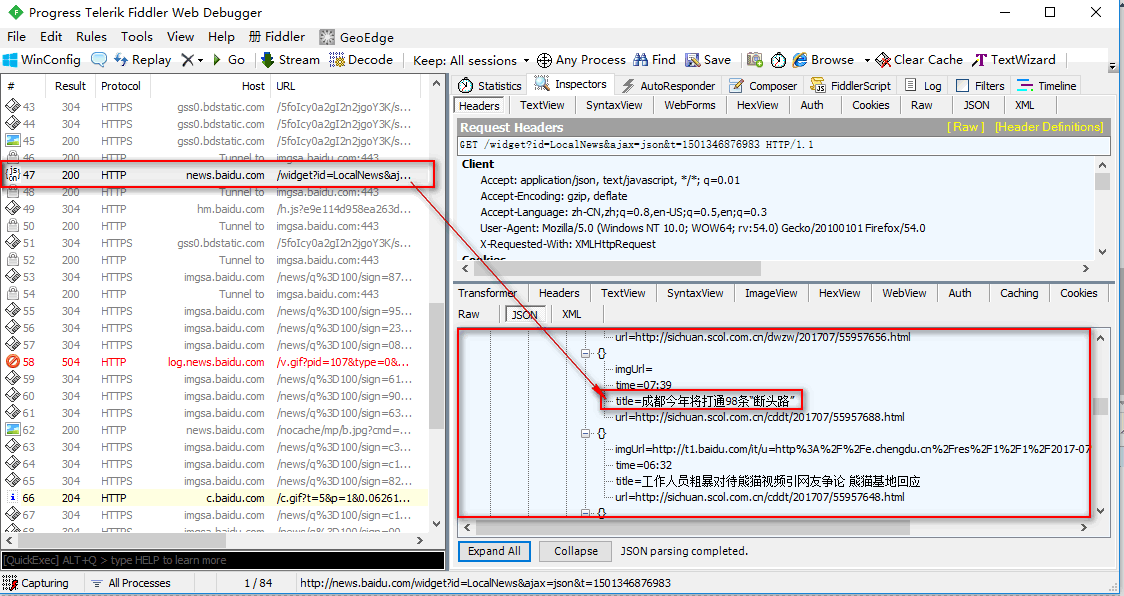
那么我们就需要抓包分析了,启动抓包软件和抓包浏览器,前后有说过软件了,就不在说了,此时我们经过抓包看到这条信息是通过Ajax动态生成的JSON数据,也就是说,当html页面加载完成后才生成的,所有我们在源文件里无法找到,当然爬虫也找不到
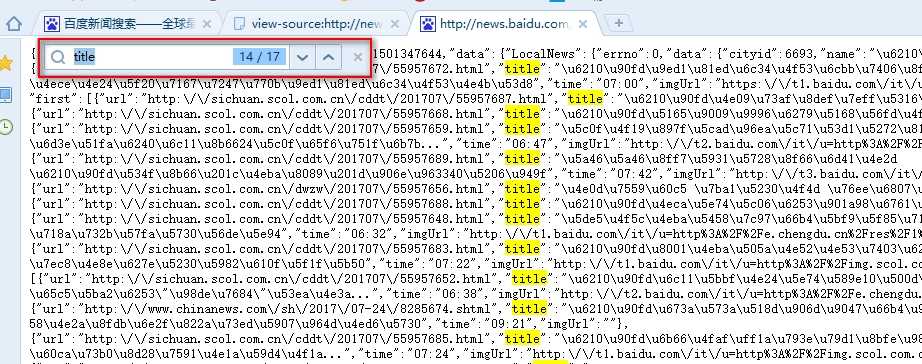
我们首先将这个JSON数据网址拿出来,到浏览器看看,我们需要的数据是不是全部在里面,此时我们看到这次请求里只有 17条信息,显然我们需要的信息不是完全在里面,还得继续看看其他js包
我们将抓包浏览器滚动条拉到底,以便触发所有js请求,然后在继续找js包,我们将所有js包都找完了再也没看到新闻信息的包了
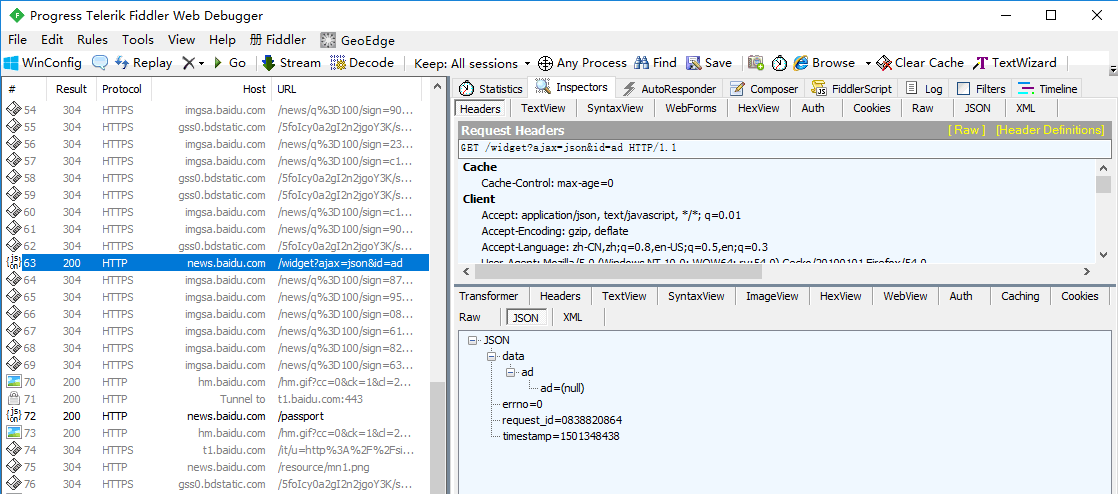
那信息就不在js包里了,我们回头在看看其他类型的请求,此时我们看到很多get请求响应的是我们需要的新闻信息,说明只有第一次那个Ajax请求返回的JSON数据,后面的Ajax请求返回的都是html类型的字符串数据,
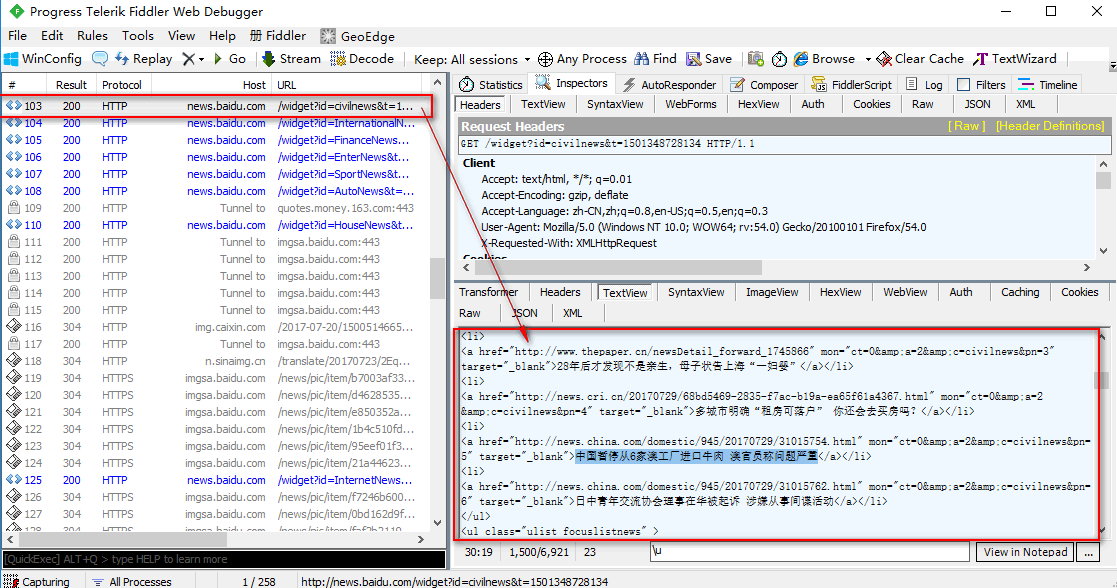
我们将Ajax请求返回的JSON数据的网址和Ajax请求返回html类型的字符串数据网址,拿来做一下比较看看是否能找到一定规律,
此时我们可以看到,JSON数据的网址和html类型的字符串数据网址是一个请求地址,
只是请求时传递的参数不一样而已,那么说明无论返回的什么类型的数据,都是在一个请求地址处理的,只是根据不同的传参返回不同类型的数据而已
http://news.baidu.com/widget?id=LocalNews&ajax=json&t=1501348444467   JSON数据的网址

http://news.baidu.com/widget?id=civilnews&t=1501348728134        html类型的字符串数据网址

http://news.baidu.com/widget?id=InternationalNews&t=1501348728196    html类型的字符串数据网址
我们可以将html类型的字符串数据网址加上JSON数据的网址参数,那是否会返回JSON数据类型?试一试,果然成功了
http://news.baidu.com/widget?id=civilnews&ajax=json        将html类型的字符串数据网址加上JSON数据的网址参数

http://news.baidu.com/widget?id=InternationalNews&ajax=json    将html类型的字符串数据网址加上JSON数据的网址参数
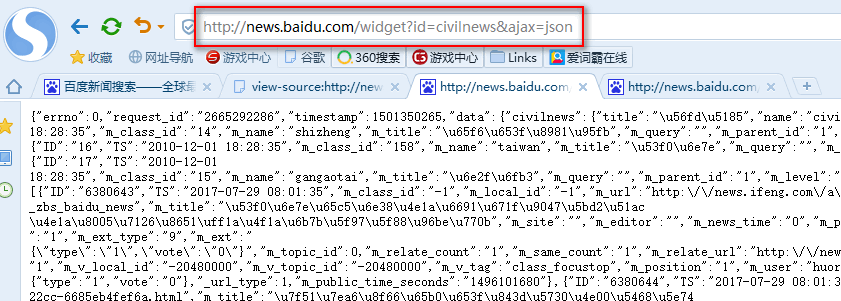
这下就好办了,找到所有的html类型的字符串数据网址,按照上面的方法将其转换成JSON数据的网址,然后循环的去访问转换后的JSON数据的网址,就可以拿到所有新闻的url地址了
crapy实现

# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request,FormRequest

import re

import json

from adc.items import AdcItem

from scrapy.selector import Selector

class PachSpider(scrapy.Spider):                            #定义爬虫类,必须继承scrapy.Spider

    name = 'pach'                                           #设置爬虫名称

    allowed_domains = ['news.baidu.com']                    #爬取域名

    start_urls = ['http://news.baidu.com/widget?id=civilnews&ajax=json']

    qishiurl = [                    #的到所有页面id

        'InternationalNews',

        'FinanceNews',

        'EnterNews',

        'SportNews',

        'AutoNews',

        'HouseNews',

        'InternetNews',

        'InternetPlusNews',

        'TechNews',

        'EduNews',

        'GameNews',

        'DiscoveryNews',

        'HealthNews',

        'LadyNews',

        'SocialNews',

        'MilitaryNews',

        'PicWall'

    ]

    urllieb = []

    for i in range(0,len(qishiurl)):            #构造出所有idURL

        kaishi_url = 'http://news.baidu.com/widget?id=' + qishiurl[i] + '&ajax=json'

        urllieb.append(kaishi_url)

    # print(urllieb)

    def parse(self, response):                  #选项所有连接

        for j in range(0, len(self.urllieb)):

            a = '正在处理第%s个栏目:url地址是:%s' % (j, self.urllieb[j])

            yield scrapy.Request(url=self.urllieb[j], callback=self.enxt)     #每次循环到的url 添加爬虫

    def enxt(self, response):

        neir = response.body.decode("utf-8")

        pat2 = '"m_url":"(.*?)"'

        url = re.compile(pat2, re.S).findall(neir)      #通过正则获取爬取页面 的URL

        for k in range(0,len(url)):

            zf_url = url[k]

            url_zf = re.sub("\\\/", "/", zf_url)

            pduan = url_zf.find('http://')

            if pduan == 0:

                print(url_zf)                       #输出获取到的所有url
十三 web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息的更多相关文章
- 第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息 crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多 ...
- 第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码
第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码 打码接口文件 # -*- coding: cp936 -*- import sys import os ...
- 第三百三十三节,web爬虫讲解2—Scrapy框架爬虫—Scrapy模拟浏览器登录—获取Scrapy框架Cookies
第三百三十三节,web爬虫讲解2—Scrapy框架爬虫—Scrapy模拟浏览器登录 模拟浏览器登录 start_requests()方法,可以返回一个请求给爬虫的起始网站,这个返回的请求相当于star ...
- 第三百三十二节,web爬虫讲解2—Scrapy框架爬虫—Scrapy使用
第三百三十二节,web爬虫讲解2—Scrapy框架爬虫—Scrapy使用 xpath表达式 //x 表示向下查找n层指定标签,如://div 表示查找所有div标签 /x 表示向下查找一层指定的标签 ...
- 第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令
第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令 Scrapy框架安装 1.首先,终端执行命令升级pip: python -m pip install --u ...
- 十 web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令
Scrapy框架安装 1.首先,终端执行命令升级pip: python -m pip install --upgrade pip2.安装,wheel(建议网络安装) pip install wheel ...
- python爬虫随笔-scrapy框架(1)——scrapy框架的安装和结构介绍
scrapy框架简介 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
- Scrapy框架-----爬虫
说明:文章是本人读了崔庆才的Python3---网络爬虫开发实战,做的简单整理,希望能帮助正在学习的小伙伴~~ 1. 准备工作: 安装Scrapy框架.MongoDB和PyMongo库,如果没有安装, ...
- 第三百三十节,web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解
第三百三十节,web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解 封装模块 #!/usr/bin/env python # -*- coding: utf- ...
随机推荐
- cl查看类的内存布局
查看单个类的内存布局 Microsoft Visual Studio编译器cl的编译选项可以查看源文件中某个C++类的内存布局,对于想了解某个对象的内存布局的人来说十分直观和方便. • 命令格式 ...
- Java内存解析 程序的执行过程
Java内存解析 栈.堆.常量池等虽同属Java内存分配时操作的区域,但其适用范围和功用却大不相同.本文将深入Java核心,简单讲解Java内存分配方面的知识. 首先我们先来讲解一下内存中的各个区域. ...
- 下一个亿万市场:企业级SaaS服务谁能独领风骚
注:SaaS是Software-as-a-Service(软件即服务)的简称,一种完全创新的软件应用模式,简单来说SaaS即为提供商基于互联网为企业提供软件服务. 对中小型企业来说:SaaS是采用先 ...
- BZOJ 2599: [IOI2011]Race
点分治,定权值,求另一关键字最小 不满足前缀加减性 可以按序遍历,用一数组$t[] 来维护路径为i的最小边数$ 再对于一个直系儿子对应的子树,先算距离求答案再更新$t数组,这样就不会重复$ #incl ...
- yarn 与 resource manager ha
YARN最初的思想是把hadoop1中的job tracker的功能拆分出来,把它的资源管理与任务调度功能分成两个单独的进程.yarn体系结构中有两个进程,resource manager和nodem ...
- 【android】开发笔记系列UI篇
弹出View添加阴影效果 系统自带就有,在android studio上直接写入背景颜色 android:background="@android:drawable/dialog_holo_ ...
- googleBigTable
Bigtable是一个分布式的结构化数据存储系统,它被设计用来处理海量数据:通常是分布在数千台普通服务器上的PB级的数据.Google的很多项目使用Bigtable存储数据,包括Web索引.Googl ...
- Python 实例2—购物车
老男孩教学学习笔记 """启动程序后,让用户输入工资,然后打印商品列表允许用户根据商品编号购买商品用户选择商品后,检测余额是否够,够就直接扣款,不够就提醒可随机退出,退出 ...
- C++通过HTTP请求Get或Post方式请求Json数据(转)
原文网址:https://www.cnblogs.com/shike8080/articles/6549339.html #pragma once#include <iostream>#i ...
- [入坑系列] Mybatis 中$与#的区别
1.理解 1 #是将传入的值当做字符串的形式,eg:select id,name,age from student where id =#{id},当前端把id值1,传入到后台的时候,就相当于 sel ...