
第八次作业:聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用
import numpy as np

x = np.random.randint(1,100,[20,1])

y = np.zeros(20)

k = 3

def initcenter(x,k):

    return x[:k]

kc = initcenter(x,k)

kc

def nearest(kc,i):

    d=(abs(kc-i))

    w=np.where(d==np.min(d))

    return w[0][0]

kc = initcenter(x,k)

nearest(kc,56)

def xclassify(x,y,kc):

    for i in range(x.shape[0]):

        y[i] = nearest(kc,x[i])

    return y

kc = initcenter(x,k)

y = xclassify(x,y,kc)

print(kc,y)

def kcmean(x,y,kc,k):

    l = list(kc)

    flag = False

    for c in range(k):

        m = np.where(y == c)

        n = np.mean(x[m])

        if l[c] != n:

            l[c] = n

            flag = True

            print(l,flag)

    return (np.array(l),flag)

kc = initcenter(x,k)

flag = True

k = 3

while flag:

    y = xclassify(x,y,kc)

    kc,flag = kcmean(x,y,kc,k)
运行结果

二.鸢尾花花瓣长度数据做聚类并用散点图显示
import numpy as np

from sklearn.datasets import load_iris

iris = load_iris()

x = iris.data[:,1]

y = np.zeros(150)

def initcenter(x,k):    #初始聚类中心数组

    return x[0:k].reshape(k)

def nearest(kc,i):       #数组中的值,与聚类中心最小距离所在类别的索引号

    d = (abs(kc-i))

    w = np.where(d == np.min(d))

    return w[0][0]

def xclassify(x,y,kc):

    for i in range(x.shape[0]):       #对数组的每个值进行分类,shape[0]读取矩阵第一维度的长度

        y[i] = nearest(kc,x[i])

    return y

def kcmean(x,y,kc,k):     #计算各聚类新均值

    l = list(kc)

    flag = False

    for c in range(k):

        print(c)

        m = np.where(y == c)

        n=np.mean(x[m])

        if l[c] != n:

            l[c] = n

            flag = True     #聚类中心发生变化

            print(l,flag)

    return (np.array(l),flag)

k = 3

kc = initcenter(x,k)

flag = True

print(x,y,kc,flag)

#判断聚类中心和目标函数的值是否发生改变,若不变,则输出结果,若改变,则返回2

while flag:

    y = xclassify(x,y,kc)

    kc, flag = kcmean(x,y,kc,k)

    print(y,kc,type(kc))

print(x,y)

import matplotlib.pyplot as plt

plt.scatter(x,x,c=y,s=50,cmap="rainbow");

plt.show()
运行结果
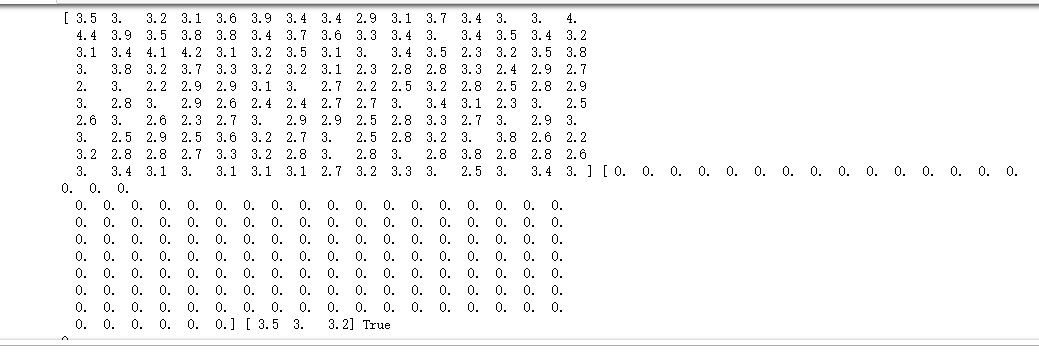
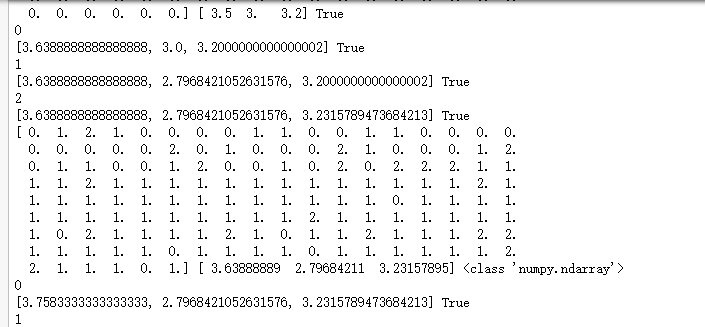
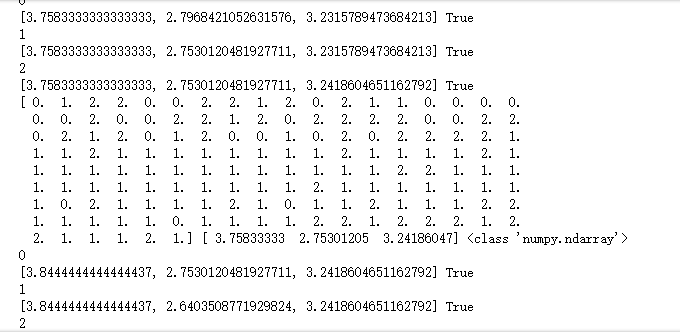

第八次作业:聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用的更多相关文章
- 聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用
1.用python实现K均值算法 import numpy as np x = np.random.randint(1,100,20)#产生的20个一到一百的随机整数 y = np.zeros(20) ...
- 聚类--K均值算法
import numpy as np from sklearn.datasets import load_iris iris = load_iris() x = iris.data[:,1] y = ...
- K 均值算法-如何让数据自动分组
公号:码农充电站pro 主页:https://codeshellme.github.io 之前介绍到的一些机器学习算法都是监督学习算法.所谓监督学习,就是既有特征数据,又有目标数据. 而本篇文章要介绍 ...
- 聚类算法:K-means 算法(k均值算法)
k-means算法: 第一步:选$K$个初始聚类中心,$z_1(1),z_2(1),\cdots,z_k(1)$,其中括号内的序号为寻找聚类中心的迭代运算的次序号. 聚类中心的向量值可任意设 ...
- 机器学习之K均值算法(K-means)聚类
K均值算法(K-means)聚类 [关键词]K个种子,均值 一.K-means算法原理 聚类的概念:一种无监督的学习,事先不知道类别,自动将相似的对象归到同一个簇中. K-Means算法是一种聚类分析 ...
- 一句话总结K均值算法
一句话总结K均值算法 核心:把样本分配到离它最近的类中心所属的类,类中心由属于这个类的所有样本确定. k均值算法是一种无监督的聚类算法.算法将每个样本分配到离它最近的那个类中心所代表的类,而类中心的确 ...
- 【机器学习】K均值算法(I)
K均值算法是一类非监督学习类,其可以通过观察样本的离散性来对样本进行分类. 例如,在对如下图所示的样本中进行聚类,则执行如下步骤 1:随机选取3个点作为聚类中心. 2:簇分配:遍历所有样本然后依据每个 ...
- Bisecting KMeans (二分K均值)算法讲解及实现
算法原理 由于传统的KMeans算法的聚类结果易受到初始聚类中心点选择的影响,因此在传统的KMeans算法的基础上进行算法改进,对初始中心点选取比较严格,各中心点的距离较远,这就避免了初始聚类中心会选 ...
- KMeans (K均值)算法讲解及实现
算法原理 KMeans算法是典型的基于距离的聚类算法,采用距离作为相似性的评价指标,即认为两个对象的距离越近,其相似度就越大.该算法认为簇是由距离靠近的对象组成的,因此把得到紧凑且独立的簇作为最终目标 ...
随机推荐
- Redis 错误:Failed with result 'start-limit-hit'
Redis 错误:Failed with result 'start-limit-hit' 背景 Redis 版本为 5.0.4: 文件 /etc/systemd/system/redis.servi ...
- SQLServer 2008 R2查看字段约束
SQLServer 2008 R2 删除字段前检查字段的约束: select a.name,b.name as cname from syscolumns a left join sysobjects ...
- wireshark基础学习—第二部分wireshark的基础操作
抓取报文: 下载和安装好Wireshark之后,启动Wireshark并且在接口列表中选择接口名,然后开始在此接口上抓包.例如,如果想要在无线网络上抓取流量,点击无线接口.点击Capture Opti ...
- 20165306 Exp4 恶意代码分析
Exp4 恶意代码分析 一.实践概述 1.实践目标 1.1是监控你自己系统的运行状态,看有没有可疑的程序在运行. 1.2是分析一个恶意软件,就分析Exp2或Exp3中生成后门软件:分析工具尽量使用原生 ...
- 必会SQL练习题
()表名:购物信息 购物人 商品名称 数量 A 甲 B 乙 C 丙 A 丁 B 丙 …… 给出所有购入商品为两种或两种以上的购物人记录 答:); ()表名:成绩表 姓名 课程 分数 张三 语文 张三 ...
- 七牛云图片的存储与处理--基于node
1. 手动上传 . 快速入门,这个简单,可以参考七牛官方文档: https://developer.qiniu.com/kodo/manual/1233/console-quickstart#step ...
- 记一次IIS发布网站导致系统时常跳入登录页面的问题解决
服务器:winserver2012R2 iis 发布网站后,正常浏览网页,时常跳到登录页面,第一反应session过期,因为登录信息都存在session,但session 都是默认配置过期时间为20分 ...
- 数据结构|-用C#实现一个简单的链表
我们知道C#中是没有链表的,我们可以自己实现一个 整个单链表能实现的功能有: 功能 方法 返回值 备注 获取链表长度 GetLength() int 返回值是链表长度 清空链表 Clear() voi ...
- centos7 基础命令
一: linux基础 (1) 查看服务器的IP信息 ip add showifconfig (2) 操作网卡命令(重启网络和启用网卡) systemctl restart networksystemc ...
- IDEA 介绍
转载:https://blog.csdn.net/kanchaishaonian/article/details/81107210 前言:IntelliJ IDEA 如果说IntelliJ IDEA是 ...