
【SparkStreaming学习之一】 SparkStreaming初识
环境
虚拟机:VMware 10
Linux版本:CentOS-6.5-x86_64
客户端:Xshell4
FTP:Xftp4
jdk1.8
scala-2.10.4(依赖jdk1.8)
spark-1.6
一、SparkStreaming简介
SparkStreaming是流式处理框架,是Spark API的扩展,支持可扩展、高吞吐量、容错的实时数据流处理,实时数据的来源可以是:Kafka, Flume, Twitter, ZeroMQ或者TCP sockets,并且可以使用高级功能的复杂算子来处理流数据。例如:map,reduce,join,window 。最终,处理后的数据可以存放在文件系统,数据库等,方便实时展现。
二、SparkStreaming与Storm的区别
1、Storm是纯实时的流式处理框架(扶梯),SparkStreaming是准实时的处理框架(微批处理-电梯)。因为微批处理,SparkStreaming的吞吐量比Storm要高。
2、Storm 的事务机制要比SparkStreaming的要完善。
3、Storm支持动态资源调度。(spark1.2开始和之后也支持)
4、SparkStreaming擅长复杂的业务处理,Storm不擅长复杂的业务处理,擅长简单的汇总型计算。
整体而言速度比storm要快,目前新项目一般选择SparkStreaming多一些,具体选择还要看应用场景
三、SparkStreaming初始
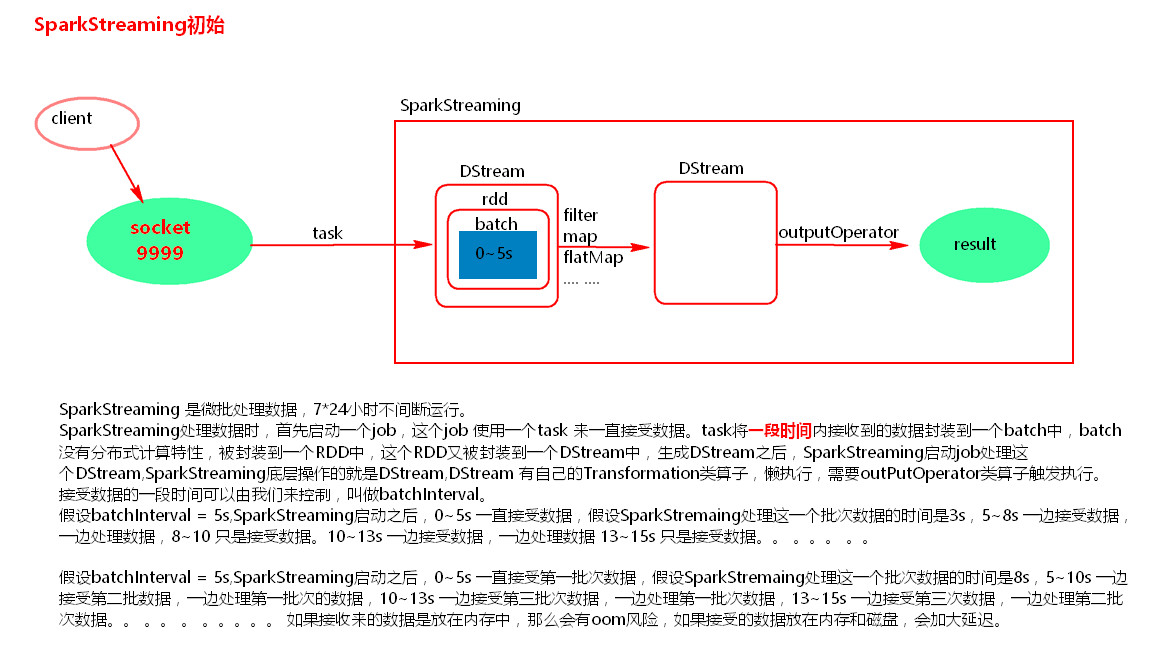
SparkStreaming示例代码:
package com.wjy.ss;

import java.util.Arrays;

import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.FlatMapFunction;

import org.apache.spark.api.java.function.Function2;

import org.apache.spark.api.java.function.PairFunction;

import org.apache.spark.streaming.Durations;

import org.apache.spark.streaming.api.java.JavaDStream;

import org.apache.spark.streaming.api.java.JavaPairDStream;

import org.apache.spark.streaming.api.java.JavaReceiverInputDStream;

import org.apache.spark.streaming.api.java.JavaStreamingContext;

import scala.Tuple2;

public class SparkStreamingTest {

    public static void main(String[] args) {

        SparkConf conf = new SparkConf().setMaster("local[2]").setAppName("SparkStreamingTest");

        JavaSparkContext sc = new JavaSparkContext(conf);

        sc.setLogLevel("WARN");//设置日志级别  不打印一堆无用的日志

        //创建JavaStreamingContext  批次间隔为5秒

        JavaStreamingContext jsc = new JavaStreamingContext(sc,Durations.seconds(5));

        //监听134.32.123.101 9999端口 获取文本socket流

        JavaReceiverInputDStream<String> socketTextStream = jsc.socketTextStream("134.32.123.101", 9999);

        //接下来进行wordcount

        JavaDStream<String> words = socketTextStream.flatMap(new FlatMapFunction<String, String>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Iterable<String> call(String line) throws Exception {

                return Arrays.asList(line.split(" "));

            }

        });

        JavaPairDStream<String, Integer> pairWords = words.mapToPair(new PairFunction<String, String, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Tuple2<String, Integer> call(String word) throws Exception {

                return new Tuple2<String, Integer>(word,1);

            }

        });

        JavaPairDStream<String, Integer> reduceByKey = pairWords.reduceByKey(new Function2<Integer, Integer, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Integer call(Integer v1, Integer v2) throws Exception {

                return v1+v2;

            }

        });

        //print()可以加参数  默认打印在此 DStream 中生成的每个 RDD 的前十个元素。加参数print(num)前num个元素

        reduceByKey.print();

        /*

         * -------------------------------------------

           Time: 1555921465000 ms

           -------------------------------------------

           19/04/22 17:01:38 WARN BlockManager: Block input-0-1555923698400 replicated to only 0 peer(s) instead of 1 peers

           19/04/22 17:01:38 WARN BlockManager: Block input-0-1555923698600 replicated to only 0 peer(s) instead of 1 peers

           -------------------------------------------

           Time: 1555921470000 ms

           -------------------------------------------

           (ee,1)

           (aa,1)

           (gg,1)

           (dd,1)

           (hh,1)

           (wjy,1)

           (kk,1)

           (jj,1)

           (ii,1)

           (hello,14)

           ...

           -------------------------------------------

           Time: 1555921475000 ms

           -------------------------------------------

           (ll,1)

           (hello,1)

         */

        //启动

        jsc.start();

        //监控:等待中断

        jsc.awaitTermination();

        //这里stop不会执行  我们在实际应用中根据触发条件执行 比如监控某个文件删除后就执行停止动作

        jsc.stop();

    }

}
以上使用print用来展示查看JavaPairDStream中数据,这是本机测试,实际应用是不会使用print的,这里需要我们通过foreachRDD来进行下一步的逻辑处理和触发:
package com.wjy.ss;

import java.util.Arrays;

import org.apache.spark.SparkConf;

import org.apache.spark.SparkContext;

import org.apache.spark.api.java.JavaPairRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.FlatMapFunction;

import org.apache.spark.api.java.function.Function2;

import org.apache.spark.api.java.function.PairFunction;

import org.apache.spark.api.java.function.VoidFunction;

import org.apache.spark.broadcast.Broadcast;

import org.apache.spark.streaming.Durations;

import org.apache.spark.streaming.api.java.JavaDStream;

import org.apache.spark.streaming.api.java.JavaPairDStream;

import org.apache.spark.streaming.api.java.JavaReceiverInputDStream;

import org.apache.spark.streaming.api.java.JavaStreamingContext;

import scala.Tuple2;

public class SparkStreamingTest {

    public static void main(String[] args) {

        SparkConf conf = new SparkConf().setMaster("local[2]").setAppName("SparkStreamingTest");

        JavaSparkContext sc = new JavaSparkContext(conf);

        sc.setLogLevel("WARN");//设置日志级别  不打印一堆无用的日志

        //创建JavaStreamingContext  批次间隔为5秒

        JavaStreamingContext jsc = new JavaStreamingContext(sc,Durations.seconds(5));

        //监听134.32.123.101 9999端口 获取文本socket流

        JavaReceiverInputDStream<String> socketTextStream = jsc.socketTextStream("134.32.123.101", 9999);

        //接下来进行wordcount

        JavaDStream<String> words = socketTextStream.flatMap(new FlatMapFunction<String, String>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Iterable<String> call(String line) throws Exception {

                return Arrays.asList(line.split(" "));

            }

        });

        JavaPairDStream<String, Integer> pairWords = words.mapToPair(new PairFunction<String, String, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Tuple2<String, Integer> call(String word) throws Exception {

                return new Tuple2<String, Integer>(word,1);

            }

        });

        JavaPairDStream<String, Integer> reduceByKey = pairWords.reduceByKey(new Function2<Integer, Integer, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Integer call(Integer v1, Integer v2) throws Exception {

                return v1+v2;

            }

        });

        //print()默认打印在此 DStream 中生成的每个RDD 的前十个元素。加参数前num个元素

        //reduceByKey.print();

        /**

         * foreachRDD 可以拿到DStream中的RDD ,对拿到的RDD可以使用RDD的transformation类算子转换,要对拿到的RDD使用action算子触发执行,否则,foreachRDD不会执行。

         *  foreachRDD 中call方法内,拿到的RDD的算子外,代码是在Driver端执行。可以使用这个算子实现动态改变广播变量。

         *

         */

        reduceByKey.foreachRDD(new VoidFunction<JavaPairRDD<String,Integer>>() {

            private static final long serialVersionUID = 1L;

            @Override

            public void call(JavaPairRDD<String, Integer> rdd)

                    throws Exception

            {

                //Driver端执行

                System.out.println("Driver .......");

                //获取SparkContext

                SparkContext context = rdd.context();

                //创建JavaSparkContext

                JavaSparkContext javaSparkContext = new JavaSparkContext(context);

                //广播变量  这里可以读取一个文件 文件内容可变  就达到了动态改变广播变量的目的

                Broadcast<String> broadcast = javaSparkContext.broadcast("hello wjy");

                String value = broadcast.value();

                System.out.println(value);

                JavaPairRDD<String, Integer> mapToPair = rdd.mapToPair(new PairFunction<Tuple2<String,Integer>, String,Integer>() {

                    private static final long serialVersionUID = 1L;

                    @Override

                    public Tuple2<String, Integer> call(Tuple2<String, Integer> tuple) throws Exception {

                        System.out.println("Executor .......");

                        return new Tuple2<String, Integer>(tuple._1+"~",tuple._2);

                    }

                });

                mapToPair.foreach(new VoidFunction<Tuple2<String,Integer>>() {

                    private static final long serialVersionUID = 1L;

                    @Override

                    public void call(Tuple2<String, Integer> arg0)

                            throws Exception {

                        System.out.println(arg0);

                    }

                });

            }

        });

/*

*

* 执行结果:

Driver .......

hello wjy

Driver .......

hello wjy

19/04/22 17:26:46 WARN BlockManager: Block input-0-1555925206600 replicated to only 0 peer(s) instead of 1 peers

19/04/22 17:26:47 WARN BlockManager: Block input-0-1555925206800 replicated to only 0 peer(s) instead of 1 peers

19/04/22 17:26:47 WARN BlockManager: Block input-0-1555925207200 replicated to only 0 peer(s) instead of 1 peers

Driver .......

hello wjy

Executor .......

(ee~,1)

Executor .......

(aa~,1)

Executor .......

(ll~,1)

Executor .......

(gg~,1)

Executor .......

(dd~,1)

Executor .......

(hh~,1)

Executor .......

(wjy~,1)

Executor .......

(kk~,1)

Executor .......

(jj~,1)

Executor .......

(ii~,1)

Executor .......

(hello~,31)

Executor .......

(tt~,1)

Executor .......

(ff~,1)

Executor .......

(bb~,1)

Executor .......

(world~,17)

Executor .......

(cc~,1)

Driver .......

hello wjy

*/

        //启动

        jsc.start();

        //监控:等待中断

        jsc.awaitTermination();

        //这里stop不会执行  我们在实际应用中根据触发条件执行 比如监控某个文件删除后就执行停止动作

        jsc.stop();

    }

}
代码注意事项:
(2.1)启动socket server 服务器:nc –lk 9999
[root@PCS101 ~]# nc -lk

hello world

hello wjy

hello tt

hello aa

hello bb

hello cc

hello dd

hello ee

hello ff

hello gg

hello hh

hello ii

hello jj

hello kk

hello ll
Linux中nc命令是一个功能强大的网络工具,全称是netcat。
语法:nc
-l 开启 监听模式,用于指定nc将处于监听模式。通常 这样代表着为一个 服务等待客户端来链接指定的端口。
-p<通信端口> 设置本地主机使用的通信端口。有可能会关闭
-k<通信端口>强制 nc 待命链接.当客户端从服务端断开连接后,过一段时间服务端也会停止监听。 但通过选项 -k 我们可以强制服务器保持连接并继续监听端口。
(2.2)receiver模式下接受数据,local的模拟线程必须大于等于2,一个线程用来receiver用来接受数据,另一个线程用来执行job。
(2.3)Durations时间设置就是我们能接收的延迟度。这个需要根据集群的资源情况以及任务的执行情况来调节。
(2.4)创建JavaStreamingContext有两种方式(SparkConf,SparkContext)
所有的代码逻辑完成后要有一个output operation类算子。
JavaStreamingContext.start() Streaming框架启动后不能再次添加业务逻辑。
JavaStreamingContext.stop() 无参的stop方法将SparkContext一同关闭,stop(false),不会关闭SparkContext。
JavaStreamingContext.stop()停止之后不能再调用start。
四、Driver HA(Standalone或者Mesos)
因为SparkStreaming是7*24小时运行,Driver只是一个简单的进程,有可能挂掉,所以实现Driver的HA就有必要(如果使用的Client模式就无法实现Driver HA ,这里针对的是cluster模式)。Yarn平台cluster模式提交任务,AM(AplicationMaster)相当于Driver,如果挂掉会自动启动AM。这里所说的DriverHA针对的是Spark standalone和Mesos资源调度的情况下。实现Driver的高可用有两个步骤:
第一:提交任务层面,在提交任务的时候加上选项 --supervise,当Driver挂掉的时候会自动重启Driver。
第二:代码层面,使用JavaStreamingContext.getOrCreate(checkpoint路径,JavaStreamingContextFactory)
Driver中元数据包括:
(1)创建应用程序的配置信息。
(2)DStream的操作逻辑。
(3)job中没有完成的批次数据,也就是job的执行进度。
package com.wjy.ss;

import java.util.Arrays;

import org.apache.spark.SparkConf;

import org.apache.spark.api.java.function.FlatMapFunction;

import org.apache.spark.api.java.function.Function2;

import org.apache.spark.api.java.function.PairFunction;

import org.apache.spark.streaming.Durations;

import org.apache.spark.streaming.api.java.JavaDStream;

import org.apache.spark.streaming.api.java.JavaPairDStream;

import org.apache.spark.streaming.api.java.JavaStreamingContext;

import org.apache.spark.streaming.api.java.JavaStreamingContextFactory;

import scala.Tuple2;

/**

*

*  Spark standalone or Mesos with cluster deploy mode only:

*  在提交application的时候  添加 --supervise 选项  如果Driver挂掉 会自动启动一个Driver

*

*/

public class SparkStreamingOnHDFS {

    public static void main(String[] args) {

        SparkConf conf = new SparkConf().setMaster("local").setAppName("SparkStreamingOnHDFS");

        //checkpoint目录可以设置为HDFS目录 也可以是本地目录

        //final String checkpointDirectory = "hdfs://node1:9000/spark/SparkStreaming/CheckPoint2019";

        final String checkpointDirectory = "./checkpoint";

        //JavaStreamingContext工厂类  需要重写create方法

        JavaStreamingContextFactory jscfactory = new JavaStreamingContextFactory(){

            /**

             * 只有首次创建JavaStreamingContext 才会走这里

             */

            @Override

            public JavaStreamingContext create() {

                System.out.println("Creating new context");

                JavaStreamingContext jsc = new JavaStreamingContext(conf,Durations.seconds(5));

                jsc.sparkContext().setLogLevel("WARN");

                /**

                 *  checkpoint 保存:

                 *        1.配置信息

                 *        2.DStream操作逻辑

                 *        3.job的执行进度

                 *      4.offset

                 */

                jsc.checkpoint(checkpointDirectory);

                /**

                 * 监控的是HDFS上的一个目录,监控文件数量的变化     文件内容如果追加监控不到。

                 * 只监控文件夹下新增的文件,减少的文件时监控不到的,文件的内容有改动也监控不到。

                 */

                //JavaDStream<String> lines = jsc.textFileStream("hdfs://node1:9000/spark/sparkstreaming");

                JavaDStream<String> lines = jsc.textFileStream("./data");

                JavaPairDStream<String, Integer> counts = lines.flatMap(new FlatMapFunction<String, String>() {

                    private static final long serialVersionUID = 1L;

                    @Override

                    public Iterable<String> call(String line) throws Exception {

                        return Arrays.asList(line.split(" "));

                    }

                }).mapToPair(new PairFunction<String, String, Integer>() {

                    private static final long serialVersionUID = 1L;

                    @Override

                    public Tuple2<String, Integer> call(String word) throws Exception

                    {

                        return new Tuple2<String, Integer>(word.trim(),1);

                    }

                }).reduceByKey(new Function2<Integer, Integer, Integer>() {

                    private static final long serialVersionUID = 1L;

                    @Override

                    public Integer call(Integer v1, Integer v2) throws Exception {

                        return v1+v2;

                    }

                });

                counts.print();

                return jsc;

            }

        };

        /**

         * 获取JavaStreamingContext 先去指定的checkpoint目录中去恢复JavaStreamingContext

         * 如果恢复不到,通过factory创建

         */

        JavaStreamingContext jsc = JavaStreamingContext.getOrCreate(checkpointDirectory, jscfactory);

        jsc.start();

        jsc.awaitTermination();

        jsc.close();//jsc.stop();

    }

}
参考:
【SparkStreaming学习之一】 SparkStreaming初识的更多相关文章
- 大数据学习day32-----spark12-----1. sparkstreaming(1.1简介,1.2 sparkstreaming入门程序(统计单词个数,updateStageByKey的用法,1.3 SparkStreaming整合Kafka,1.4 SparkStreaming获取KafkaRDD的偏移量,并将偏移量写入kafka中)
1. Spark Streaming 1.1 简介(来源:spark官网介绍) Spark Streaming是Spark Core API的扩展,其是支持可伸缩.高吞吐量.容错的实时数据流处理.Sp ...
- 二、Android学习第二天——初识Activity(转)
(转自:http://wenku.baidu.com/view/af39b3164431b90d6c85c72f.html) 一. Android学习第二天——初识Activity 昨天程序搭建成功以 ...
- Java学习-027-JSON 之一 -- 初识
通常,我们在生活中使用的应用产品(无论是 Web应用还是 App 应用),又或者我们平常的信息交流,均无可避免的存在着信息交互,在信息交互的过程中就有着信息载体的存在.那么,在我们熟知的网络应用产品中 ...
- WPF学习之路初识
WPF学习之路初识 WPF 介绍 .NET Framework 4 .NET Framework 3.5 .NET Framework 3.0 Windows Presentation Found ...
- Storm学习笔记 - Storm初识
Storm学习笔记 - Storm初识 1. Strom是什么? Storm是一个开源免费的分布式计算框架,可以实时处理大量的数据流. 2. Storm的特点 高性能,低延迟. 分布式:可解决数据量大 ...
- [转]git学习------>git-rev-parse命令初识
git学习------>git-rev-parse命令初识 2017年06月13日 10:04:13 阅读数:2172 一.准备工作 第一步:在d盘git test目录下,新建工作区根目录dem ...
- Spring 学习记录8 初识XmlWebApplicationContext(2)
主题 接上文Spring 学习记录7 初识XmlWebApplicationContext refresh方法 refresh方法是定义在父类AbstractApplicationContext中的. ...
- LevelDB学习笔记 (1):初识LevelDB
LevelDB学习笔记 (1):初识LevelDB 1. 写在前面 1.1 什么是levelDB LevelDB就是一个由Google开源的高效的单机Key/Value存储系统,该存储系统提供了Key ...
- 【SparkStreaming学习之四】 SparkStreaming+kafka管理消费offset
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 scala-2.10.4(依赖jdk1.8) spark ...
随机推荐
- Java 并发编程:线程间的协作(wait/notify/sleep/yield/join)
Java并发编程系列: Java 并发编程:核心理论 Java并发编程:Synchronized及其实现原理 Java并发编程:Synchronized底层优化(轻量级锁.偏向锁) Java 并发编程 ...
- 移除K位数字
1.题目来源:选自LeetCode 402: 2.问题描述: 3.问题分析 通过分析我们可以得出这样的结论:如果后一个数字比前面的数字小的话,那么我们就要把前面的一个数字删除掉,并且每次把字符串中拆出 ...
- (60)Wangdao.com第十天_JavaScript 函数_作用域_闭包_IIFE_回调函数_eval
函数 实现特定功能的 n 条语句封装体. 1. 创建一个函数对象 var myFunc = new Function(); // typeof myFunc 将会打印 function ...
- 变量类型-Tuple
教程:一:元组的创建 元组(tuple)与列表类似,不同之处在于元组的元素不能修改 (1)tuple写在圆括号之间,元素用逗号隔开 (2)元组元素的类型可以不同 (3) ...
- 如何从日期对象python获取以毫秒(秒后3位小数)为单位的时间值?
要在python中,要获取具有毫秒(秒后3位小数)的日期字符串,请使用以下命令: %f 显示毫秒 import datetime # 获得当前时间 now=datetime.datetime.now( ...
- Install sublime text for elementary os
1. download sublime_text_3_build_3176_x86.tar.gz from http://www.sublimetext.com/3 2. extract it to ...
- Java-多态经典例子
public class A { public String show(D obj) { return ("A and D"); } public String show(A ob ...
- JAVA RPC (七) 手把手从零教你写一个生产级RPC之client请求
上节说了关于通用请求代理,实际上对spring的bean引用都是通过koalasClientProxy来实现的,那么在代理方法中才是我们实际的发送逻辑,咱们先看一下原生的thrift请求是什么样的. ...
- java -cp通配符
JDK6支持java -cp后面跟通配符'*',试了一下发现还是需要注意: 错误方式(Wrong way): java -cp /data/apps/lib/*.jar com.chinacache ...
- Spark入门到精通--(第十节)环境搭建(ZooKeeper和kafka搭建)
上一节搭建完了Hive,这一节我们来搭建ZooKeeper,主要是后面的kafka需要运行在上面. ZooKeeper下载和安装 下载ZooKeeper 3.4.5软件包,可以在百度网盘进行下载.链接 ...