
【spark】共享变量
Spark中的两个重要抽象是RDD和共享变量。
一般情况下,当Spark在集群的多个不同节点的多个任务上并行运行一个函数的时候,
它会把函数中涉及到的每个变量在每个节点每个任务上都生成一个副本。
Spark 操作实际上操作的是这个函数所用变量的一个独立副本。
这些变量被复制到每台机器上,并且这些变量在远程机器上的所有更新都不会传递回驱动程序。
通常跨任务的读写变量是低效的。
但是,有时候我们需要在多个任务之间共享变量,或者在任务和任务控制节点之间共享变量。
为了满足这种需求,Spark提供了两种有限的共享变量:广播变量( broadcast variable )和累加器( accumulator )。
1.广播变量
广播变量用来把变量在所有节点的内存之间进行共享。
广播变量允许开发人员在每台机器上缓存一个只读的变量,而不是为每台机器上每个任务生成一个副本 。
Spark的任务操作一般会跨越多个阶段,对于每个阶段内的所有任务所需要的公共数据,Spark都会自动进行广播。
语法:
SparkContext.broadcase(v);
广播变量就是对普通变量v的一个包装器,通过调用value方法就可以获取这个广播变量的值。
//建立内容为Array(1,2,3)的广播变量

val broadcastVal = sc.broadcast(Array(1,2,3))

//获取广播变量的值

broadcastVal.value()
注意:我们在把变量v建立成广播变量后,在集群中的任何函数,都应该使用broadcase(v),而不是v本身,
这样就不会把v重复的分发到使用变量v的节点上。此外,我们一旦建立了broadcase(v)之后,就不行再次发生修改。
2.累加器
累加器支持在所有不同节点之间进行累加操作。
累加器是仅仅被相关操作累加的变量,通常可以被用来实现计数器和求和。
Spark原生地支持数值型(numeric)的累加器,也可以自己编写对新类型的累加器。
可以通过SparkContext.longAccumulator()或者SparkContext.doubleAccumulator()来创建累加器。
参数有两个(Int,String),第一个参数为初始累加值,默认为0,第二个参数为累加器的名字。
运行在集群中的任务,就可以使用add()方法来把数值累加到累加器上。
但是任务节点执行做累加操作,不能读取累加器的值,只有任务控制节点(Driver Program)可以使用value方法来读取。
import org.apache.spark._

object MyRdd {

    def main(args:Array[String]): Unit ={

        //初始化配置:设置主机名和程序主类的名字

        val conf = new SparkConf().setMaster("local").setAppName("MyRdd");

        //通过conf来创建sparkcontext

        val sc = new SparkContext(conf);

        val accum = sc.longAccumulator("My Accumulator");//后边是计数器的名字

        val list = List(1,2,3,4,5);

        val rdd = sc.parallelize(list);

        rdd.foreach(x => accum.add(x));//调用累加器求和

        accum.value;//注意只有任务控制节点(Driver节点)才能使用value方法来获取累加器的值

    }

}
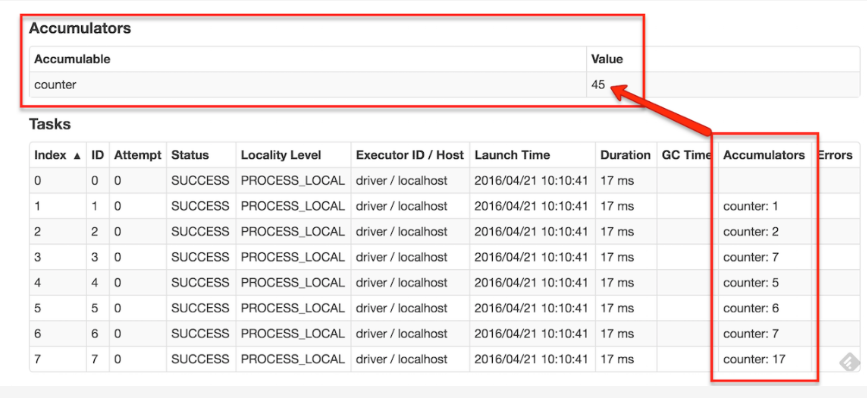
如果创建了一个具名的累加器,它可以在spark的UI中显示。这对于理解运行阶段(running stages)的过程有很重要的作用。
【spark】共享变量的更多相关文章
- spark共享变量
boradcast例子代码: scala版本 spark共享变量之Accumulator 例子代码: scala版本
- 7.spark共享变量
spark共享变量 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹性分布式数据集 ...
- Spark——共享变量
Spark执行不少操作时都依赖于闭包函数的调用,此时如果闭包函数使用到了外部变量驱动程序在使用行动操作时传递到集群中各worker节点任务时就会进行一系列操作: 1.驱动程序使将闭包中使用变量封装成对 ...
- Spark共享变量(广播变量、累加器)
转载自:https://blog.csdn.net/Android_xue/article/details/79780463 Spark两种共享变量:广播变量(broadcast variable)与 ...
- SPARK共享变量:广播变量和累加器
Shared Variables Spark does provide two limited types of shared variables for two common usage patte ...
- Spark分布式编程之全局变量专题【共享变量】
转载自:http://www.aboutyun.com/thread-19652-1-1.html 问题导读 1.spark共享变量的作用是什么?2.什么情况下使用共享变量?3.如何在程序中使用共享变 ...
- 9.Spark Streaming
Spark Streaming 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹性 ...
- 8.Spark SQL
Spark SQL 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹性分布式数据集 ...
- 5.spark弹性分布式数据集
弹性分布式数据集 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹性分布式数据集 ...
- 4.Apache Spark的工作原理
Apache Spark的工作原理 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark ...
随机推荐
- 这些Python骚操作,你知道吗?
0x00 世界,你好 程序员第一次接触语言或者框架,基本上都有个 Hello World 的例子,这里 Python 直接将它做成了一个包. 0x01 Python 哲学 Python 执行 i ...
- java 遍历map的方法
package com.jackey.topic; import java.util.ArrayList;import java.util.HashMap;import java.util.Itera ...
- 002-使用java类调用quartz
一.工具类 package com.tech.jin.jobScheduler; import java.text.ParseException; import java.util.ArrayList ...
- 使用哈工大LTP进行句法分析
作者注:本教程旨在对哈工大LTP在github上的LTP4J(LTP的java版本)教程的补充,请结合以下参考网站一起食用. 参考网站: [1]哈工大语言技术平台云官网--LTP使用文档 http:/ ...
- appium入门基础
1. 建立session时常用命令: DesiredCapabilities cap = new DesiredCapabilities(); cap.SetCapability("brow ...
- nginx常用
1.rewrite return 301 http://example.com$request_uri; rewrite ^ http://example.com permanent; 2.try_f ...
- Python 网络编程了解
阅读目录 一: 网络编程socket http://www.cnblogs.com/zhoujunhao/articles/7592671.html 二: TCP粘包处理 http://www.cnb ...
- 在python中有多少种运算符?解释一下算术运算符
在python中,我们有7种运算符:算术运算符.关系运算符.赋值运算符.逻辑运算符.位运算符.成员运算符.身份运算符 我们有7个算术运算符,能让我们对数值进行算术计算 1.加号(+),将两个值相加 2 ...
- 微信小程序组件swiper
视图容器swiper:官方文档 Demo Code Page({ data:{ imgUrls: [ 'http://img02.tooopen.com/images/20150928/tooopen ...
- maven自动化构建deploy
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/20 ...