
GPS地图生成03之数据获取
1. 引言
六只脚是国内著名的户外网站,拥有大量的户外GPS轨迹路线,网址为:http://www.foooooot.com/ 
2. 数据分析
2.1 获取所有轨迹
搜索关键词岳麓山:
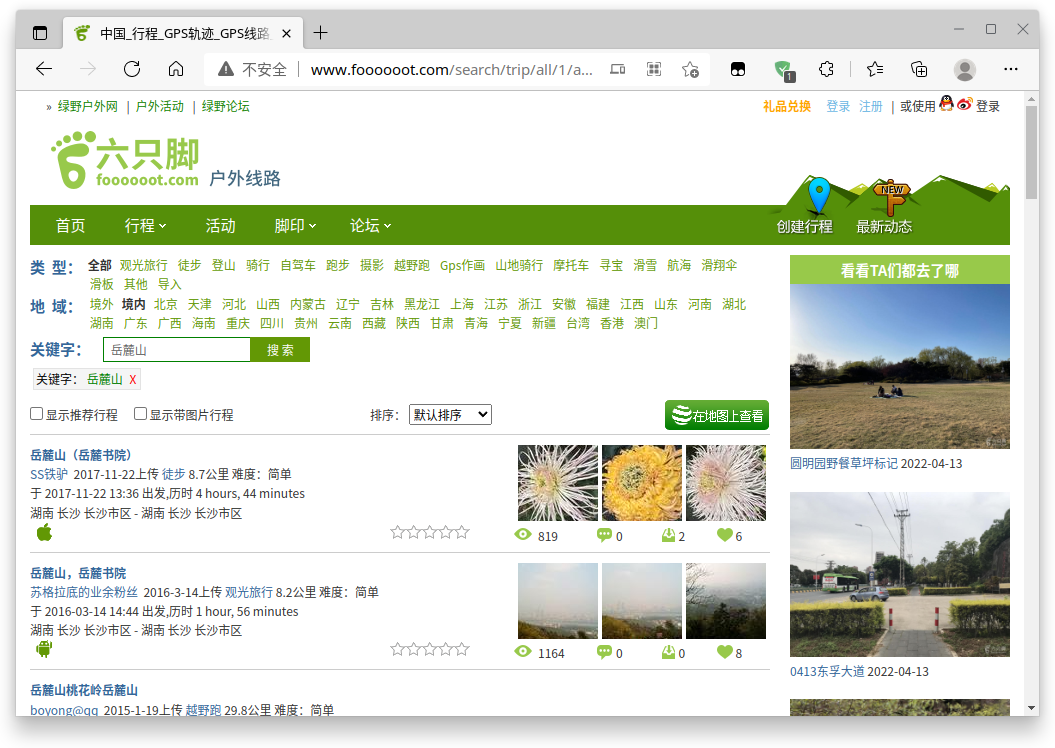
可以发现,每页具有三十个轨迹记录
观察第二页的网址我们可以发现网址为:http://www.foooooot.com/search/trip/all/1/all/time/descent/?page=2&keyword=%E5%B2%B3%E9%BA%93%E5%B1%B1 不难发现其规律:
- page为页数
- keyword为
岳麓山的转义
我们不妨测试page为50的情况,在浏览器输入http://www.foooooot.com/search/trip/all/1/all/time/descent/?page=50&keyword=%E5%B2%B3%E9%BA%93%E5%B1%B1:
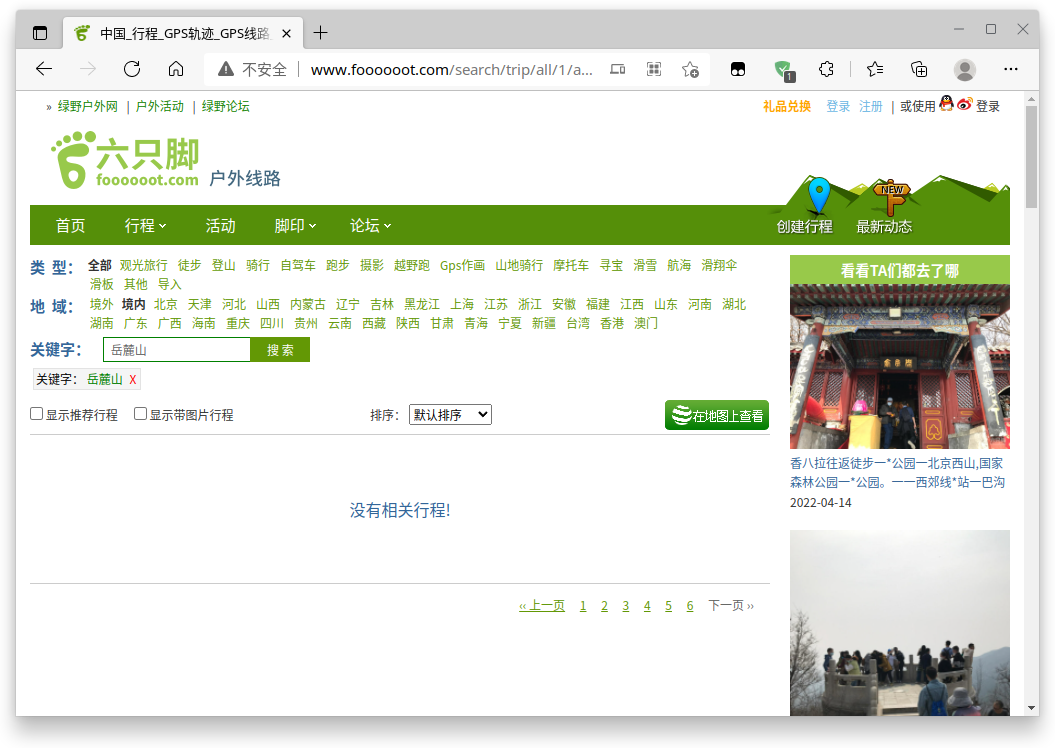
小结:我们可以通过不断增加page的数字,直至某一页不满足三十个轨迹记录,获取该关键词所有的轨迹记录
2.2 获取轨迹ID
点击某个具体的轨迹详情:
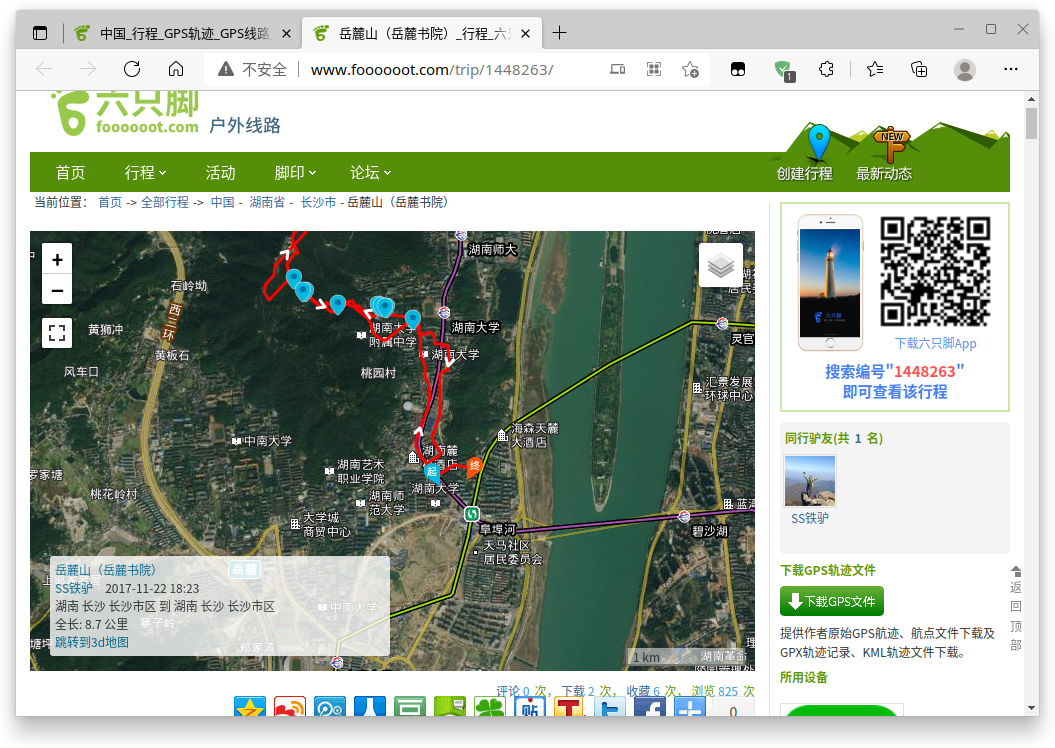
可以看到每一页具体的轨迹页面的网址是由轨迹ID构造的,诸如:http://www.foooooot.com/trip/1448263/
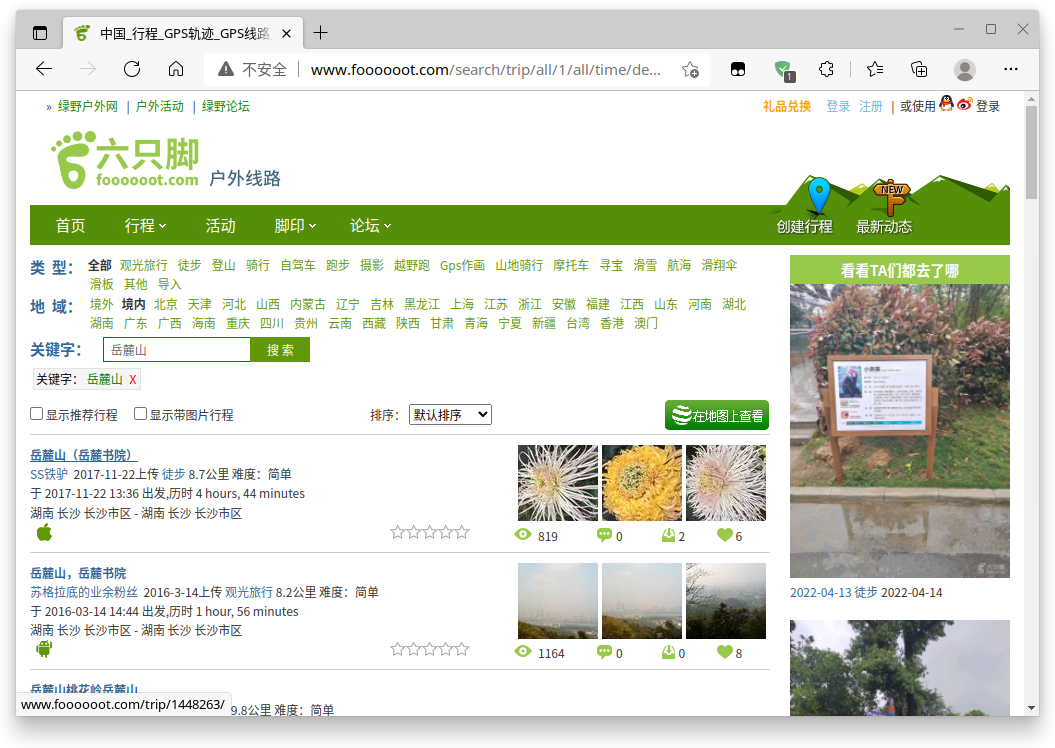
从刚才的列表界面我们就可以找到每个轨迹ID:
2.3 获取轨迹数据
我们打开浏览器控制台(按F12),点击到网络记录界面,刷新网址:
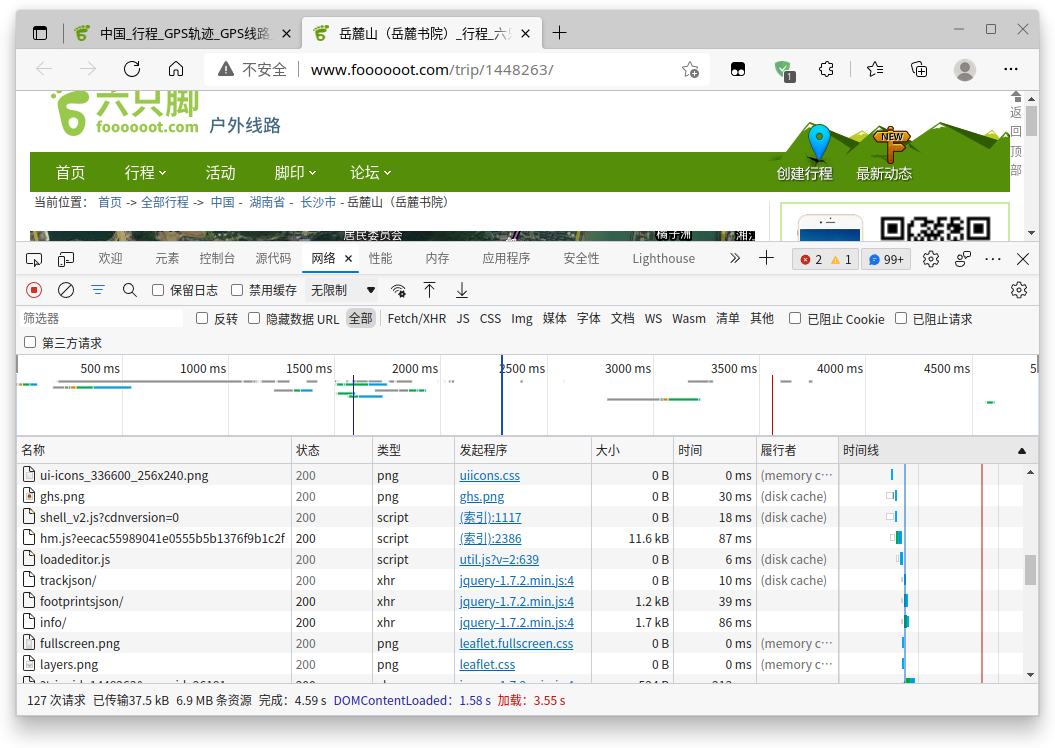
从网络请求记录中我们发现有两个XHR异步请求其名字很像轨迹数据,点开查看:
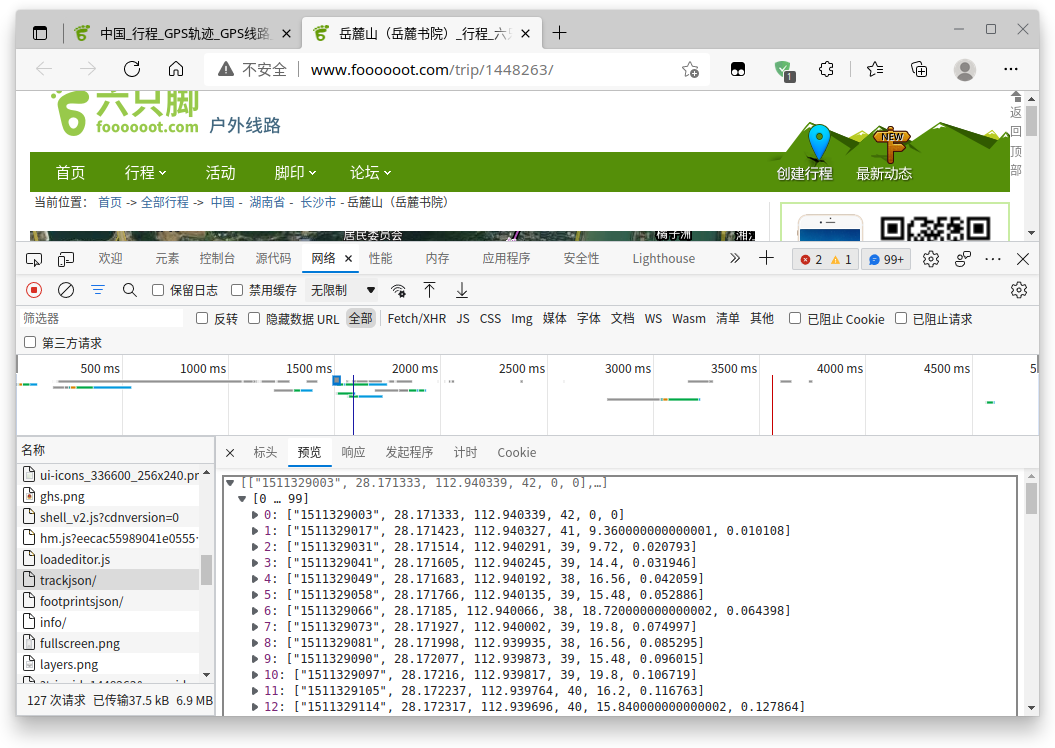
可以看到,这个trackjson就是轨迹的JSON数据:
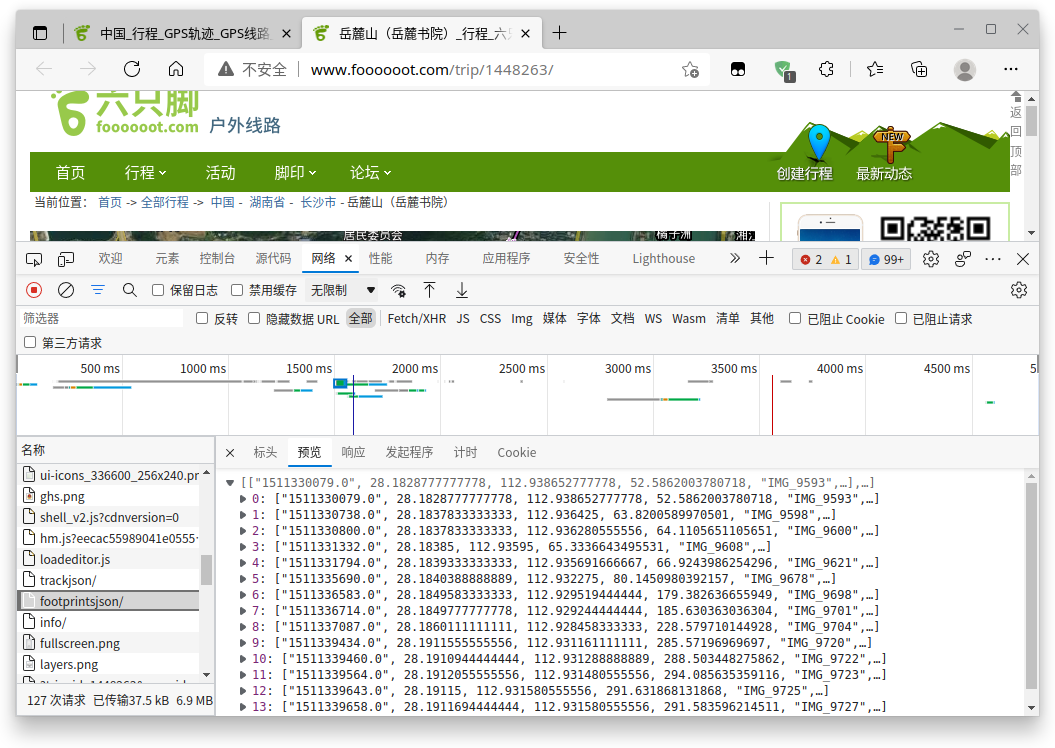
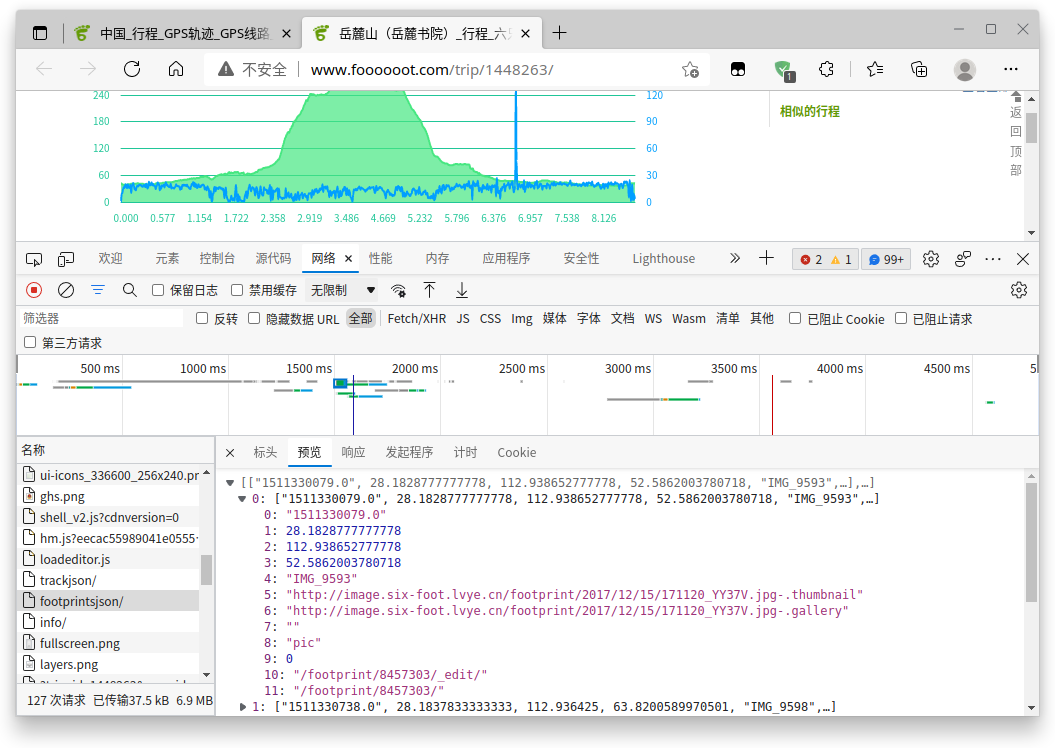
这个footprintsjson就是足迹数据,也就是拍照的那种数据:
2.4 字段解释
对于trackjson,前三列个数据项可以快速判断为时间戳和经纬度,对于后面三个数据项,结合网页数据:
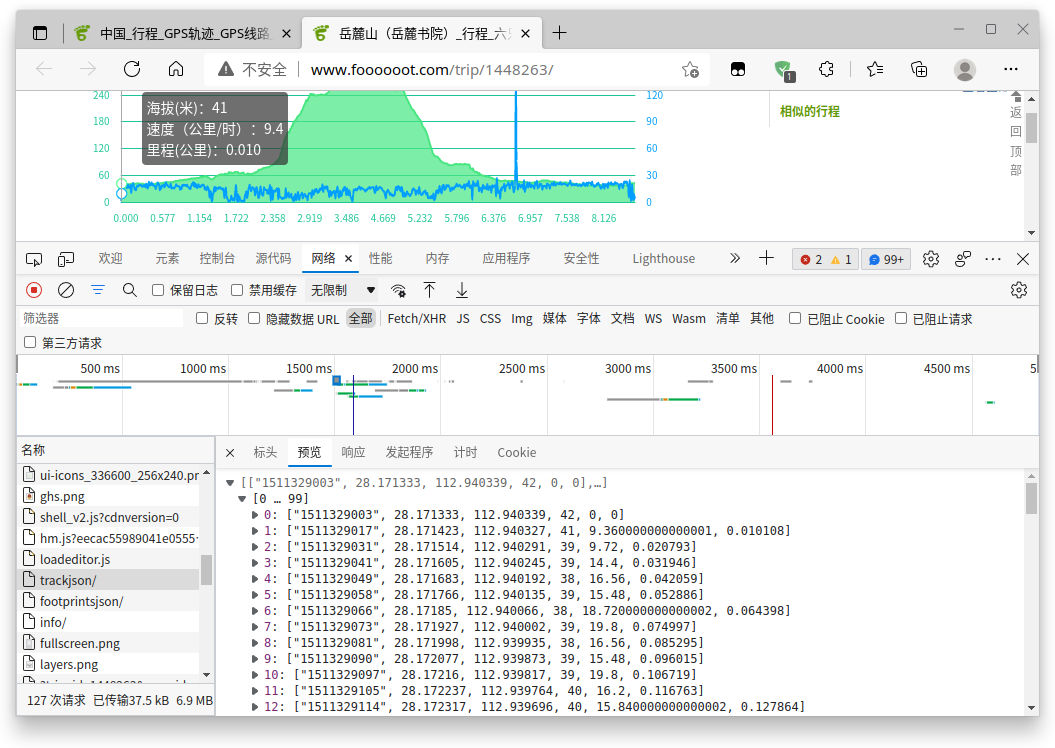
可以判断分别为高程,速度和里程
对于footprintsjson,可以判断前几列数据项分别为时间戳、经纬度、高程、名字、缩略图、详情图,后面几项笔者认为没啥作用
3. 数据爬取
经过上面的数据分析,爬取轨迹数据主要就是通过page和keyword构造网址获取轨迹ID,通过轨迹ID构造地址获取trackjson和footprintsjson
笔者此处基于Python,使用requests库发送http请求,使用Xpath解析界面提取数据
3.1 引入库
import requests

from lxml import etree

import json

import time- 注意: 如果缺少相关库,请使用pip或者conda安装
3.2 获取所有轨迹ID
page_num = 1

track_num_arr = []

keyword = "岳麓山"

headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36'}

page_url = "http://www.foooooot.com/search/trip/all/1/all/time/descent/?page=" + str(page_num) + "&keyword=" + keyword- 注意:发起请求请务必设置休眠时间,瞬间的大量访问请求会导致网站崩溃
- 目前此网站设置了简易反爬措施,不设置'user-agent'将 无法访问
next_page = True

while(next_page):

    response = requests.get(page_url,timeout=5, headers=headers)

    tree = etree.HTML(response.text)

    trip_list = tree.xpath('//p[@class="trip-title"]/a/@href')

    if(len(trip_list) == 30):

        page_num = page_num + 1

        page_url = "http://www.foooooot.com/search/trip/all/1/all/time/descent/?page=" + str(page_num) + "&keyword=" + keyword

    else:

        next_page = False

    for trip in trip_list:

        track_num_arr.append(trip.split('/')[2])

time.sleep(6)print(len(track_num_arr))1170可以看到有1170条轨迹数据
3.3 获取轨迹数据
num = 0

for track_num in track_num_arr:

    try:

        #设置重连次数

        requests.adapters.DEFAULT_RETRIES = 5

        s = requests.session()

        # 设置连接活跃状态为False

        s.keep_alive = False

        time.sleep(6)

        footprint_url = "http://www.foooooot.com/trip/" + str(track_num) + "/footprintsjson/"

        trackjson_url = "http://www.foooooot.com/trip/" + str(track_num) + "/trackjson/"

        footprint_res = requests.get(footprint_url,headers=headers,stream=False,timeout= 10)

        trackjson_res = requests.get(trackjson_url,headers=headers,stream=False,timeout= 10)

        try:

            trackjson = json.loads(trackjson_res.text)

            footprint = json.loads(footprint_res.text)

            with open("./trackdata/origin/trackjson" +  str(track_num) + ".json","w") as tf:

                json.dump(trackjson,tf)

            with open("./trackdata/origin/footprint" +  str(track_num) + ".json","w") as ff:

                json.dump(footprint,ff)

            for track in trackjson:

                with open("./trackdata/trip_" +  str(track_num) + ".txt","a") as tf:

                    tf.write(str(track[1]) + " " + str(track[2]) + " " + str(track[3]) + " " + str(int(track[0])) + "\n")

                with open("./trackdata/all.csv","a") as af:

                    af.write(str(num) + "," + str(track[2]) + "," + str(track[1]) + "," + str(track[3]) + "," + str(track_num) + "," + str(int(track[0])) + "\n")

                    num = num + 1

            # print("DONE: " + track_num)

            # 关闭请求  释放内存

            footprint_res.close()

            trackjson_res.close()

            del(footprint_res)

            del(trackjson_res)

        except Exception as we:

            print(we)

            print("ERROR: " + track_num)

            with open("./trackdata/error.txt","a") as af:

                af.write(str(track_num) + '\n')

            # 关闭请求  释放内存

            footprint_res.close()

            trackjson_res.close()

            del(footprint_res)

            del(trackjson_res)

    except Exception as ce:

        print(ce)

        time.sleep(60)
Expecting value: line 1 column 1 (char 0)
ERROR: 3541376
Expecting value: line 1 column 1 (char 0)
ERROR: 3541373
Expecting value: line 1 column 1 (char 0)
ERROR: 3541372
Expecting value: line 1 column 1 (char 0)
ERROR: 3541371
Expecting value: line 1 column 1 (char 0)
ERROR: 3541430
Expecting value: line 1 column 1 (char 0)
ERROR: 3505289
Expecting value: line 1 column 1 (char 0)
ERROR: 5135959
Expecting value: line 1 column 1 (char 0)
ERROR: 3390423
Expecting value: line 1 column 1 (char 0)
ERROR: 3389498
Expecting value: line 1 column 1 (char 0)
ERROR: 3392149
Expecting value: line 1 column 1 (char 0)
ERROR: 3392065
Expecting value: line 1 column 1 (char 0)
ERROR: 3392040- 笔者遇到过IO错误和连接错误,所以用try except包裹起来,但是两层try总觉得不对劲
- trip_track_num.txt 这个文件写法主要是参考map construction的轨迹文件
- 经笔者验证,
ERROR的那几个轨迹确实没有数据
4. 可视化
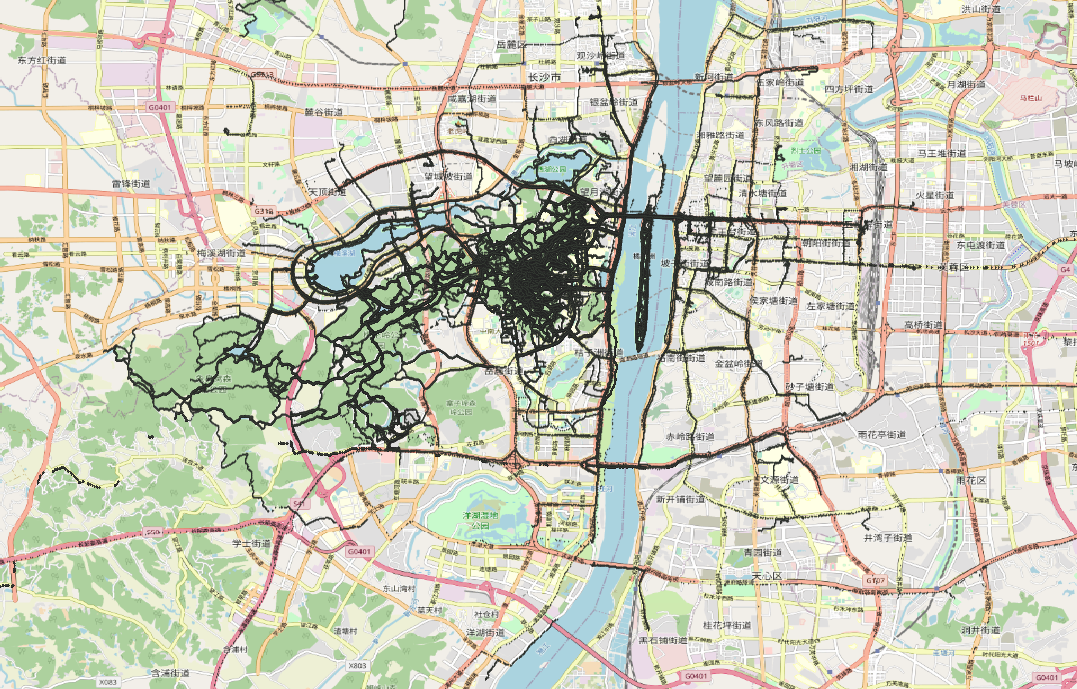
在QGIS中利用加载XY文件的方式加载all.csv文件,并设置OSM底图,预览GPS轨迹:
GPS地图生成03之数据获取的更多相关文章
- unity3d WorldComposer1 卫星地图生成地形
http://blog.csdn.net/myarrow/article/details/42709113 1. 简介 1.1 TerrainComposer(TC) 一个Unity扩展工具,可用于创 ...
- Android百度地图开发03之地图控制 + 定位
前两篇关于百度地图的blog写的是,一些基本图层的展示 和 覆盖物的添加+地理编码和反地理编码. 接下来,这篇blog主要说一些关于地图控制方面的内容和定位功能. 百度地图提供的关于地图的操作主要有: ...
- iPhone手机GPS地图位置好帮手
十一国庆黄金周近在眉睫,我先祝大家过一个愉快开心的国庆长假. 假期内,难免老友聚会吃饭聊天联络感情,年轻朋友相亲约会,一家人出门旅游.平时,我们聚会时,总有要来的人找不到聚会地点,需要反复打电话确认: ...
- RaceWeb介绍(7):由500强公司数据高速生成百度地图——生成坐标字段及坐标数据
接上篇. 一.生成X坐标.Y坐标两个字段. 我们须要为每一个公司建立X坐标和Y坐标字段,用来保存XY坐标. 既然为了突出"快",这一步就有程序来完毕吧. 右键单击"世界5 ...
- echarts使用------地图生成----省市地图的生成及其他相关细节调整
为使用多种业务场景,百度echarts地图示例只有中国地图,那么在使用省市地图的时候,就需要我们使用省市的地图数据了 以下为陕西西安市的地图示例: 此页面引用echarts的js:http://ech ...
- Unity 随机房间地图生成
无论是在迷宫还是类似于地牢的游戏地图中,利用程序来生成每次都不一样的地图是一件叫人兴奋不已的事. 这时我们需要解决两个非常重要的随机事件: 1.在一定范围内随机出各不相同但又不能互相重叠的房间 2.优 ...
- 帝国CMS网站地图生成插件
可以生成电脑端也可以生成手机端的地图XML. 安装方法: 这个帝国sitemap插件的安装跟其他插件的安装方式一样,介于可能有人不会安装帝国的插件,就写一下吧,以后你们如果碰到帝国插件也可以参考这个. ...
- Unity3d 随机地图生成
2D解析图: 3D地形: 嘿嘿.
- gps 地图
http://www.cnblogs.com/sylvanas2012/p/5342530.html http://blog.csdn.net/ma969070578/article/details/ ...
- unity2018使用tileMap生成地图 类似泰拉瑞亚创建和销毁地图块
参考网站:https://blog.csdn.net/pz789as/article/details/79540890 using System.Collections; using System.C ...
随机推荐
- 【Flume】概述及组成、入门案例、进阶(事务、拓扑结构)、不同拓扑案例、自定义、数据流监控Ganglia
一.概述 1.定义 日志采集.聚合.传输的系统,基于流式结构 即:读取本地磁盘数据,写入HDFS或kafka 2.架构 Agent:JVM进程,以事件形式将数据送到目的地. Agent由三部分组成:S ...
- 三道MISC的writeup
(1)背时 描述:腐烂了,变异了,太背时了...... 附件为一个压缩包 解题思路: 1.打开压缩包,发现有一个描述:v(51wA:I7uABi#Bx(T 2.将v(51wA:I7uABi#Bx(T进 ...
- Django静态文件配置(from表单-request对象方法-get请求与post请求-视图函数书写)
目录 一:静态文件配置 1.静态文件配置 2.什么是静态文件? 3.静态文件的创建 4.解决使用django后端代码修改前端不显示(缓存问题) 5.settings.py 静态文件配置 6.静态文接口 ...
- ORM增删改查 django请求生命周期图 django路由层及反向解析
目录 可视化界面之数据增删改查 1.建表 2.数据展示功能 3.数据添加功能 4.数据编辑功能 5.数据删除功能 django请求生命周期流程图 django路由层 1.路由匹配 2.转换器功能 pa ...
- 前端知识之JS(javascirpt)
目录 JS简介 JS基础 1.注释语法 2.引入JS的多种方式 3.结束符号 变量与常量 基本数据类型 1.数字类型(Number) 2.字符类型(string) 3.布尔类型(Boolean) 4. ...
- [python] tensorflow中的argmax()函数argmax()函数
首先 import tensorflow as tf tf.argmax(tenso,n)函数会返回tensor中参数指定的维度中的最大值的索引或者向量.当tensor为矩阵返回向量,tensor为向 ...
- 诗词API
1.js依赖 /** * 今日诗词V2 JS-SDK 1.2.2 * 今日诗词API 是一个可以免费调用的诗词接口:https://www.jinrishici.com */ !function(e) ...
- Java入门与进阶 P-3.5+P-3.6
计数循环 这个循环需要执行多少次? 循环停下来的时候,有没有输出到最后的0 ? 循环结束后count的值是多少 算数平方 让用户输入一系列的正整数,最后输入-1标识输入结束,然后程序计算出这些数字的平 ...
- 时间日期相关总结-System类的常用方法
时间日期相关总结 Date类 A.构造方法 Date();根据当前系统时间创建日期对象 Date(long time);根据传入的毫秒值时间创建日期对象 B.成员方法 long getTime(); ...
- 搭个ChatGPT算法模型,离Java程序员有多远?
作者:小傅哥 博客:https://bugstack.cn 沉淀.分享.成长,让自己和他人都能有所收获! 最近 ChatGPT 很火,火到了各行各业.记得去年更多的还是码农最新体验后拿它搜代码,现在各 ...