
Python的scrapy之爬取51job网站的职位
今天老师讲解了Python中的爬虫框架--scrapy,然后带领我们做了一个小爬虫--爬取51job网的职位信息,并且保存到数据库中
用的是Python3.6 pycharm编辑器
爬虫主体:
import scrapy
from ..items import JobspidersItem class JobsspiderSpider(scrapy.Spider):
name = 'jobsspider'
#allowed_domains = ['search.51job.com/list/010000,000000,0000,00,9,99,%2520,2,1.html']
#start_urls = ['https://search.51job.com/list/010000,000000,0000,00,9,99,%2520,2,1.html/']
start_urls = [
'https://search.51job.com/list/010000,000000,0000,01,9,99,python,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare='] def parse(self, response):
currentPageItems = response.xpath('/html/body/div[@class="dw_wp"]/div[@class="dw_table"]/div[@class="el"]')
print(currentPageItems) # currentPageItems = response.xpath('//div[@class="el"]')
for jobItem in currentPageItems:
print('----',jobItem)
jobspidersItem = JobspidersItem() jobPosition = jobItem.xpath('p[@class="t1 "]/span/a/text()').extract()
if jobPosition:
#print(jobPosition[0].strip())
jobspidersItem['jobPosition'] = jobPosition[0].strip() jobCompany = jobItem.xpath('span[@class="t2"]/a/text()').extract()
if jobCompany:
#print(jobCompany[0].strip())
jobspidersItem['jobCompany'] = jobCompany[0].strip() jobArea = jobItem.xpath('span[@class="t3"]/text()').extract()
if jobArea:
#print(jobArea[0].strip())
jobspidersItem['jobArea'] = jobArea[0].strip() jobSale = jobItem.xpath('span[@class="t4"]/text()').extract()
if jobSale:
# print(jobCompany[0].strip())
jobspidersItem['jobSale'] = jobSale[0].strip() jobDate = jobItem.xpath('span[@class="t5"]/text()').extract()
if jobDate:
# print(jobCompany[0].strip())
jobspidersItem['jobDate'] = jobDate[0].strip() yield jobspidersItem # 通过yield 调用输出管道
pass
nextPageURL = response.xpath('//li[@class="bk"]/a/@href').extract() # 取下一页的地址
print(nextPageURL)
if nextPageURL:
url = response.urljoin(nextPageURL[-1])
print('url', url)
# 发送下一页请求并调用parse()函数继续解析
yield scrapy.Request(url, self.parse, dont_filter=False)
pass
else:
print("退出")
pass
items.py 设置五个items
import scrapy

class JobspidersItem(scrapy.Item):

    # define the fields for your item here like:

    jobPosition = scrapy.Field()

    jobCompany = scrapy.Field()

    jobArea = scrapy.Field()

    jobSale = scrapy.Field()

    jobDate = scrapy.Field()

    pass
pipelines.py 输出管道
class JobspidersPipeline(object):

    def process_item(self, item, spider):

        print('职位:', item['jobPosition'])

        print('公司:', item['jobCompany'])

        print('工作地点:', item['jobArea'])

        print('薪资:', item['jobSale'])

        print('发布时间:', item['jobDate'])

        print('----------------------------')

        return item
pipelinesmysql.py 输出到mysql中 第一行的意思是使用了以前封装的数据库操作类
from week5_day04.dbutil import dbutil

# 作业: 自定义的管道,将完整的爬取数据,保存到MySql数据库中

class JobspidersPipeline(object):

    def process_item(self, item, spider):

        dbu = dbutil.MYSQLdbUtil()

        dbu.getConnection()  # 开启事物

        # 1.添加

        try:

            #sql = "insert into jobs (职位名,公司名,工作地点,薪资,发布时间)values(%s,%s,%s,%s,%s)"

            sql = "insert into t_job (jobname,jobcompany,jobarea,jobsale,jobdata)values(%s,%s,%s,%s,%s)"

            #date = []

            #dbu.execute(sql, date, True)

            dbu.execute(sql, (item['jobPosition'],item['jobCompany'],item['jobArea'],item['jobSale'],item['jobDate']),True)

            #dbu.execute(sql,True)

            dbu.commit()

            print('插入数据库成功!!')

        except:

            dbu.rollback()

            dbu.commit()  # 回滚后要提交

        finally:

            dbu.close()

        return item
最终结果:
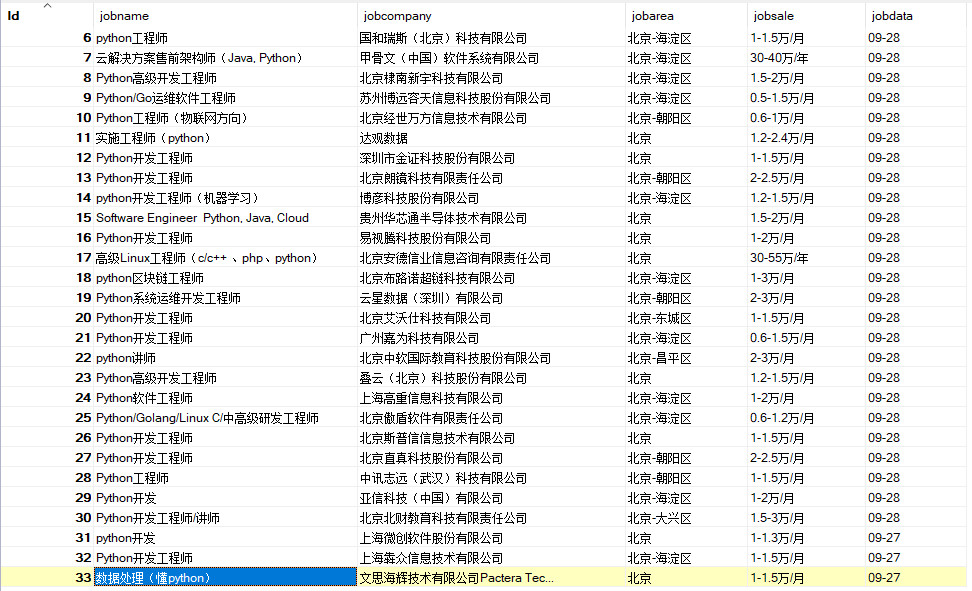
通过这个最基础的51job爬虫,进入到scrapy框架的学习中,这东西挺好使
Python的scrapy之爬取51job网站的职位的更多相关文章
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
- 初识python 之 爬虫:爬取某网站的壁纸图片
用到的主要知识点:requests.get 获取网页HTMLetree.HTML 使用lxml解析器解析网页xpath 使用xpath获取网页标签信息.图片地址request.urlretrieve ...
- scrapy版本爬取某网站,加入了ua池,ip池,不限速不封号,100个线程爬崩网站
目录 scrapy版本爬取妹子图 关键所在下载图片 前期准备 代理ip池 UserAgent池 middlewares中间件(破解反爬) settings配置 正题 爬虫 保存下载图片 scrapy版 ...
- Python的scrapy之爬取boss直聘网站
在我们的项目中,单单分析一个51job网站的工作职位可能爬取结果不太理想,所以我又爬取了boss直聘网的工作,不过boss直聘的网站一次只能展示300个职位,所以我们一次也只能爬取300个职位. jo ...
- python爬虫scrapy框架——爬取伯乐在线网站文章
一.前言 1. scrapy依赖包: 二.创建工程 1. 创建scrapy工程: scrapy staratproject ArticleSpider 2. 开始(创建)新的爬虫: cd Artic ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- Python的scrapy之爬取6毛小说网的圣墟
闲来无事想看个小说,打算下载到电脑上看,找了半天,没找到可以下载的网站,于是就想自己爬取一下小说内容并保存到本地 圣墟 第一章 沙漠中的彼岸花 - 辰东 - 6毛小说网 http://www.6ma ...
随机推荐
- c#利用三层架构做一个简单的登录窗体
就个人而言,三层架构有点难理解,不知道该如何下手,各层与各层之间怎么调用 最近一直在研究三层架构,经过网上学习与多方打听写一下自己的心得.有不足之处,可以评论和私聊探讨 言归正传: 三层架构(3-ti ...
- Locust性能测试3 no-web运行
Locust也支持no-web的方式运行,直接通过控制台设置并发用户数.每秒启动用户数.持续压测时间. locust -f 脚本路径 -c 用户数 -r 每秒启动用户数 --run-time 持续压测 ...
- C语言 Printf函数
#include <stdio.h> int main(int argc, const char * argv[]) { // insert code here... printf(&qu ...
- POJ-1759 Garland---二分+数学
题目链接: https://cn.vjudge.net/problem/POJ-1759 题目大意: N个灯泡离地H_i,满足H1 = A ,Hi = (Hi-1 + Hi+1)/2 – 1,HN = ...
- 实现新layer的时候易犯的错误
实现新layer后,如果我还是在原来的build文件夹里面make,好像是不会编译新的层的,所以跑程序会报没有你新添加的这个层.要么make clear重新make,要么就直接./build.sh,这 ...
- Android学习笔记_70_一个应用程序启动另一个应用程序的Activity
第一种(我自己写的) :之前在网上看来一些,很多不是我要的可以启动另外一个应用程序的主Activity. //这些代码是启动另外的一个应用程序的主Activity,当然也可以启动任意一个Activit ...
- java使用JSCH连接FTP(Linux服务器)上传文件到Linux服务器
首先需要用到jsch-0.1.54.jar 包: 链接: https://pan.baidu.com/s/1kZR6MqwpCYht9Pp_D6NKQw 密码: gywx 直接上代码: package ...
- 使用dva框架的总结
最近的项目是react+dva+atd+webpack的一个后台项目,刚接触dva就感觉很喜欢,很简洁用着很爽. 关于使用redux中的一些问题 1.文件切换问题. redux的项目通常哟啊分为red ...
- 制作npm插件vue-toast-m实例练习
制作npm插件vue-toast-m实例练习(消息弹窗) 一.使用npm插件 import VueToast from 'vue-toast-demo-cc' Vue.use(VueToast) th ...
- ACL常用命令及工作原理
What ACL 是一系列 IOS 命令,根据数据包报头中找到的信息来控制路由器应该转发还是应该丢弃数据包.ACL 是思科 IOS 软件中最常用的功能之一. 在配置后,ACL 将执行以下任务: 限制网 ...