
初识python 之 爬虫:爬取某网站的壁纸图片
用到的主要知识点:
requests.get 获取网页HTML
etree.HTML 使用lxml解析器解析网页
xpath 使用xpath获取网页标签信息、图片地址
request.urlretrieve 下载图片(注:该网站使用urlretrieve下载图片时,返回403错误。原因目前未知!)
改用 with as 下载图片:
with open('文件地址及名字', 'wb') as f:
f.write(res.content)
详细代码如下:
#!/user/bin env python

# author:Simple-Sir

# time:2019/7/17 10:14

# 爬取某网站的壁纸图片

import requests

from lxml import etree

from urllib import request

import urllib

import time

# 伪装浏览器

headers ={

    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36',

}

# 获取壁纸首页网页信息并解析

def getUrlText(url):

    respons = requests.get(url,headers=headers)  # 获取网页信息

    urlText = respons.text

    html = etree.HTML(urlText)  # 使用lxml解析网页

    return html

# 提取壁纸链接地址列表

def getWallUrl(url):

    hrefUrl = getUrlText(url)

    section = hrefUrl.xpath('//section[@class="thumb-listing-page"]')[0]  # 获取section标签

    hrefList = section.xpath('./ul//@href')  # 获取首页图片对应链接地址

    return hrefList

# 获取当前时间

def getTime():

    nowtime = time.strftime('%Y-%m-%d %H:%M:%S', time.localtime(time.time()))

    return nowtime

# 解析壁纸下载地址

def downWall(url,page):

    '''

    :param url: 网页地址

    :param page: 下载页数

    :return: 下载结束提醒

    '''

    m = 0

    page += 1

    for i in range(1,page):

        hrefList = getWallUrl(url+str(i))

        n = 0

        print('\033[36;1m*********** 开始下载第{}页壁纸 ************\033[0m'.format(i))

        for href in hrefList:

            n += 1

            imgUrl = getUrlText(href) # 获取壁纸链接网页信息并解析

            imgSrc = imgUrl.xpath('//img[@id="wallpaper"]/@src')[0]

            # strUl = etree.tostring(imgSrc, encoding='utf-8').decode('utf-8')  # 对获取到ul解码

            # print(strUl)

            imgType = imgSrc[-4:]  # 壁纸格式

            print('{}:\033[31;1m开始下载第{}页第{}张壁纸\033[0m'.format(getTime(),i,n))

            # request.urlretrieve(imgSrc, './wall/' + str(n) + imgType) #403错误

            res = requests.get(imgSrc)

            with open('./wall/'+str(i)+'_'+str(n)+imgType, 'wb') as f:

                f.write(res.content)

            print('{}:\033[31;1m第{}页第{}张壁纸下载完成\033[0m'.format(getTime(),i,n))

        m = m + n

    return print('{}:\033[36;1m所有壁纸已下载完成,一共{}页{}张。\033[0m'.format(getTime(),i,m))

# url = 'https://wallhaven.cc/search?q=id%3A711&ref=fp&tdsourcetag=s_pcqq_aiomsg&page='

if __name__ == '__main__':

    page =int(input('\033[36;1m请输入你想下载的页数:\033[0m'))

    print('\033[36;1m程序执行中,请稍等。。。即将下载。\033[0m')

    downWall('https://wall***&page=',page)
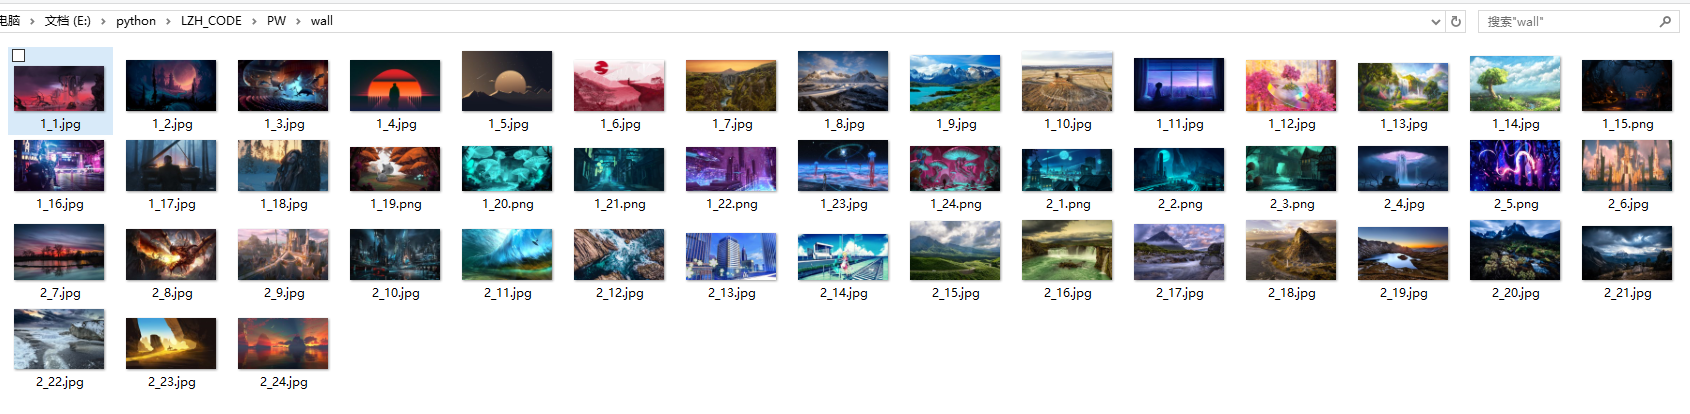
运行结果:


初识python 之 爬虫:爬取某网站的壁纸图片的更多相关文章
- 如何利用Python网络爬虫爬取微信朋友圈动态--附代码(下)
前天给大家分享了如何利用Python网络爬虫爬取微信朋友圈数据的上篇(理论篇),今天给大家分享一下代码实现(实战篇),接着上篇往下继续深入. 一.代码实现 1.修改Scrapy项目中的items.py ...
- 利用Python网络爬虫爬取学校官网十条标题
利用Python网络爬虫爬取学校官网十条标题 案例代码: # __author : "J" # date : 2018-03-06 # 导入需要用到的库文件 import urll ...
- python爬虫--爬取某网站电影下载地址
前言:因为自己还是python世界的一名小学生,还有很多路要走,所以本文以目的为向导,达到目的即可,对于那些我自己都没弄懂的原理,不做去做过多解释,以免误人子弟,大家可以网上搜索. 友情提示:本代码用 ...
- python爬虫--爬取某网站电影信息并写入mysql数据库
书接上文,前文最后提到将爬取的电影信息写入数据库,以方便查看,今天就具体实现. 首先还是上代码: # -*- coding:utf-8 -*- import requests import re im ...
- python之简单爬取一个网站信息
requests库是一个简介且简单的处理HTTP请求的第三方库 get()是获取网页最常用的方式,其基本使用方式如下 使用requests库获取HTML页面并将其转换成字符串后,需要进一步解析HTML ...
- python爬虫---爬取王者荣耀全部皮肤图片
代码: import requests json_headers = { "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win ...
- 利用python实现爬虫爬取某招聘网站,北京地区岗位名称包含某关键字的所有岗位平均月薪
#通过输入的关键字,爬取北京地区某岗位的平均月薪 # -*- coding: utf-8 -*- import re import requests import time import lxml.h ...
- Python多线程爬虫爬取电影天堂资源
最近花些时间学习了一下Python,并写了一个多线程的爬虫程序来获取电影天堂上资源的迅雷下载地址,代码已经上传到GitHub上了,需要的同学可以自行下载.刚开始学习python希望可以获得宝贵的意见. ...
- 如何用Python网络爬虫爬取网易云音乐歌曲
今天小编带大家一起来利用Python爬取网易云音乐,分分钟将网站上的音乐down到本地. 跟着小编运行过代码的筒子们将网易云歌词抓取下来已经不再话下了,在抓取歌词的时候在函数中传入了歌手ID和歌曲名两 ...
随机推荐
- Java poi导出设置 Excel某些单元格不可编辑
小白的总结,大神勿喷:需要转载请说明出处,如果有什么问题,欢迎留言 一.需求: 1.某一列 .某一行或某些单元格不可编辑,其他列可以编辑 二.期间遇到的问题 1.无法设置成不可编辑 2.设置为不可编辑 ...
- 【JS】原生实现拖拽
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8 ...
- 1、Redis简介
一.NOSQL 1.什么是NOSQL? NoSQL(NoSQL = Not Only SQL ),意即"不仅仅是SQL". 指的是非关系型的数据库.NoSQL有时也称作Not On ...
- TCP链接请求的10种状态
一.状态显示 SYN_SENT:这个状态与SYN_RCVD遥相呼应,当客户端SOCKET执行CONNECT连接时,它首先发送SYN报文,随即进入到了SYN_SENT状态,并等待服务端的发送三次握手中的 ...
- 测试工具_http_load
目录 一.简介 二.例子 三.参数 一.简介 http_load以并行复用的方式运行,用以测试Web服务器的吞吐量与负载.但是它不同于大多数压力测试工具,其可以以一个单一的进程运行,这样就不会把客户机 ...
- [ZJCTF 2019]Login
学了一段时间的堆溢出现在继续做题, 例行检查一下 64位的程序放入ida中 shift+f12查看程序函数 可以看到非常明显的后门程序 查看主函数 发现了程序给的账号和密码,但是没有看到明显的栈溢出漏 ...
- Indirect函数(Excel函数集团)
此处文章均为本妖原创,供下载.学习.探讨! 文章下载源是Office365国内版1Driver,如有链接问题请联系我. 请勿用于商业!谢谢 下载地址:https://officecommunity-m ...
- WSL docker打通容器间通信和追加端口映射
最近在docker中搭建一个服务,需要有多个容器通信.这里简单记录一下如何在容器间进行通信,同时说一下已经存在的容器如何追加端口映射. 增加网桥 容器间通信的目的是不适用IP而是使用容器名称进行网络通 ...
- AcWing3544. 寻找变化前的01序列
题目描述 给你一个 01 序列,HDLC 协议处理的话,如果出现连续的 5 个 1 会补 1 个 0. 例如 1111110,会变成 11111010. 现在给你一个经过 HDLC 处理后的 01 序 ...
- DKT模型及其TensorFlow实现(Deep knowledge tracing with Tensorflow)
今年2月15日,谷歌举办了首届TensorFlow Dev Summit,并且发布了TensorFlow 1.0 正式版. 3月18号,上海的谷歌开发者社区(GDG)组织了针对峰会的专场回顾活动.本文 ...