
scrapy学习笔记(一)
环境:Windows 7 x64 Python3.7.1 pycharm
一、安装scrapy
1.1linux系统使用:pip install scrapy
1.2Windows系统:
- pip install wheel
- 下载twisted http://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted (根据Python的版本进行下载,这里我的Python版本是3.7所以就下的3.7)
- pip install 路径\Twisted-19.2.1-cp37-cp37m-win_amd64
- pip install pywin32
- pip install scrapy
二、创建scrapy项目
1、新建一个项目,选择Python即可。我这里创建的项目名是demo。创建好后是一个空的项目。
2、点击pycharm下面的terminal,如下图所示:
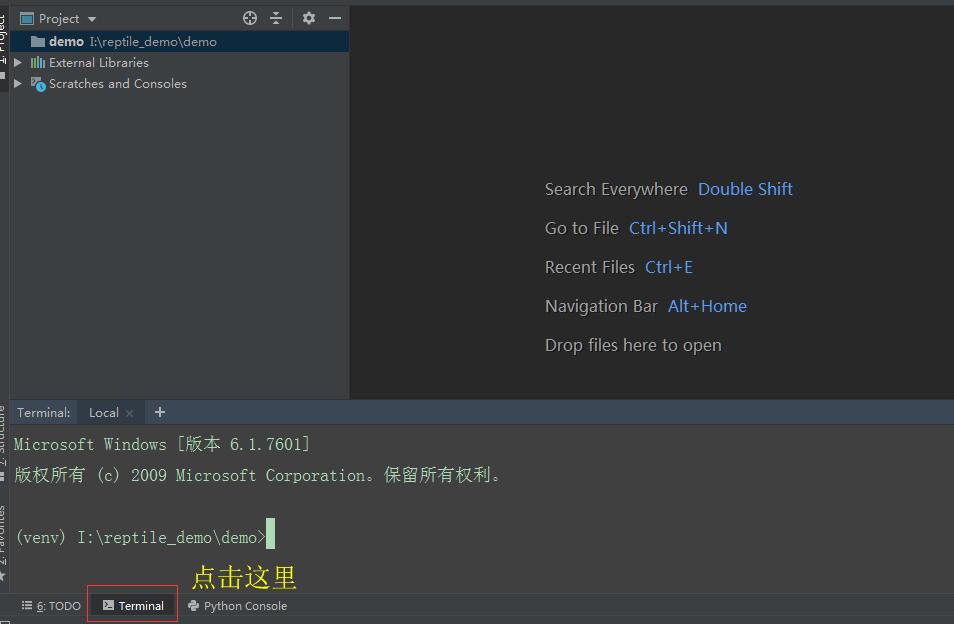
在终端中输入:scrapy startproject demo 命令,创建scrapy项目,创建成功后会出现如下目录结构:
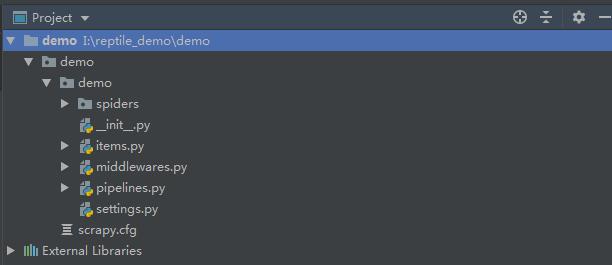
各文件作用大致如下:
- scrapy.cfg::项目的配置文件
- demo/:该项目的python模块。在此加入代码。
- demo/items.py:项目中的item文件主要用于定义数据的结构化存储,类似于ORM中的models。
- demo/pipelines.py:项目中的pipelines文件,指定数据的存储方式(以文件的形式存储,存储到数据库中)。
- demo/settings.py:项目的设置文件.
- demo/spiders/:放置spider代码的目录。我们写的爬虫代码在这个目录下。
3、创建爬虫文件
3.1在终端中输入:cd demo(我这里输入demo是因为我的项目名是demo)
3.2在终端中输入:scrapy genspider books books.toscrape.com (scrapy genspider 应用名称 爬取网页的起始url)
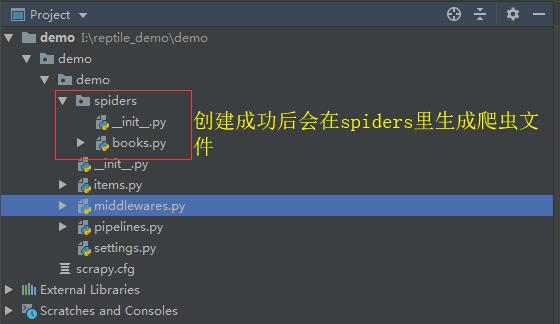
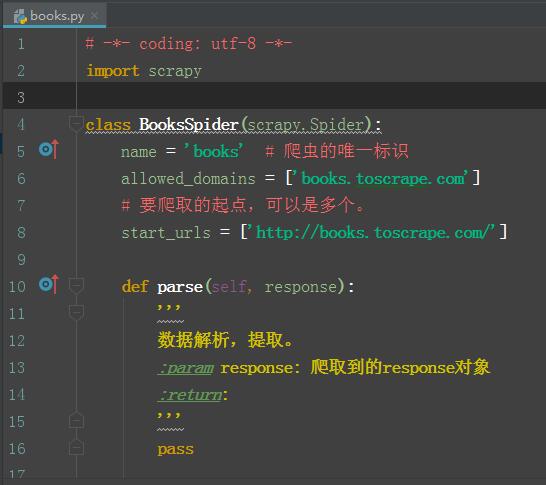
4、打开books文件,该文件结构如下:
5、爬取http://books.toscrape.com/的书籍信息。
5.1分析http://books.toscrape.com/页面。
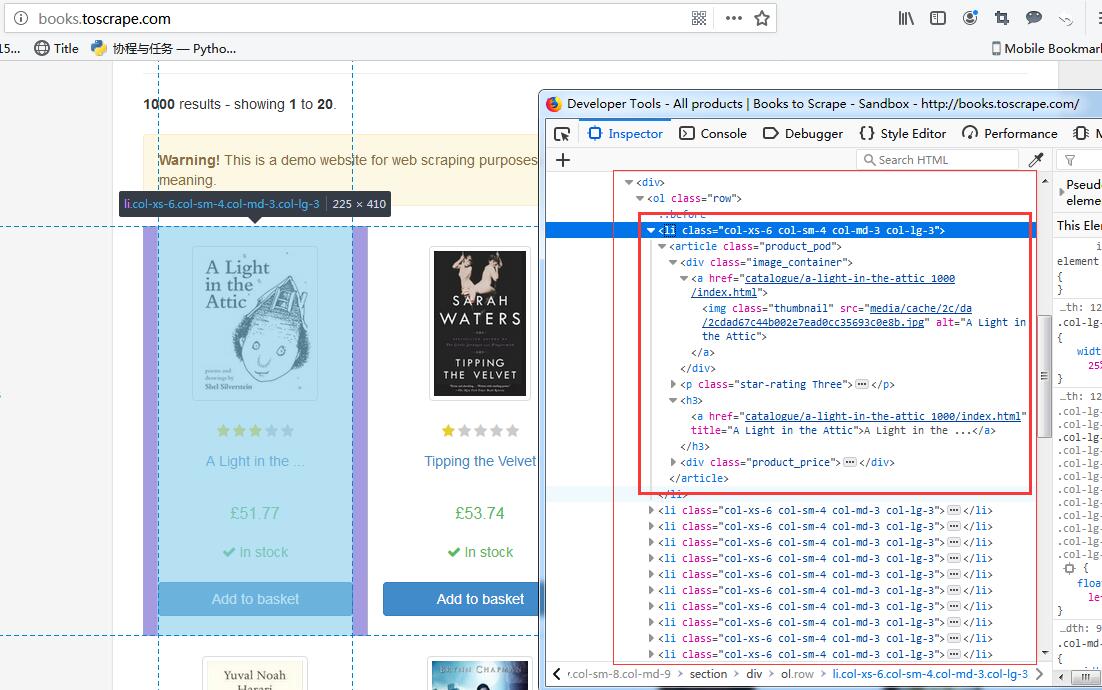
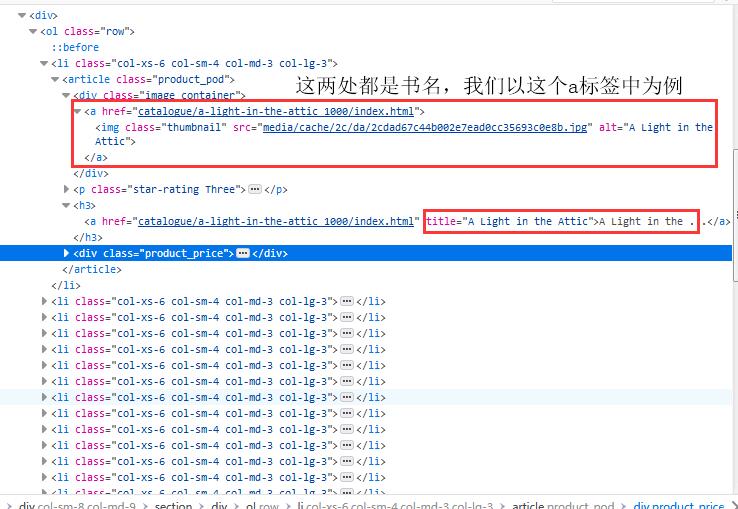
由上图我们可以知道所有书籍都存放在div/ol/下的li标签中。这里我们只打印书名,由此我们可以像下面这样写来提取数据。
5.2books中的部分代码如下:
def parse(self, response):

        '''

        数据解析,提取。

        :param response: 爬取到的response对象

        :return:

        '''

        book_list = response.xpath('/html/body/div/div/div/div/section/div[2]/ol/li')

        for book in book_list:

            print(book.xpath('./article/div[1]/a/img/@alt').extract())
5.3在setting.py中配置如下:
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:67.0) Gecko/20100101 Firefox/67.0'   # UA头

ROBOTSTXT_OBEY = False   # 如果为True表示准信robots协议,则大多数数据都爬不了。所以这里设置为Flase

LOG_LEVEL = 'ERROR'  # 日志等级
5.4在终端中执行爬取命令:scrapy crawl books
# 打印内容如下

['A Light in the Attic']

['Tipping the Velvet']

['Soumission']

['Sharp Objects']

['Sapiens: A Brief History of Humankind']

['The Requiem Red']

['The Dirty Little Secrets of Getting Your Dream Job']

['The Coming Woman: A Novel Based on the Life of the Infamous Feminist, Victoria Woodhull']

['The Boys in the Boat: Nine Americans and Their Epic Quest for Gold at the 1936 Berlin Olympics']

['The Black Maria']

['Starving Hearts (Triangular Trade Trilogy, #1)']

["Shakespeare's Sonnets"]

['Set Me Free']

["Scott Pilgrim's Precious Little Life (Scott Pilgrim #1)"]

['Rip it Up and Start Again']

['Our Band Could Be Your Life: Scenes from the American Indie Underground, 1981-1991']

['Olio']

['Mesaerion: The Best Science Fiction Stories 1800-1849']

['Libertarianism for Beginners']

["It's Only the Himalayas"]
由此我们可以看出这里只是爬取了1页,下面来爬取所有书籍名称。
6、爬取所有页面的书籍。

最终books.py的内容看起来像下面这样:
# -*- coding: utf-8 -*-

import scrapy

class BooksSpider(scrapy.Spider):

    name = 'books'  # 爬虫的唯一标识

    allowed_domains = ['books.toscrape.com']

    # 要爬取的起点,可以是多个。

    start_urls = ['http://books.toscrape.com/']

    url = 'http://books.toscrape.com/catalogue/page-%d.html'   # url模板用于拼接新的url

    page_num = 2

    def parse(self, response):

        '''

        数据解析,提取。

        :param response: 爬取到的response对象

        :return:

        '''

        print(f'当前页数{self.page_num}')  # 打印当前页数的数据

        book_list = response.xpath('/html/body/div/div/div/div/section/div[2]/ol/li')

        for book in book_list:

            print(book.xpath('./article/div[1]/a/img/@alt').extract())

        if self.page_num < 50:  # 总共50页的内容

            new_url = format(self.url % self.page_num)  # 拼接处新的URL

            self.page_num += 1  # 页数加1

            yield scrapy.Request(url=new_url, callback=self.parse)  # 手动发送请求
在终端中执行命令获取书名:scrapy crawl books
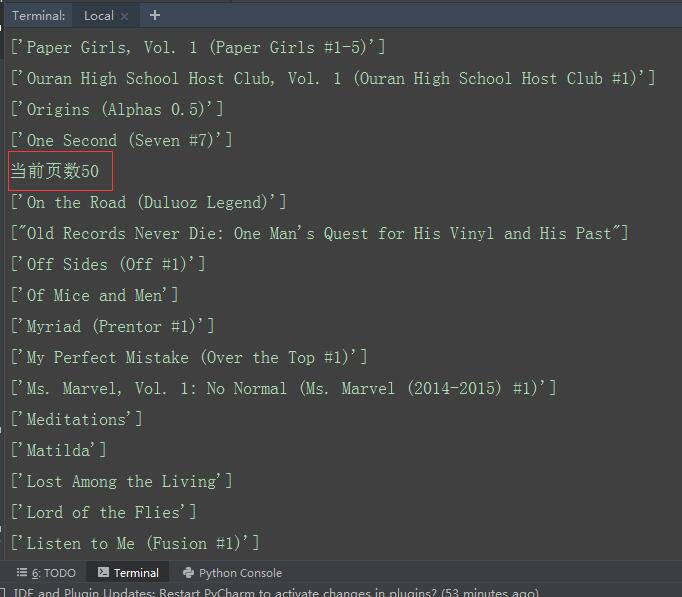
如果一切顺利你会看到打印的最终部分结果如下:
今日小结:
- 创建scrapy项目:scrapy startproject 爬虫项目名称。
- 创建爬虫应用:scrapy genspider books books.toscrape.com ((scrapy genspider 应用名称 爬取网页的起始url))应用名称在整个项目中作为唯一标识,不能出现同名的爬虫应用。
- 运行爬虫程序:scrapy crawl books(scrapy crawl 爬虫应用)。
- parse方法:当一个页面下载完成后,Scrapy引擎会回调一个我们指定的页面解析函数(默认为parse方法)解析页面。一个页面解析函数通常需要完成以下两个任务:
1、提取页面中的数据(使用XPath或CSS选择器)。
2、提取页面中的链接,并产生对链接页面的下载请求。
- 页面解析函数通常被实现成一个生成器函数,每一项从页面中提取的数据以及每一个对链接页面的下载请求都由yield语句提交给Scrapy引擎。
parse方法的工作机制(来源网络):
- 因为使用的yield,而不是return。parse函数将会被当做一个生成器使用。scrapy会逐一获取parse方法中生成的结果,并判断该结果是一个什么样的类型;
- 如果是request则加入爬取队列,如果是item类型则使用pipeline处理,其他类型则返回错误信息。
- scrapy取到第一部分的request不会立马就去发送这个request,只是把这个request放到队列里,然后接着从生成器里获取;
- 取尽第一部分的request,然后再获取第二部分的item,取到item了,就会放到对应的pipeline里处理;
- parse()方法作为回调函数(callback)赋值给了Request,指定parse()方法来处理这些请求 scrapy.Request(url, callback=self.parse)
- Request对象经过调度,执行生成 scrapy.http.response()的响应对象,并送回给parse()方法,直到调度器中没有Request(递归的思路)
- 取尽之后,parse()工作结束,引擎再根据队列和pipelines中的内容去执行相应的操作;
- 程序在取得各个页面的items前,会先处理完之前所有的request队列里的请求,然后再提取items。
- 这一切的一切,Scrapy引擎和调度器将负责到底。
scrapy学习笔记(一)的更多相关文章
- Scrapy:学习笔记(2)——Scrapy项目
Scrapy:学习笔记(2)——Scrapy项目 1.创建项目 创建一个Scrapy项目,并将其命名为“demo” scrapy startproject demo cd demo 稍等片刻后,Scr ...
- Scrapy:学习笔记(1)——XPath
Scrapy:学习笔记(1)——XPath 1.快速开始 XPath是一种可以快速在HTML文档中选择并抽取元素.属性和文本的方法. 在Chrome,打开开发者工具,可以使用$x工具函数来使用XPat ...
- scrapy 学习笔记1
最近一段时间开始研究爬虫,后续陆续更新学习笔记 爬虫,说白了就是获取一个网页的html页面,然后从里面获取你想要的东西,复杂一点的还有: 反爬技术(人家网页不让你爬,爬虫对服务器负载很大) 爬虫框架( ...
- scrapy学习笔记(1)
初探scrapy,发现很多入门教程对应的网址都失效或者改变布局了,走了很多弯路.于是自己摸索做一个笔记. 环境是win10 python3.6(anaconda). 安装 pip install sc ...
- Scrapy学习笔记(5)-CrawlSpider+sqlalchemy实战
基础知识 class scrapy.spiders.CrawlSpider 这是抓取一般网页最常用的类,除了从Spider继承过来的属性外,其提供了一个新的属性rules,它提供了一种简单的机制,能够 ...
- scrapy 学习笔记2
本章学习爬虫的 回调和跟踪链接 使用参数 回调和跟踪链接 上一篇的另一个爬虫,这次是为了抓取作者信息 # -*- coding: utf-8 -*- import scrapy class Myspi ...
- scrapy学习笔记一
以前写爬虫都是直接手写获取response然后用正则匹配,被大佬鄙视之后现在决定开始学习scrapy 一.安装 pip install scrapy 二.创建项目 scrapy startprojec ...
- Scrapy 学习笔记(一)数据提取
Scrapy 中常用的数据提取方式有三种:Css 选择器.XPath.正则表达式. Css 选择器 Web 中的 Css 选择器,本来是用于实现在特定 DOM 元素上应用花括号内的样式这样一个功能的. ...
- scrapy 学习笔记
1.scrapy 配合 selenium.phantomJS 抓取动态页面, 单纯的selemium 加 Firefox浏览器就可以抓取动态页面了, 但开启窗口太耗资源,而且一般服务器的linux 没 ...
- scrapy学习笔记
1.scrapy用哪条命令行重新编辑已有的项目?cd projectname 2.如何在pycharm中开启scrapy?先在终端创建一个项目(即文件夹),再在pycharm中打开.
随机推荐
- AwaitAsync(异步和多线程)
参考了一些大佬写的文章: https://www.cnblogs.com/yilezhu/p/10555849.html这个大佬写的文章,我还是很喜欢的 https://www.cnblogs.com ...
- Dynamics 365 CE将自定义工作流活动程序集注册到磁盘并引用其他类库
我是微软Dynamics 365 & Power Platform方面的工程师罗勇,也是2015年7月到2018年6月连续三年Dynamics CRM/Business Solutions方面 ...
- DevOps 工程师成长日记系列五:部署
原文地址:https://medium.com/@devfire/how-to-become-a-devops-engineer-in-six-months-or-less-part-5-deploy ...
- python从入门到放弃之线程篇
一,什么是多线程? 1.多线程的概念? 说起多线程,那么就不得不说什么是线程,而说起线程,又不得不说什么是进程. 进程(Process)是计算机中的程序关于某数据集合上的一次运行活动,是系统进行资源分 ...
- 导入部署 hand
差价导入部署步骤如下: 执行视图,包. 定义消息,验证的时候使用(XXC1003DFM_BI_001 到 XXC1003DFM_BI_007,含中英文). 通用导入设置: 电子表元数据管理,含导入正确 ...
- 元祖,range,字典,结构,fromkeys的使用
3.5.3 元祖 关键字 tuple tu=(1,2,3,'你好',True) print(tu) 元祖是有序,不可变数据,不能进行修改, 支持索引查看 存储一些比较重要的信息,在配置文件中使用 存放 ...
- TCP/IP协议的分层
T C P / I P协议族是一组不同的协议组合在一起构成的协议族.尽管通常称该协议族为 T C P / I P,但T C P和I P只是其中的两种协议而已(该协议族的另一个名字是 I n t e r ...
- GIL全局解释器锁、死锁、递归锁、线程队列
目录 GIL全局解释锁 多线程的作用 测试计算密集型 IO密集型 死锁现象 递归锁 信号量(了解) 线程队列 GIL全局解释锁 GIL本质上是一个互斥锁. GIL是为了阻止同一个进程内多个进程同时执行 ...
- [日常] 免费的文本比较工具Meld使用
需要在linux桌面环境进行文件比较的时候,发现的一款文本比较工具,并且还有windows版本.之前一直在windows下使用的是beyond compare这个的破解版,这个软件本身是收费的而且还非 ...
- 第十七章 Metasploit Framework
渗透测试者的困扰▪ 需要掌握数百个工具软件,上千个命令参数,实在记不住▪ 新出现的漏洞PoC/EXP有不同的运行环境要求,准备工作繁琐▪ 大部分时间都在学习使用不同工具的使用习惯,如果能统一就好了▪ ...