
php 爬虫采集
概述
现在爬虫技术算是一个普遍的技术了,各个语言的爬虫百家争鸣,但是根据笔者自己的感觉还是python是主流。爬虫涉及到太多的东西,笔者并不是专业的爬虫工程师,只不过个人兴趣分享一下。由于笔者是php工作,所以就使用php来进行简单爬虫。不过我的方法应该是很通用的,我相信java,C#等肯定有类似的函数,然后做法其实都一样了。
技术准备
看懂这段代码你需要对php的正则表达式函数以及正则表达式有一定的理解。
代码 注意实际代码就这么多
<?php
//这个是你网页正则匹配出来的字符串
$str = '<div class="title">
<h3><span>[小组] </span> <a href="链接内容1" target="_blank">标签内容1</a></h3>
<div class="info">
237059 成员
</div>
</div>
<div class="title">
<h3><span>[小组] </span> <a href="链接内容2" target="_blank">标签内容2</a></h3>
<div class="info">
237059 成员
</div>
</div>';
//这个是正则的输出结果
preg_match_all('/<div class="title">[\s\S]*?<h3>[\s\S]*?<a href="(.*?)"[\s\S]*?>(.*?)<\/a>/',$str,$match);
print_r($match);//根据打印的结果很明白了吧
//这个方法就是抓取网页内容的方法了可以吧需要抓取的页面传进去,然后正则匹配内容哦
function getUrlContent($url){//通过url获取html内容
$ch = curl_init();
curl_setopt($ch,CURLOPT_URL,$url);
curl_setopt($ch,CURLOPT_USERAGENT,"Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 6.1 )");
curl_setopt($ch,CURLOPT_HEADER,1);
curl_setopt($ch,CURLOPT_RETURNTRANSFER,1);
$output = curl_exec($ch);
curl_close($ch);
return $output;
}
?>
到这里就可以匹配你想要的数据了,如果还是不懂,就继续往下瞅瞅
流程图
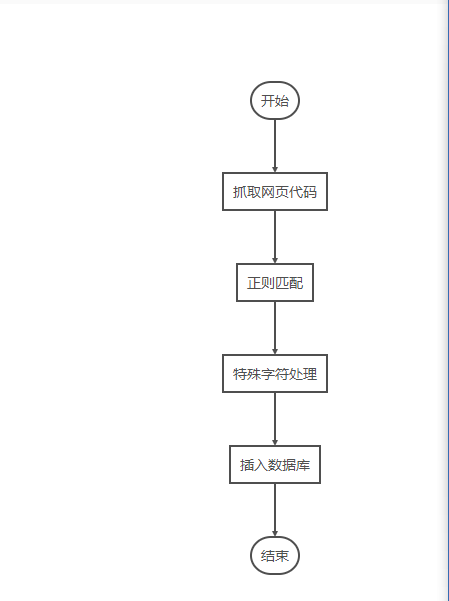
简单的爬虫,特殊字符处理就不进行了,保证插入数据库不出错就行了
思路
首先getUrlContent($url)函数,只需要穿一个url地址就行了,当然了因为各个网站都有反扒机制,不过笔者的这个函数并不是万能的,但是在豆瓣测试过,其他网站大家自行测试了。
任何网站都可以理解为一个很长的字符串,如果对html有研究无非就是:
<html>
<head>XXX</head>
<body>XXX</body>
</html>
我们需要的只是将body标签里的东西拿出来,笔者模拟了一段body里的代码
<html>
<head>XXX</head>
<body>
<div class="title">
<h3><span>[小组] </span> <a href="链接内容1" target="_blank">标签内容1</a></h3>
<div class="info">
237059 成员
</div>
</div>
<div class="title">
<h3><span>[小组] </span> <a href="链接内容2" target="_blank">标签内容2</a></h3>
<div class="info">
237059 成员
</div>
</div>
</body>
</html>
对于这段代码,可以理解为一个很长的字符串
$str = '<html>
<head>XXX</head>
<body>
<div class="title">
<h3><span>[小组] </span> <a href="链接内容1" target="_blank">标签内容1</a></h3>
<div class="info">
237059 成员
</div>
</div>
<div class="title">
<h3><span>[小组] </span> <a href="链接内容2" target="_blank">标签内容2</a></h3>
<div class="info">
237059 成员
</div>
</div>
</body>
</html>';
对这段字符串,只需要进行正则匹配拿出你想要的,假如需要a标签里的href与内容
preg_match_all('/<div class="title">[\s\S]*?<h3>[\s\S]*?<a href="(.*?)"[\s\S]*?>(.*?)<\/a>/',
$str,$match);
然后如果你不认识这段正则表达式还有preg_match_all函数,这里笔者就简单说下了,[\s\S]*?代表懒惰匹配任意字符,因为标签之间会用空格符换行符,这里又出现新问题什么叫懒惰匹配,简单来说就是匹配最少的内容。(.*?)代表非空字符,加括号的原因简单来说就是括号里的内容是你想要的,前面的[\s\S]*?匹配到的是一堆特殊符号,并没有什么作用,你不用把特殊符号记录下来,所以不加括号。
最后打印结果,也就是$match数组。
Array
(
[0] => Array
(
[0] => <div class="title">
<h3><span>[小组] </span> <a href="链接内容1" target="_blank">标签内容1</a>
[1] => <div class="title">
<h3><span>[小组] </span> <a href="链接内容2" target="_blank">标签内容2</a>
)
[1] => Array
(
[0] => 链接内容1
[1] => 链接内容2
)
[2] => Array
(
[0] => 标签内容1
[1] => 标签内容2
)
)
根据这个数组,需要什么自己遍历数组,然后拼装sql语句,插入到自己的数据库中即可。但是插入过程中可能会有一些单引号双引号捣乱,所以你用str_replace()把他们替换掉,或者加转义符号。
总结
只是针对php进行的简单爬虫,不过爬虫的思路我相信很多种语言都用得到。不过很多网站的内容是通过js返回的,或者需要登陆才能获取到数据,这些比较高级的部分,有兴趣的推荐自学python爬虫。
本文转载自https://blog.csdn.net/qq_35370923/article/details/82901220
php 爬虫采集的更多相关文章
- python爬虫采集
python爬虫采集 最近有个项目需要采集一些网站网页,以前都是用php来做,但现在十分流行用python做采集,研究了一些做一下记录. 采集数据的根本是要获取一个网页的内容,再根据内容筛选出需要的数 ...
- 利用Python网络爬虫采集天气网的实时信息—BeautifulSoup选择器
相信小伙伴们都知道今冬以来范围最广.持续时间最长.影响最重的一场低温雨雪冰冻天气过程正在进行中.预计,今天安徽.江苏.浙江.湖北.湖南等地有暴雪,局地大暴雪,新增积雪深度4-8厘米,局地可达10-20 ...
- 基于Python爬虫采集天气网实时信息
相信小伙伴们都知道今冬以来范围最广.持续时间最长.影响最重的一场低温雨雪冰冻天气过程正在进行中.预计,今天安徽.江苏.浙江.湖北.湖南等地有暴雪,局地大暴雪,新增积雪深度4-8厘米,局地可达10- ...
- 抖音爬虫教程,python爬虫采集反爬策略
一.爬虫与反爬简介 爬虫就是我们利用某种程序代替人工批量读取.获取网站上的资料信息.而反爬则是跟爬虫的对立面,是竭尽全力阻止非人为的采集网站信息,二者相生相克,水火不容,到目前为止大部分的网站都还是可 ...
- 去除爬虫采集到的\xa0、\u3000等字符
\xa0表示不间断空白符,爬虫中遇到它的概率不可谓不小,而经常和它一同出现的还有\u3000.\u2800.\t等Unicode字符串.单从对\xa0.\t.\u3000等含空白字符的处理来说,有以下 ...
- python爬虫采集网站数据
1.准备工作: 1.1安装requests: cmd >> pip install requests 1.2 安装lxml: cmd >> pip install lxml ...
- python爬虫-采集英语翻译
http://fanyi.baidu.com/?aldtype=85#en/zh/drughttp://fanyi.baidu.com/?aldtype=85#en/zh/cathttp://fa ...
- 编写python爬虫采集彩票网站数据,将数据写入mongodb数据库
1.准备工作: 1.1安装requests: cmd >> pip install requests 1.2 安装lxml: cmd >> pip install lxml ...
- Python爬虫——城市公交、地铁站点和线路数据采集
本篇博文为博主原创,转载请注明. 城市公交.地铁数据反映了城市的公共交通,研究该数据可以挖掘城市的交通结构.路网规划.公交选址等.但是,这类数据往往掌握在特定部门中,很难获取.互联网地图上有大量的信息 ...
随机推荐
- 利用VS Code在Azure上构建部署静态页面
0x00 前言 前一段时间,我找到了Jendrik Illner的个人网站.除了那里的精彩文章,网站的主题也吸引了我的注意力,而且我发现该网站的主题采用了Hugo的Academic主题. 然后,我认为 ...
- SharePoint PowerShell SendEmail
前言 最近碰到这样一个需求,用户需要个简单的定时邮件提醒,就是抓取SharePoint某个列表里的值,然后作为邮件地址/邮件主题/邮件内容发送出去. 自己想了想,既然用户要求每天定时发送,那么肯定是任 ...
- luogu2173 [ZJOI2012]网络
题目链接 problem 给出一个无向图,每条边有一种颜色.每种颜色都构成一个森林.需要完成以下操作. 修改点权 修改边的颜色 询问某种颜色的森林中某条路径上点权最大值 solution 颜色数量不超 ...
- Windows10官方原版系统下载安装制作方法
Windows10官方原版系统下载安装制作方法 去官网下载系统安装程序 点进去 https://www.microsoft.com/zh-cn/software-download/windows10 ...
- PHP0019:PHP 图像验证码 、图像水印效果 、 生成缩约图
- Java多线程之互斥锁Syncharnized
public class Bank { private int money; private String name; public Bank(String name, int money) { th ...
- css权值和优先级+命名规范
选择器权值: 标签选择器:1 类选择器和伪类选择器:10 ID选择器:100 通配符选择器:0 行内样式:1000 !important 在一定条件下,优先级最高 常用的css样式命名 页面结构页头: ...
- Spring boot2.0学习笔记(一)
学习环境: jdk1.8 (Spring Boot 推荐jdk1.8及以上): java version "1.8.0_241" Maven 3.x (maven 3.2 以上版本 ...
- 剑指offer-面试题4-二维数组中的查找-数组
/* 题目: 在一个二维数组中,每一行都按照从左到右递增的顺序排序,每一列都按照从上到下递增的顺序排序. 请完成一个函数,输入这样的一个二维数组和一个整数,判断数组中是否含有该整数. */ /* 解题 ...
- 【终端使用】echo、">"覆盖、">>"追加、"|"管道
1."echo"文字内容 "echo"命令,会在终端中显示参数指定的文字,通常会和 重定向 联合使用. 2.重定向 ">"和" ...