
热词统计以及Quartz.net的简单使用
一.热词统计
方案一:
设计一个表:ID KeyWord Count
当用户再输入框中查询的时候,我们就往表中插入数据,在插入之前首先判断是否已经存在keyword,存在的话,让Count+1
这种方案非常费时
方案二:
表 :ID Keyword Count
每次用户输入的时候直接插入,不需要判断是否存在,当进行热词展示的时候,通过Group By语句进行统计
同样比较费时
方案三:
表一明细表:ID Keyword
表二汇总表:ID KeyWord Count
用户每次输入并进行查询的时候,将数据插入到明细表中,然后使用定时任务,当用户量访问量比较小的时候,执行汇总操作,将数据插入到汇总表中。
这种实用性比较高
方案四:
对于用户访问量比较大的数据,采用关系型数据库,速度还是太慢。可以使用NoSql数据库,可以有效的解决高并发。
二.Quartz.net(计划任务组件)的简单使用
1.主要的dll文件
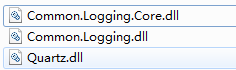
2.Quartz.net的使用有两种方式,1.采用配置文件的方式配置参数 2.直接在程序中使用代码设置参数,此处直接使用官方的demo中的例子,并适当的修改
  static void Main(string[] args)

        {

            ISchedulerFactory sf = new StdSchedulerFactory();

            IScheduler sched = sf.GetScheduler();

            //代码添加job和trigger

            DateTimeOffset startTime = DateBuilder.NextGivenSecondDate(null, );

            IJobDetail job = JobBuilder.Create<KeywordJob>()

                .WithIdentity("job1", "group1")

                .Build();

            // Trigger the job to run on the next round minute

            ITrigger trigger = TriggerBuilder.Create()

                .WithIdentity("trigger1", "group1")

                .StartAt(startTime).WithSimpleSchedule(x => x.WithIntervalInSeconds().RepeatForever())

                .Build();

            sched.ScheduleJob(job, trigger);

            sched.Start();

            Console.ReadLine();

        }
3.Quartz.net中主要包括三个主要的对象:计划者(IScheduler)、工作任务(IJob)和触发器(ITrgger),我们可以在工作任务中添加我们需要定时执行的工作。
 public    class KeywordJob:IJob

    {

        public OA.IBLL.IKeywordCountService keywordService = new OA.BLL.KeywordCountService();

        public void Execute(IJobExecutionContext context)

        {

            keywordService.DeleteAll();

            keywordService.InsertAll();

        }

    }
热词统计以及Quartz.net的简单使用的更多相关文章
- Lucene热词统计
1.建立搜索表 ID KeyWords DT 搜索一次保存一次,id才用guid提高效率 /// <summary> /// 搜索数据 /// </summary> /// & ...
- 通过elasticsearch对日志进行搜索热词统计
通过logstash搜集日志 这里搜集日志可以使用ELK的一个插件filebeat对日志进行处理,并传输到后端的程序 在这里有一个不好的地方, 如果想要直接使用filebeat将日志发送到elasti ...
- JFreeChart与AJAX+JSON+ECharts两种处理方式生成热词统计可视化图表
本篇的思想:对HDFS获取的数据进行两种不同的可视化图表处理方式.第一种JFreeChar可视化处理生成图片文件查看.第二种AJAX+JSON+ECharts实现可视化图表,并呈现于浏览器上. 对 ...
- Python 爬取 热词并进行分类数据分析-[简单准备] (2020年寒假小目标05)
日期:2020.01.27 博客期:135 星期一 [本博客的代码如若要使用,请在下方评论区留言,之后再用(就是跟我说一声)] 所有相关跳转: a.[简单准备](本期博客) b.[云图制作+数据导入] ...
- 阿里舆情︱舆情热词分析架构简述(Demo学习)
本节来源于阿里云栖社区,同时正在开发一个舆情平台,其中他们发布了一篇他们所做的分析流程,感觉可以作为案例来学习.文章来源:觉民cloud/云栖社区 平台试用链接:https://prophet.dat ...
- Python 爬取 热词并进行分类数据分析-[云图制作+数据导入]
日期:2020.01.28 博客期:136 星期二 [本博客的代码如若要使用,请在下方评论区留言,之后再用(就是跟我说一声)] 所有相关跳转: a.[简单准备] b.[云图制作+数据导入](本期博客) ...
- Python 爬取 热词并进行分类数据分析-[数据修复]
日期:2020.02.01 博客期:140 星期六 [本博客的代码如若要使用,请在下方评论区留言,之后再用(就是跟我说一声)] 所有相关跳转: a.[简单准备] b.[云图制作+数据导入] c.[拓扑 ...
- Python 爬取 热词并进行分类数据分析-[解释修复+热词引用]
日期:2020.02.02 博客期:141 星期日 [本博客的代码如若要使用,请在下方评论区留言,之后再用(就是跟我说一声)] 所有相关跳转: a.[简单准备] b.[云图制作+数据导入] c.[拓扑 ...
- 一种O(n)时间复杂度的计数排序算法和Top N热词算法
排序算法是研究非常广泛且超级经典的算法,主流排序算法的时间复杂度基本都在O(nlogn). 今天就介绍一种以hash表为基础的,时间复杂度能够达到O(n)的排序算法--计数排序: 同时基于它的思想,完 ...
随机推荐
- selenium测试(Java)--学习总结
- Spring IO platform 简介
前提:熟悉Spring基础知识. 简介:Spring IO Platform将 the core Spring APIs 集成到一个Platform中.它提供了Spring portfolio中的大量 ...
- 无法从“重载函数类型”为“const std::_Tree<_Traits> &”推导 <未知> 参数
场景: 原因: 用到string类型,但是没有包含头文件. 解决方法: #include<string>
- 64位程序,long*转long 出错
原因: long*在64位程序中占8个字节,long占4个字节.强转会出错. 解决方法: 把long用long long替换,long long 占8个字节
- notepadd添加插件
markdown相关插件: https://www.cnblogs.com/tocy/p/npp-support-markdonw-extension.html
- Python学习笔记(一)——基本知识点
主要记录学习Python的历程和用于复习.查阅之用. 知识点: 数据类型(列表.元组.字典.集合) 帮助文档 函数(默认参数.可变参数.关键字参数.参数组合) 数据类型: 列表:list ...
- eclipse (ADT) svn插件 过滤上传的 文件 文件夹 一劳永逸
其实很简单哈,过滤的有三种类型,1.文件.2.文件夹.3.android的target 在ADT中 window->preferences-> 会打开如下界面 ignore就是忽视的意思 ...
- python--dict和set类型--4
原创博文,转载请标明出处--周学伟http://www.cnblogs.com/zxouxuewei/ 一.什么是dict 我们已经知道,list 和 tuple 可以用来表示顺序集合,例如,班里同学 ...
- org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'UserDao' def
org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'UserDao' def ...
- ch6-定制数据对象(打包代码和数据)
为了看出数据属于哪个选手,教练向各个选手的数据文件中添加了标识数据:选手全名,出生日期,计时数据. 例如:sarah文件的数据更新为: Sarah Sweeney,2002-6-17,2:58,2.5 ...