
Windows核心编程笔记之处理字符串
0x01 ANSI 和宽字符定义
	// ANSI 字符定义

	CHAR varChar_1 = 'a';					// #typedef char CHAR

	CHAR varChar_2[] = "ABCDEFG";

	CHAR varChar_3[20] = "ABCDEFG";

	// 宽字符定义

	WCHAR varWChar_1 = L'a';				// #typedef wchar_t WCHAR

	WCHAR varWChar_2[] = L"ABCDEFG";

	WCHAR varWChar_3[20] = L"ABCDEFG";
0x02 字符串处理函数
- 不安全的字符串处理函数
	CHAR buffer[10] = { 0 };                    // 初始化字符串

	CHAR overflow[] = "AAAAAAAAAAAAAAAAAAAA";	// 造成溢出的数据

	int BufferSize = 20;						// 控制溢出的整数

	memset(buffer, 0x41, BufferSize);		// BufferSize 过大导致栈溢出

	strcpy(buffer, overflow);				// overflow 过大导致栈溢出

	strcat(buffer, overflow);				// overflow + buffer 的长度过大导致栈溢出
- 安全的字符串处理函数
	CHAR buffer[10] = { 0 };        // 初始化字符串

	CHAR overflow[] = "AAAAAAAAAAAAAAAAAAAAAA";		// 造成溢出的数据

	errno_t res = NULL;

	// strcpy_s

	res = strcpy_s(buffer, overflow);		// 只有两个参数,那么会自动检测 overflow 的大小是否超过 buffer

	res = strcpy_s(buffer, 5, overflow);	// 限制复制的大小为 5 个字节

	// strcat_s

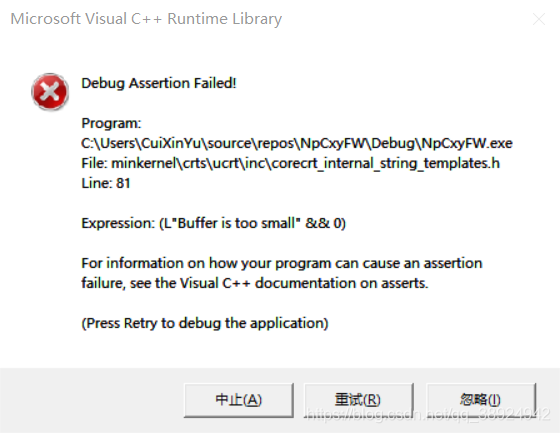
	res = strcat_s(buffer, overflow);		// 由于 overflow 大于 buffer,所以引发异常
异常如下
0x03 其他安全的字符串处理函数
- StringCchCat(Ex),安全的拼接字符串
- https://docs.microsoft.com/en-us/previous-versions/windows/embedded/ms860411(v=msdn.10)
	WCHAR Buffer[10] = L"AAAAAA";

	WCHAR LinkBuffer[] = L"A";

	STRSAFE_LPWSTR *DestEnd = NULL; // #typedef wchar_t *STRSAFE_LPWSTR

	size_t size = NULL;

	// 安全的字符串拼接函数 StringCchCat

	HRESULT res;

	res = StringCchCat((STRSAFE_LPWSTR)Buffer, lstrlen(Buffer) + lstrlen(LinkBuffer) + 1, (STRSAFE_LPWSTR)LinkBuffer);

	res = StringCchCatEx(

		(STRSAFE_LPWSTR)Buffer,							// 目标缓冲区

		lstrlen(Buffer) + lstrlen(LinkBuffer) + 1,		// 目标缓冲区大小,务必等于 Buffer + LinkBuffer + 1 的大小,1 为终止符

		(STRSAFE_LPWSTR)LinkBuffer,						// 源缓冲区,用于拼接至 Buffer 后

		DestEnd,										// Buffer 结尾的指针

		&size,											// 未使用的字符

		STRSAFE_NO_TRUNCATION | STRSAFE_FILL_BEHIND_NULL  // 如果函数成功,则使用dwFlags(0)的低字节来填充终止空字符后的pszDest的未初

														  // 如果函数失败,则pszDest不受影响。原始内容中没有添加任何内容

	);

	//	cout << "DestEnd: " << DestEnd << endl;

	//	cout << "size: " << size << endl;
- StringCchCopy(Ex),安全的拷贝字符串
- https://docs.microsoft.com/en-us/previous-versions/windows/embedded/ms860420(v=msdn.10)
	WCHAR DestBuffer[10] = { 0 };

	WCHAR SrcBuffer[] = L"AAAAAAAAA";

	STRSAFE_LPWSTR *DestEnd = NULL;

	size_t size = NULL;

	HRESULT res;

	res = StringCchCopy((STRSAFE_LPWSTR)DestBuffer, lstrlen(SrcBuffer) + 1, SrcBuffer);

	res = StringCchCopyEx(

		(STRSAFE_LPWSTR)DestBuffer, // 目标缓冲区

		lstrlen(SrcBuffer) + 1,		// 目标缓冲区大小,务必等于 Buffer + LinkBuffer + 1 的大小,1 为终止符

		SrcBuffer,					// 源字符串地址

		DestEnd,					// 源字符串结尾指正

		&size,						// 目标缓冲区未使用的字节

		STRSAFE_NO_TRUNCATION | STRSAFE_FILL_BEHIND_NULL);  // 如果函数成功,则使用dwFlags(0)的低字节来填充终止空字符后的pszDest的未初始化部分

															// 与STRSAFE_NULL_ON_FAILURE的情况一样,如果函数失败,则pszDest设置为空字符串(TEXT(""))

	/*

		cout << "DestEnd: " << DestEnd << endl;

		cout << "size: " << size << endl;

	*/
- StringCchPrintf(Ex),安全的格式化字符串
- https://docs.microsoft.com/en-us/previous-versions/windows/embedded/ms860435(v=msdn.10)
	WCHAR DestBuffer[10] = { 0 };

	HRESULT res;

	res = StringCchPrintf((STRSAFE_LPWSTR)DestBuffer, sizeof(DestBuffer) / 2, TEXT("%d + %d = %d"), 1, 2, 3);

	STRSAFE_LPWSTR *DestEnd = NULL;

	size_t size;

	res = StringCchPrintfEx(

		(STRSAFE_LPWSTR)DestBuffer,		// 目标缓冲区

		sizeof(DestBuffer) / 2,			// 目标缓冲区大小

		DestEnd,						// 目标缓冲区结尾指针

		&size,							// 目标缓冲区未使用的字符数

		STRSAFE_NO_TRUNCATION | STRSAFE_FILL_BEHIND_NULL,	// 如果函数成功,则使用dwFlags(0)的低字节来填充终止空字符后的pszDest的未初始化部分

															// 与STRSAFE_NULL_ON_FAILURE的情况一样,如果函数失败,则pszDest设置为空字符串(TEXT(""))

		TEXT("%d + %d = %d"), 1, 2, 3						// 格式化字符

	);

	if (res == S_OK)

	{

		cout << "有足够的空间可以将结果复制到pszDest而不进行截断,并且缓冲区以空值终止" << endl;

	}

	else if (res == STRSAFE_E_INSUFFICIENT_BUFFER)

	{

		cout << "cchDest 是 0 或比 STRSAFE_MAX_CCH 更大,或目标缓冲区是满的" << endl;

	}

	else if (res == STRSAFE_E_INVALID_PARAMETER)

	{

		cout << "由于缓冲区空间不足,复制操作失败" << endl;

	}
- StrFormatKBSize(StrFormatByteSize),数值大小转换成字符串
https://docs.microsoft.com/zh-cn/windows/desktop/api/shlwapi/nf-shlwapi-strformatkbsizea
#include <Windows.h>

#include <iostream>

#include <String.h>

#include <shlwapi.h>

#pragma comment (lib, "Shlwapi.lib")

using namespace std;

int main(int argc, char *argv[])

{

	LONGLONG var_1 = 521;

	WCHAR Buffer[10] = { 0 };	// Buffer 初始化

	// StrFormatKBSize 将数值转换为字符串,该字符串表示以千字节为单位表示的大小值

	PTSTR res = StrFormatKBSize(

		var_1,					// 需要转换的数值

		(PWSTR)Buffer,			// 指向缓冲区的指针

		sizeof(Buffer) / 2	// pszBuf的大小,以字符为单位

	);

	if (res == NULL)

	{

		cout << "调用失败" << endl;

	}

	else

	{

		cout << "字符串的地址: " << res << endl;

	}

	return 0;

}
- CompareString(一般比较字符串)+ CompareStringOrdinal(为了比较编程类的字符串)
- https://docs.microsoft.com/zh-cn/windows/desktop/api/stringapiset/nf-stringapiset-comparestringex
- https://docs.microsoft.com/zh-cn/windows/desktop/api/stringapiset/nf-stringapiset-comparestringordinal
	WCHAR String1[] = L"ABCDEFG"; // 定义两个相等的字符串

	WCHAR String2[] = L"AbCdEfG";

	int res = CompareStringEx(

		LOCALE_NAME_SYSTEM_DEFAULT,					// 设置为当前操作系统区域设置的名称

		NORM_IGNORECASE | NORM_IGNORESYMBOLS,		// 忽略大小写 | 忽略符号和标点符号

		(LPCWCH)&String1,							// 用于比较的字符串 1

		sizeof(String1) / 2,						// 用于比较的字符串 1 的大小

		(LPCWCH)&String2,							// 用于比较的字符串 2

		sizeof(String2) / 2,						// 用于比较的字符串 2 的大小

		NULL,										// 保留位,必须设置为 NULL

		NULL,										// 同上

		0											// 同上

	);

	if (res != 0) // CompareStringEx 调用失败返回则 0

	{

		switch (res)

		{

		case CSTR_LESS_THAN:

			cout << "lpString1指示的字符串的词汇值小于lpString2指示的字符串" << endl; break;

		case CSTR_EQUAL:

			cout << "由lpString1指示的字符串在词汇值中等效于由lpString2指示的字符串" << endl; break;

		case CSTR_GREATER_THAN:

			cout << "lpString1指示的字符串的词汇值大于lpString2指示的字符串" << endl; break;

		}

	}

	else

	{

		DWORD error = GetLastError();

		if (error == ERROR_INVALID_FLAGS)

		{

			cout << "为标志提供的值无效: " << endl;

		}

		else if(error == ERROR_INVALID_PARAMETER)

		{

			cout << "任何参数值都无效: " << endl;

		}

	}
WCHAR String1[] = L"ABCDEFG";

	WCHAR String2[] = L"AbCdEfG";

	int res = CompareStringOrdinal((LPCWCH)String1, sizeof(String1) / 2, (LPCWCH)String2, sizeof(String2) / 2, TRUE);// TRUE 为不区分大小写的比较

	if (res != 0)

	{

		switch (res)

		{

		case CSTR_LESS_THAN:

			cout << "lpString1指示的值小于lpString2指示的值" << endl; break;

		case CSTR_EQUAL:

			cout << "lpString1指示的值等于lpString2指示的值" << endl; break;

		case CSTR_GREATER_THAN:

			cout << "lpString1指示的值大于lpString2指示的值" << endl; break;

		}

	}

	else

	{

		DWORD res = GetLastError();

		if (res == ERROR_INVALID_PARAMETER)

		{

			cout << "任何参数值都无效" << endl;

		}

	}
- MultiByteToWideChar(用于将 ANSI 字符转换成宽字节字符),WideCharToMultiByte函(将宽字节字符转换成 ANSI 字符)
- https://docs.microsoft.com/en-us/previous-versions/bb202786(v=msdn.10)
- https://docs.microsoft.com/zh-cn/windows/desktop/api/stringapiset/nf-stringapiset-widechartomultibyte
	CHAR BeforeConversion[] = "ABCDEFG";

	WCHAR AfterConversion[10] = { 0 };

	int res = MultiByteToWideChar(

		CP_ACP,						// ANSI 代码页

		NULL,						// 影响读音符号的字符,一般设置为 NULL

		(LPCCH)BeforeConversion,	// 需要转换的 ANII 字符

		-1,							// 自动计算函数大小

		(LPWSTR)AfterConversion,	// 转换过后的字符串缓冲区

		sizeof(AfterConversion)		// 转换过后的字符串缓冲区的大小

	);

	if (res == 0)	// 函数调用失败返回 0

	{

		cout << "转换失败" << endl;

	}
	WCHAR BeforeConverion[] = L"ABCDEFG";

	CHAR AfterConversion[10] = { 0 };

	CHAR DefaultChar = '*';

	BOOL UserDefaultChar = NULL;

	int res = WideCharToMultiByte(

		CP_UTF8,					// 使用 CP_UTF8 代码页完成从宽字节到多字节的转换

		NULL,						// 一般为 NULL

		(LPCWCH)BeforeConverion,	// 需要转换的字符串的地址

		-1,							// 自动计算转换字符串的大小

		(LPSTR)AfterConversion,		// 转换完成时字符串储存地址

		sizeof(AfterConversion),	// 储存地址大小

		(LPCCH)DefaultChar,			// 遇到无法转换的字符时用什么代替

		(LPBOOL)UserDefaultChar		// 转换成功返回 FALSE,有一个或者多个字符无法转换时设置为 TRUE

	);

	if (res != 0 && UserDefaultChar == FALSE)

	{

		cout << "转换成功" << endl;

	}

	else // 调用之后返回 0 表示失败

	{

		switch (res)

		{

		case ERROR_INSUFFICIENT_BUFFER:

			cout << "提供的缓冲区大小不够大,或者错误地设置为NULL" << endl; break;

		case ERROR_INVALID_FLAGS:

			cout << "为标志提供的值无效" << endl; break;

		case ERROR_INVALID_PARAMETER:

			cout << "任何参数值都无效" << endl; break;

		case ERROR_NO_UNICODE_TRANSLATION:

			cout << "在字符串中找到无效的Unicode" << endl; break;

		}

	}
- IsTextUnicode(用于判断是 ANSI 字符还是宽字节字符)
	CHAR JudgeStr[] = "ABCDEFG"; // 测试字符串

	int Result = IS_TEXT_UNICODE_REVERSE_MASK; // 是否包含宽字界字符标志位

	BOOL res = IsTextUnicode((const void *)JudgeStr, sizeof(JudgeStr), (LPINT)&Result);

	if (res != 0)

	{

		cout << "包含宽字节字符" << endl;

	}

	else

	{

		cout << "为 ANSI 字符" << endl;

	}
Windows核心编程笔记之处理字符串的更多相关文章
- Windows核心编程笔记之进程
改变进程基址,获取进程基址 #include <Windows.h> #include <iostream> #include <strsafe.h> #inclu ...
- Windows核心编程笔记之内核对象
0x01 子进程继承父进程内核对象句柄 父进程 #include <Windows.h> #include <iostream> #include <strsafe.h& ...
- Windows核心编程笔记之错误处理
0x01 GetLastError() 函数用于获取上一个操作的错误代码 #include <Windows.h> #include <iostream> using name ...
- Windows核心编程笔记之作业
创建作业,并加以限制 HANDLE WINAPI CreateJob() { BOOL IsInJob = FALSE; DWORD ErrorCode = NULL; // 不能将已经在作业中的进程 ...
- 《Windows核心编程》读书笔记 上
[C++]<Windows核心编程>读书笔记 这篇笔记是我在读<Windows核心编程>第5版时做的记录和总结(部分章节是第4版的书),没有摘抄原句,包含了很多我个人的思考和对 ...
- C++Windows核心编程读书笔记
转自:http://www.makaidong.com/%E5%8D%9A%E5%AE%A2%E5%9B%AD%E6%96%87/71405.shtml "C++Windows核心编程读书笔 ...
- 【转】《windows核心编程》读书笔记
这篇笔记是我在读<Windows核心编程>第5版时做的记录和总结(部分章节是第4版的书),没有摘抄原句,包含了很多我个人的思考和对实现的推断,因此不少条款和Windows实际机制可能有出入 ...
- windows核心编程---第二章 字符和字符串处理
使用vc编程时项目-->属性-->常规栏下我们可以设置项目字符集合,它可以是ANSI(多字节)字符集,也可以是unicode字符集.一般情况下说Unicode都是指UTF-16.也 ...
- Windows核心编程第二章,字符串的表示以及宽窄字符的转换
目录 Windows核心编程,字符串的表示以及宽窄字符的转换 1.字符集 1.1.双字节字符集DBCS 1.2 Unicode字符集 1.3 UTF-8编码 1.4 UTF - 32编码. 1.5 U ...
随机推荐
- Hive数据导出的几种方式
在hive的日常使用中,经常需要将hive表中的数据导出来,虽然hive提供了多种导出方式,但是面对不同的数据量.不同的需求,如果随意就使用某种导出方式,可能会导致导出时间过长,导出的结果不满足需求, ...
- SpEL表达式注入
一.内容简介 Spring Expression Language(简称SpEL)是一种强大的表达式语言,支持在运行时查询和操作对象图.语言语法类似于Unified EL,但提供了额外的功能,特别是方 ...
- P1604_B进制星球(JAVA语言)
思路:BigInteger 五杀!利用BigInteger自带的进制转换. //第一次提交WA了几组数据,下载测试数据发现带字母的答案要转换为大写. 题目背景 进制题目,而且还是个计算器~~ 题目描述 ...
- pta 简单求和
6-1 简单求和 (10 分) 本题要求实现一个函数,求给定的N个整数的和. 函数接口定义: int Sum ( int List[], int N ); 其中给定整数存放在数组List[]中,正 ...
- 比Django官方实现更好的分页组件+Bootstrap整合
前言 Django全家桶自带的分页组件只能说能满足分页这个功能,但是没那么好用就是了 Django的分页效果 django-pure-pagination分页效果 使用方法 首先安装: pip ins ...
- java例题_16 九九乘法表
1 /*题目:输出 9*9 口诀. 2 程序分析:分行与列考虑,共 9 行 9 列,i 控制行,j 控制列. 3 */ 4 5 /*分析 6 * 用两侧for循环,外层循环还要控制换行 7 * 换行时 ...
- LiteOS内核源码分析:任务LOS_Schedule
摘要:调度,Schedule也称为Dispatch,是操作系统的一个重要模块,它负责选择系统要处理的下一个任务.调度模块需要协调处于就绪状态的任务对资源的竞争,按优先级策略从就绪队列中获取高优先级的任 ...
- 利用别名切换索引流程Elasticsearch 7.7
背景 公司里面现在有es集群,由于时间过长,es集群中的某个索引过大但是未删除,一直在写入的情况下,昨天写入突然停止了,发现是索引超时的问题,这时想到通过创建一个新的索引来进行索引切换 操作 es 集 ...
- kubernetes中有状态应用的优雅缩容
将有状态的应用程序部署到Kubernetes是棘手的. StatefulSet使它变得容易得多,但是它们仍然不能解决所有问题.最大的挑战之一是如何缩小StatefulSet而不将数据留在断开连接的Pe ...
- Elasticsearch 集群优化-尽可能全面详细
Elasticsearch 集群优化-转载参考1 基本配置 基本配置,5台配置为 24C 125G 17T 的主机,每台主机上搭建了一个elasticsearch节点. 采用的elasticsearc ...