
CMU Database Systems - Parallel Execution
并发执行,主要为了增大吞吐,降低延迟,提高数据库的可用性
先区分一组概念,parallel和distributed的区别
总的来说,parallel是指在物理上很近的节点,比如本机的多个线程或进程,不用考虑通信代价
distributed,要充分的考虑通信代价,failover的问题,更为复杂

Process Model
先解释一下概念,
process model,指数据库系统架构设计,用于支持多用户的并发请求
worker,用于执行客户端tasks的DBMS组件
通常的process model有3种,
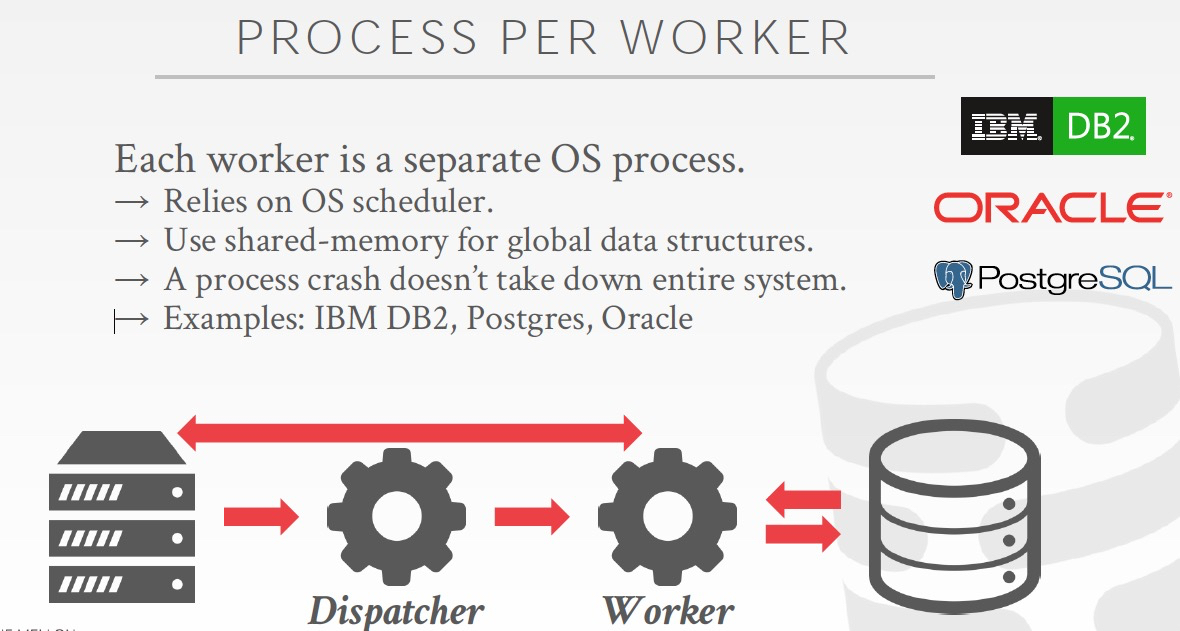
Process Per Worker,每个worker都是一个系统进程,
进程最大优点,隔离好,不会因为一个worker影响整个库,但问题肯定是太重,比较低效,支持不了高并发
早期的数据库往往采用这个方案,是因为那个时候线程的方案还不成熟
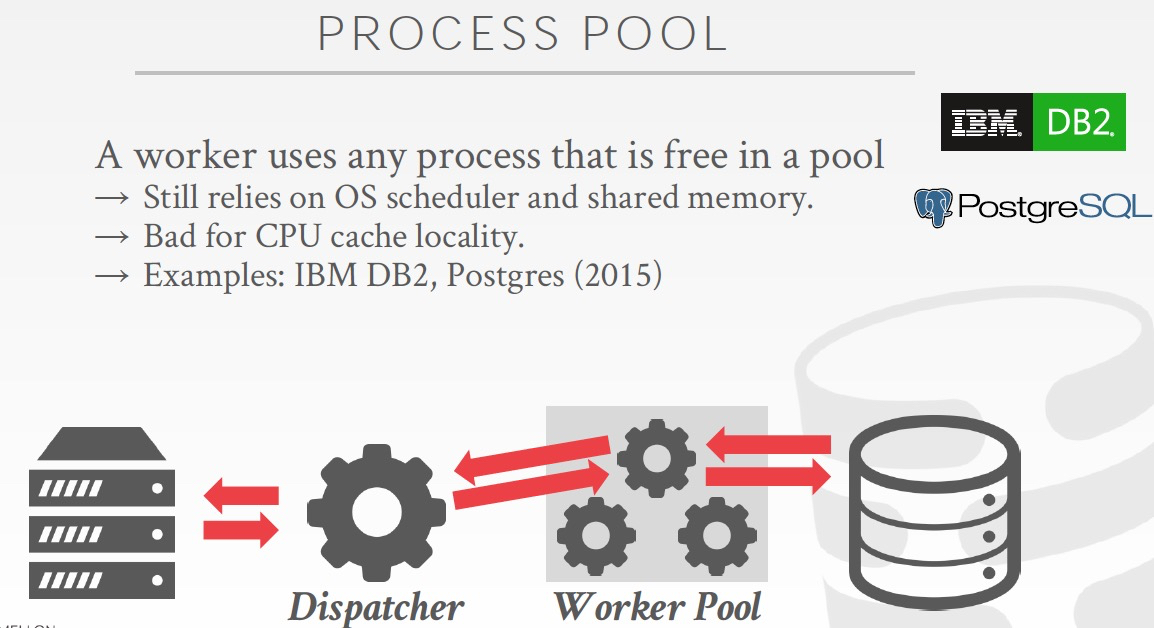
Process Pool,这个方案和上面的没有本质不同,只是worker从只用一个进程,到使用一个进程pool
Pool的好处,一个worker可以同时相应多个请求,而且一个进程hang住了,不会影响worker工作
坏处,一个client的连续的请求会分配到不同的进程,那么CPU cache locality上就不是很好
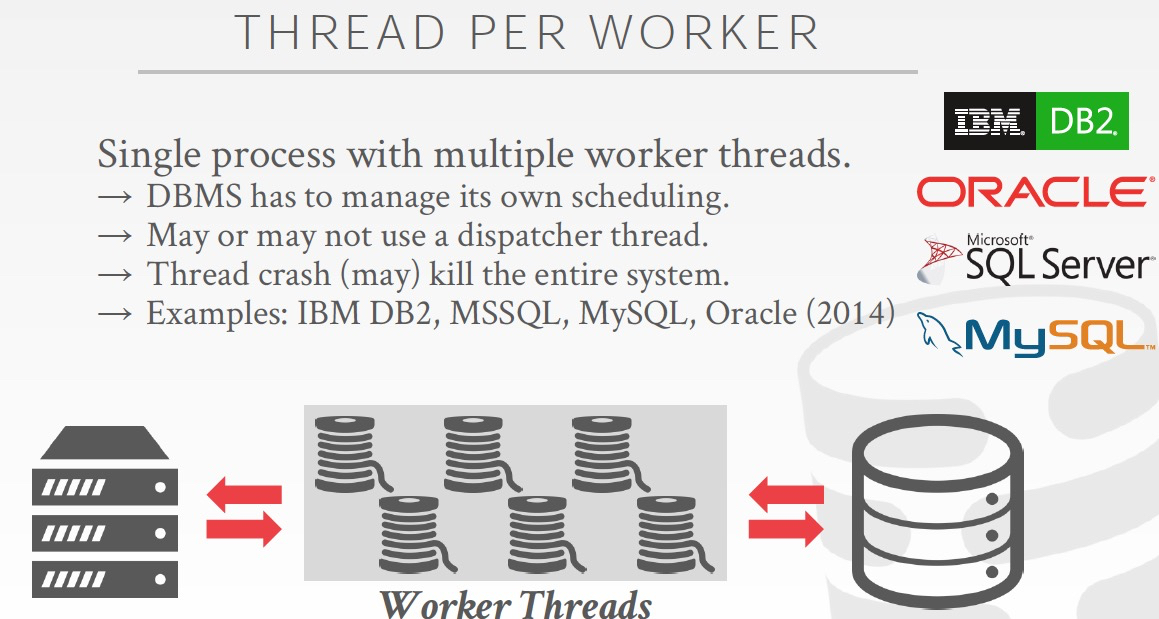
Thread Per Worker
这个是当前主流的process model,
一个数据库实例是一个进程,worker通过线程实现,这样由DBMS自己进行线程调度
线程模型明显更加轻量,更容易应对高并发的场景,而且线程间通信的成本很低
最大的问题是隔离性不好,一个线程可能把整个库搞挂
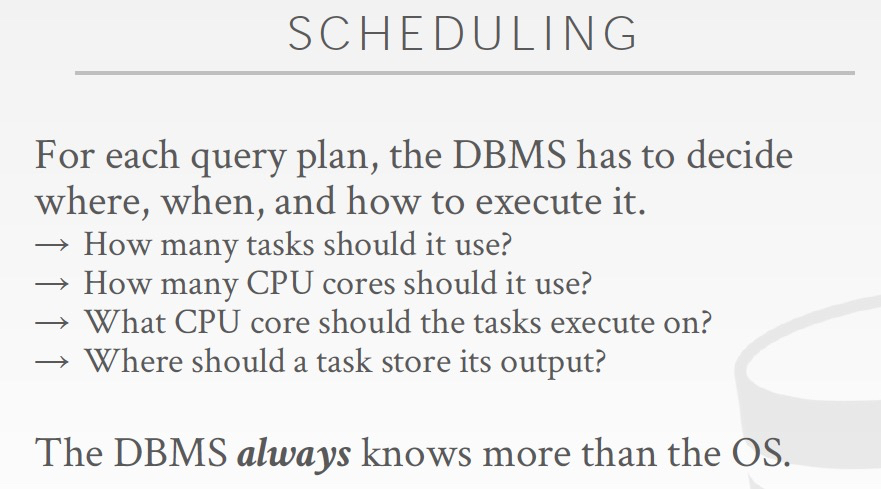
Parallel Execution
并行有两种,
不同的query,并行的执行
一条query中不同的operation并行的执行
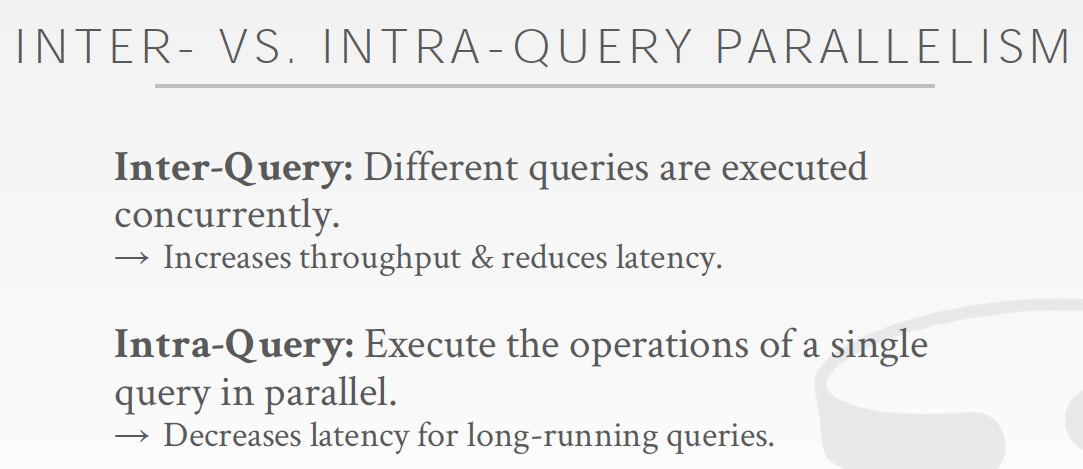
Inter-query,很容易理解,要解决的也就是并发控制问题,这个后面会讲
这里重点说下Intra-query,它也是包含两种类型,Intra-operator和Inter-operator
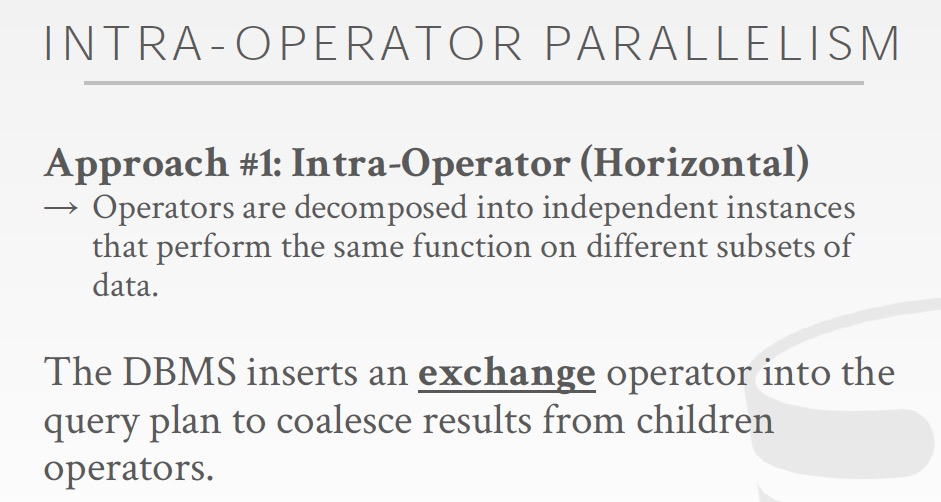
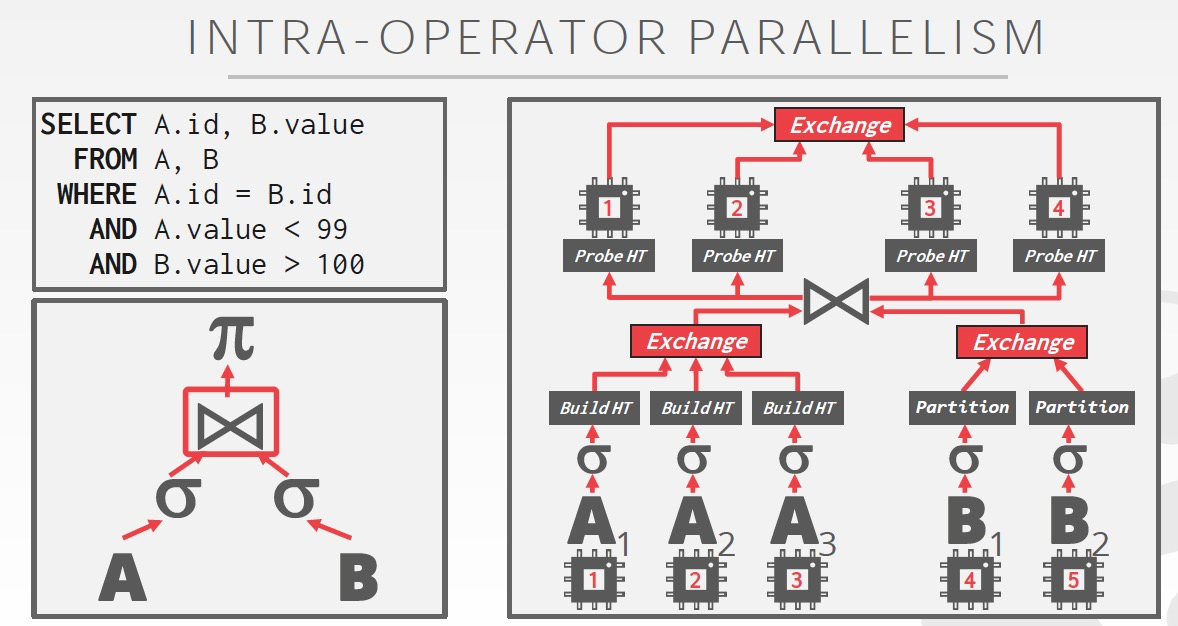
首先是Intra-operator,水平并行,MPP
把数据水平分成多份,分别执行,有个Exchange,类似latch,等待所有分片都执行完,做相应的merge然后再往上发送
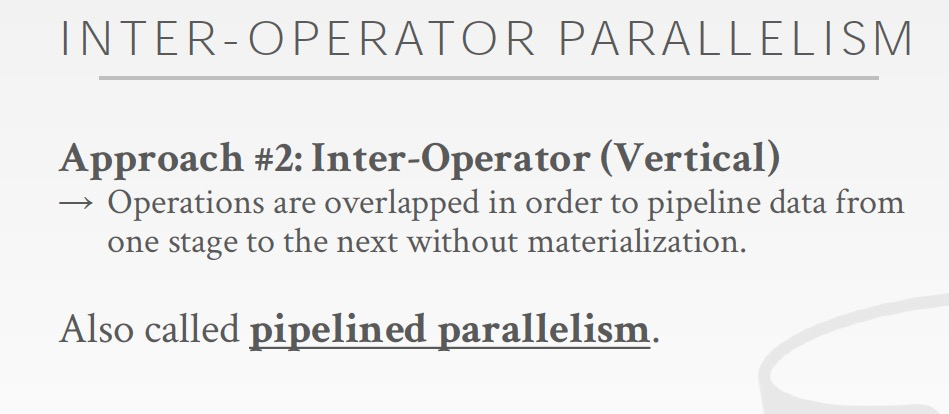
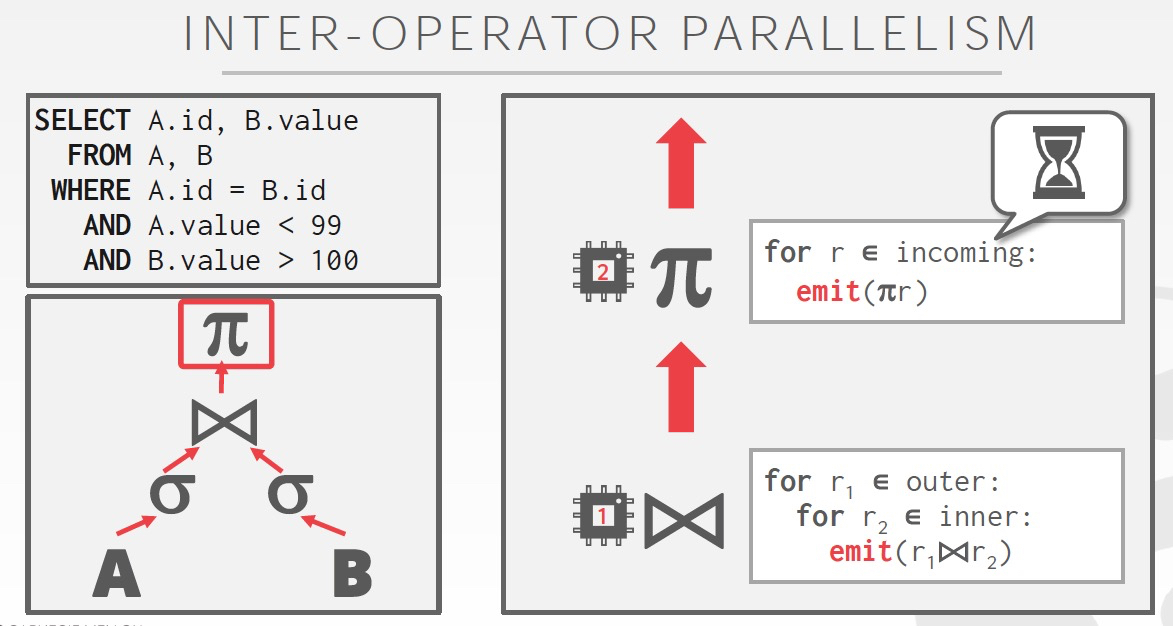
然后是,Inter-operator,DAG方式,pipeline,streaming process
I/O PARALLELISM
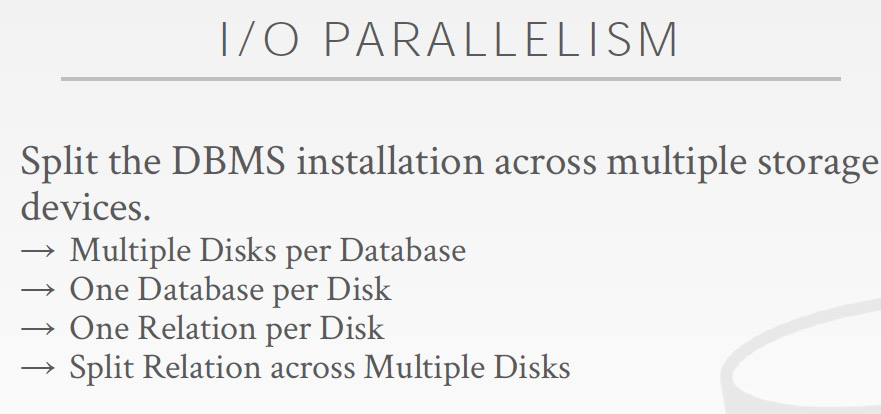
前面光说了,平行处理,但是数据库的瓶颈大部分在磁盘IO
所以如果要并行计算,关键是数据要能划分开,并行的读取
一些比较简单的方法如下,
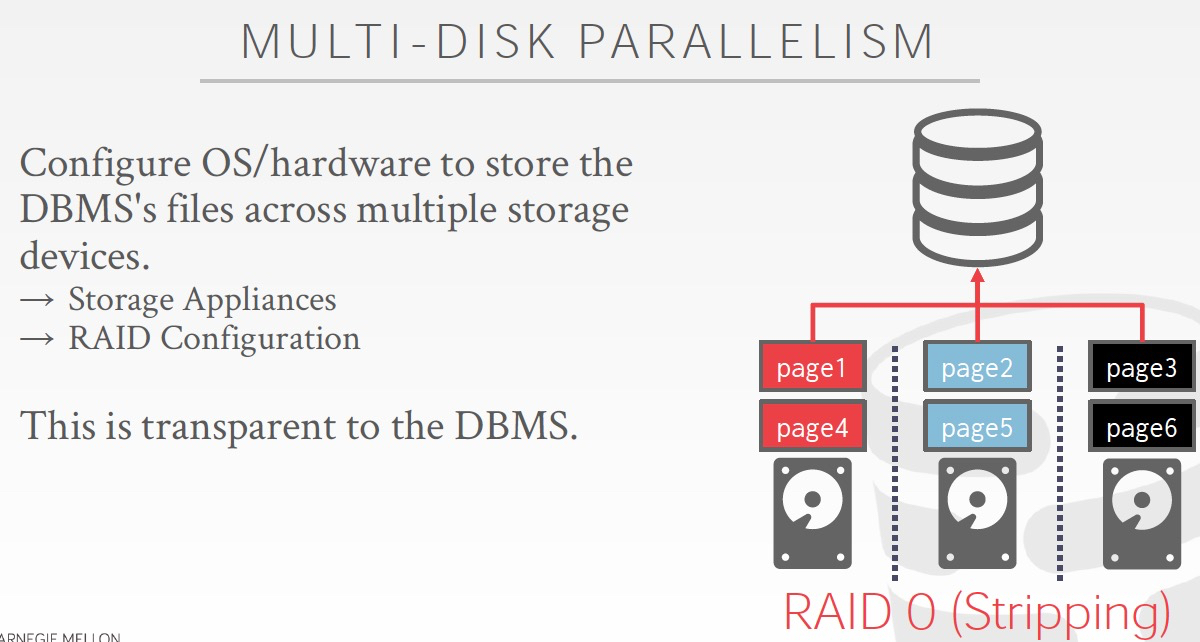
人为的分多块盘,或是用raid0,raid1
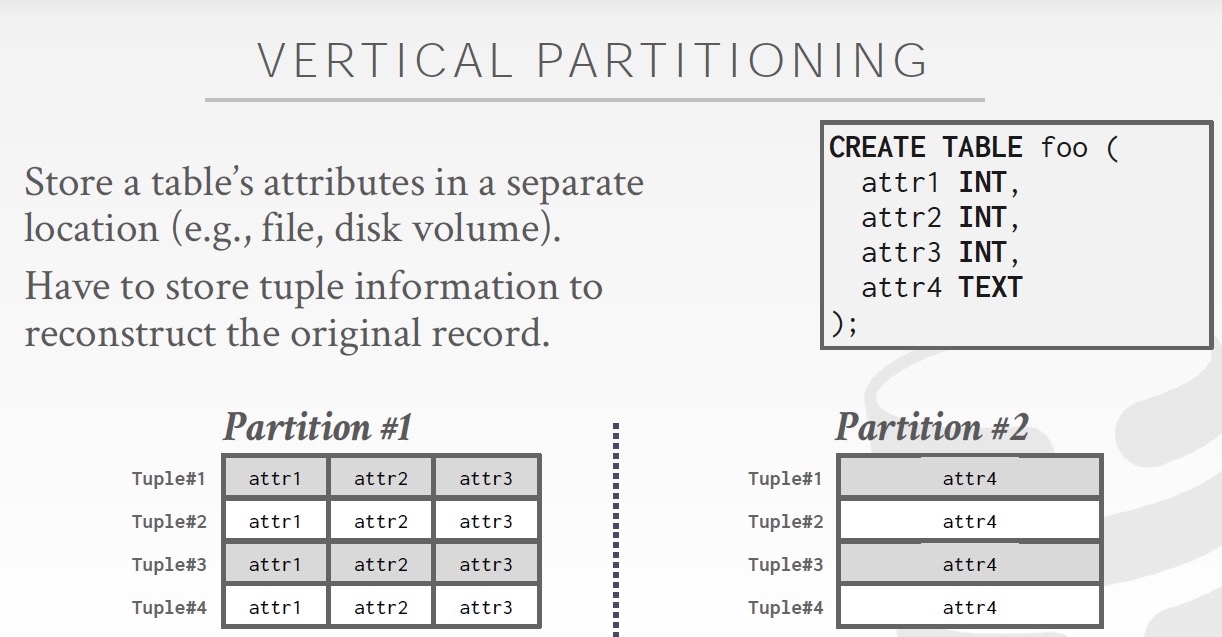
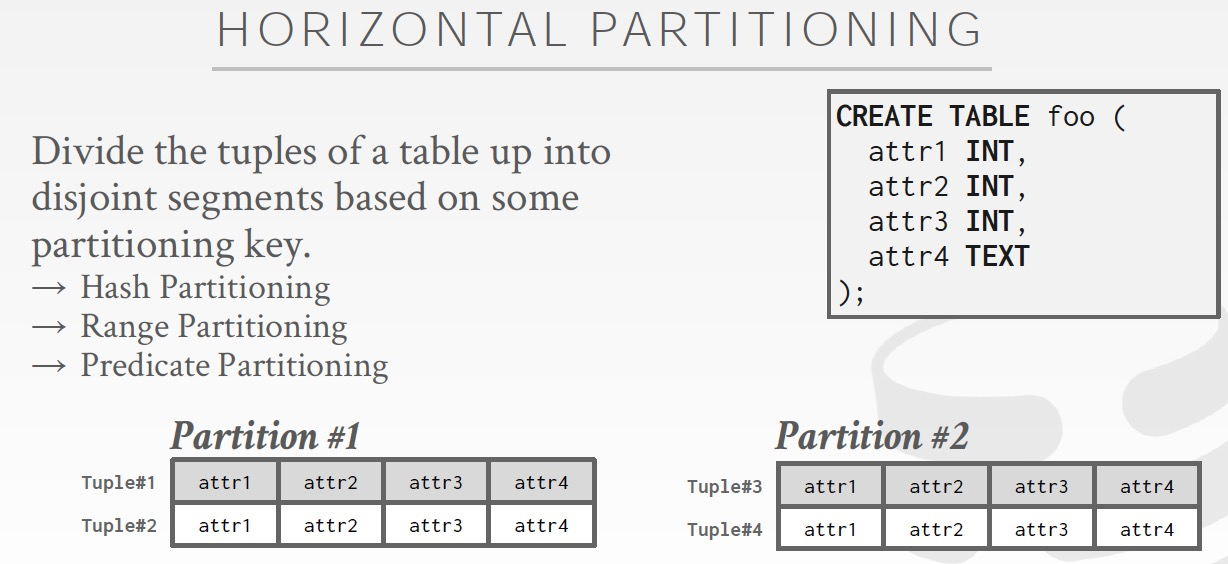
但是如果要在表级别做划分,就需要更为复杂的方法,对数据做partition

划分又分为两种,
垂直划分,列存
水平划分,sharding
CMU Database Systems - Parallel Execution的更多相关文章
- CMU Database Systems - Distributed OLTP & OLAP
OLTP scale-up和scale-out scale-up会有上限,无法不断up,而且相对而言,up升级会比较麻烦,所以大数据,云计算需要scale-out scale-out,就是分布式数据库 ...
- CMU Database Systems - Database Recovery
数据库数据丢失的典型场景如下, 数据commit后,还没有来得及flush到disk,这时候crash就会丢失数据 当然这只是fail的一种情况,DataBase Recovery要讨论的是,在各种f ...
- CMU Database Systems - Timestamp Ordering Concurrency Control
2PL是悲观锁,Pessimistic,这章讲乐观锁,Optimistic,单机的,非分布式的 Timestamp Ordering,以时间为序,这个是非常自然的想法,按每个transaction的时 ...
- CMU Database Systems - Concurrency Control Theory
并发控制是数据库理论里面最难的课题之一 并发控制首先了解一下事务,transaction 定义如下, 其实transaction关键是,要满足ACID属性, 左边的正式的定义,由于的intuitive ...
- CMU Database Systems - Storage and BufferPool
Database Storage 存储分为volatile和non-volatile,越快的越贵越小 那么所以要解决的第一个问题就是,如果尽量在有限的成本下,让读写更快些 意思就是,尽量读写volat ...
- CMU Database Systems - Two-phase Locking
首先锁是用来做互斥的,解决并发执行时的数据不一致问题 如图会导致,不可重复读 如果这里用lock就可以解决,数据库里面有个LockManager来作为master,负责锁的记录和授权 数据库里面的基本 ...
- CMU Database Systems - MVCC
MVCC是一种用空间来换取更高的并发度的技术 对同一个对象不去update,而且记录下每一次的不同版本的值 存在不会消失,新值并不能抹杀原先的存在 所以update操作并不是对世界的真实反映,这是一种 ...
- CMU Database Systems - Embedded Database Logic
正常应用和数据库交互的过程是这样的, 其实我们也可以把部分应用逻辑放到DB端去执行,来提升效率 User-defined Function Stored Procedures Triggers Cha ...
- CMU Database Systems - Query Optimization
查询优化应该是数据库领域最难的topic 当前查询优化,主要有两种思路, Rules-based,基于先验知识,用if-else把优化逻辑写死 Cost-based,试图去评估各个查询计划的cost, ...
随机推荐
- mongdb插入 查询时间
Robo 3T mongdb客户端 https://www.robomongo.org/ 模糊查找关键字 db.getCollection('test').find({"name" ...
- 交互式计算引擎MOLAP篇
交互式计算引擎MOLAP篇 摘自:<大数据技术体系详解:原理.架构与实践> MOLAP是一种通过预计算cube方式加速查询的OLAP引擎,它的核心思想是“空间换时间”,典型代表包括Drui ...
- AQS的子类在各个同步工具类中的使用情况
AQS AQS(AbstractQueuedSynchronizer)是 java.util.concurrent的基础.J.U.C中宣传的封装良好的同步工具类Semaphore.CountDownL ...
- Java精通并发-自旋对于synchronized关键字的底层意义与价值分析以及互斥锁属性详解与Monitor对象特性解说【纯理论】
自旋对于synchronized关键字的底层意义与价值分析: 对于synchronized关键字的底层意义和价值分析,下面用纯理论的方式来对它进行阐述,自旋这个概念就会应运而生,还是很重要的,下面阐述 ...
- 《少年先疯队》第八次团队作业:Alpha冲刺第二天
前言 第一天冲刺会议 时间:2019.6.15 地点:宿舍 2.1 今日完成任务情况以及遇到的问题. 2.1.1今日完成任务情况 姚玉婷:房间信息管理功能的实现,如房间的显示, 马丽莎 ...
- screen 调到后台使用
yum -y install screen screen -S name 开启后台进程 screen -ls 显示进程 screen -r ID号 进入 Ctrl+r再 ...
- Hibernate的关联关系映射
技术分析之Hibernate的关联关系映射之一对多映射(重点) 1. JavaWEB中一对多的设计及其建表原则 2. 先导入SQL的建表语句 ...
- LightOJ - 1226 - One Unit Machine(排列组合)
链接: https://vjudge.net/problem/LightOJ-1226 题意: OUM is a one unit machine which processes jobs. Sinc ...
- SpringMVC的拦截器和数据校验
SpringMVC拦截器 什么是拦截器:Spring MVC中的拦截器(Interceptor)类似于Servlet中的过滤器(Filter),它主要用于拦截用户请求并作相应的处理.例如通过拦截器可以 ...
- php之大文件断点续传
前段时间做视频上传业务,通过网页上传视频到服务器. 视频大小 小则几十M,大则 1G+,以一般的HTTP请求发送数据的方式的话,会遇到的问题:1,文件过大,超出服务端的请求大小限制:2,请求时间过长, ...