
机器学习入门-文本特征-使用LDA主题模型构造标签 1.LatentDirichletAllocation(LDA用于构建主题模型) 2.LDA.components(输出各个词向量的权重值)
函数说明
1.LDA(n_topics, max_iters, random_state) 用于构建LDA主题模型,将文本分成不同的主题
参数说明:n_topics 表示分为多少个主题, max_iters表示最大的迭代次数, random_state 表示随机种子
2. LDA.components_ 打印输入特征的权重参数,
LDA主题模型:可以用于做分类,好比如果是两个主题的话,那就相当于是分成了两类,同时我们也可以找出根据主题词的权重值,来找出一些主题的关键词
使用sklearn导入库
from sklearn.decomposition import LatentDirichletAllocation, 使用方法还是fit_transform
LDA.components_ 打印出各个参数的权重值,这个权重值是根据数据特征的标签来进行排列的
代码:
第一步:Dataframe化数据
第二步:进行分词和停用词的去除,使用' '.join 为了词袋模型做准备
第三步:使用np.vectorizer对函数进行向量化处理,调用定义的函数进行分词和停用词的去除
第四步:使用Tf-idf 函数构建词袋模型
第五步:使用LatentDirichletAllocation构建LDA模型,并进行0,1标签的数字映射
第六步:使用LDA.components_打印输入特征标签的权重得分,去除得分小于0.6的得分,我们可以看出哪些词是主要的关键字
import pandas as pd

import numpy as np

import re

import nltk #pip install nltk

corpus = ['The sky is blue and beautiful.',

          'Love this blue and beautiful sky!',

          'The quick brown fox jumps over the lazy dog.',

          'The brown fox is quick and the blue dog is lazy!',

          'The sky is very blue and the sky is very beautiful today',

          'The dog is lazy but the brown fox is quick!'

]

labels = ['weather', 'weather', 'animals', 'animals', 'weather', 'animals']

# 第一步:构建DataFrame格式数据

corpus = np.array(corpus)

corpus_df = pd.DataFrame({'Document': corpus, 'categoray': labels})

# 第二步:构建函数进行分词和停用词的去除

# 载入英文的停用词表

stopwords = nltk.corpus.stopwords.words('english')

# 建立词分割模型

cut_model = nltk.WordPunctTokenizer()

# 定义分词和停用词去除的函数

def Normalize_corpus(doc):

    # 去除字符串中结尾的标点符号

    doc = re.sub(r'[^a-zA-Z0-9\s]', '', string=doc)

    # 是字符串变小写格式

    doc = doc.lower()

    # 去除字符串两边的空格

    doc = doc.strip()

    # 进行分词操作

    tokens = cut_model.tokenize(doc)

    # 使用停止用词表去除停用词

    doc = [token for token in tokens if token not in stopwords]

    # 将去除停用词后的字符串使用' '连接,为了接下来的词袋模型做准备

    doc = ' '.join(doc)

    return doc

# 第三步:向量化函数和调用函数

# 向量化函数,当输入一个列表时,列表里的数将被一个一个输入,最后返回也是一个个列表的输出

Normalize_corpus = np.vectorize(Normalize_corpus)

# 调用函数进行分词和去除停用词

corpus_norm = Normalize_corpus(corpus)

# 第四步:使用TfidVectorizer进行TF-idf词袋模型的构建

from sklearn.feature_extraction.text import TfidfVectorizer

Tf = TfidfVectorizer(use_idf=True)

Tf.fit(corpus_norm)

vocs = Tf.get_feature_names()

corpus_array = Tf.transform(corpus_norm).toarray()

corpus_norm_df = pd.DataFrame(corpus_array, columns=vocs)

print(corpus_norm_df.head())

# 第五步:构建LDA主题模型

from sklearn.decomposition import LatentDirichletAllocation

LDA = LatentDirichletAllocation(n_topics=2, max_iter=100, random_state=42)

LDA_corpus = np.array(LDA.fit_transform(corpus_array))

LDA_corpus_one = np.zeros([LDA_corpus.shape[0]])

LDA_corpus_one[LDA_corpus[:, 0] < LDA_corpus[:, 1]] = 1

corpus_norm_df['LDA_labels'] = LDA_corpus_one

print(corpus_norm_df.head())
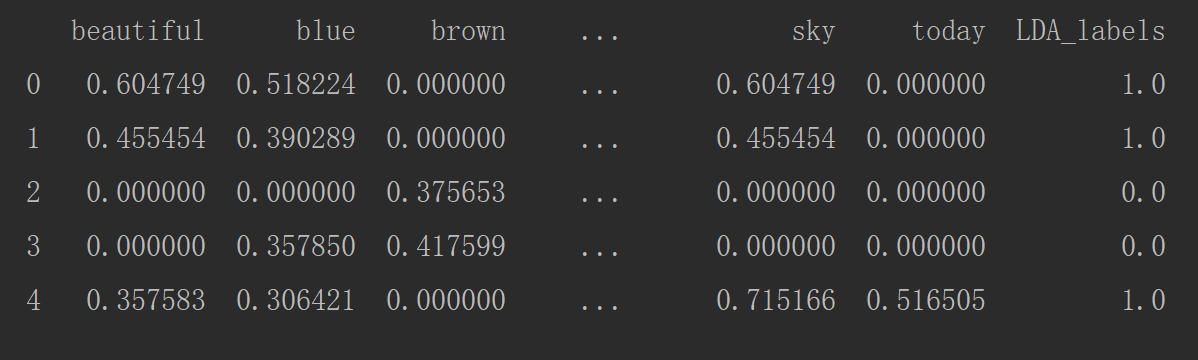
# 第六步:打印每个单词的主题的权重值

tt_matrix = LDA.components_

for tt_m in tt_matrix:

    tt_dict = [(name, tt) for name, tt in zip(vocs, tt_m)]

    tt_dict = sorted(tt_dict, key=lambda x: x[1], reverse=True)

    # 打印权重值大于0.6的主题词

    tt_dict = [tt_threshold for tt_threshold in tt_dict if tt_threshold[1] > 0.6]

    print(tt_dict)

大于0.6权重得分的部分特征
机器学习入门-文本特征-使用LDA主题模型构造标签 1.LatentDirichletAllocation(LDA用于构建主题模型) 2.LDA.components(输出各个词向量的权重值)的更多相关文章
- 机器学习入门-文本特征-word2vec词向量模型 1.word2vec(进行word2vec映射编码)2.model.wv['sky']输出这个词的向量映射 3.model.wv.index2vec(输出经过映射的词名称)
函数说明: 1. from gensim.model import word2vec 构建模型 word2vec(corpus_token, size=feature_size, min_count ...
- 机器学习入门-文本数据-构造Ngram词袋模型 1.CountVectorizer(ngram_range) 构建Ngram词袋模型
函数说明: 1 CountVectorizer(ngram_range=(2, 2)) 进行字符串的前后组合,构造出新的词袋标签 参数说明:ngram_range=(2, 2) 表示选用2个词进行前后 ...
- 机器学习入门-数值特征-数字映射和one-hot编码 1.LabelEncoder(进行数据自编码) 2.map(进行字典的数字编码映射) 3.OnehotEncoder(进行one-hot编码) 4.pd.get_dummies(直接对特征进行one-hot编码)
1.LabelEncoder() # 用于构建数字编码 2 .map(dict_map) 根据dict_map字典进行数字编码的映射 3.OnehotEncoder() # 进行one-hot编码 ...
- 机器学习入门09 - 特征组合 (Feature Crosses)
原文链接:https://developers.google.com/machine-learning/crash-course/feature-crosses/ 特征组合是指两个或多个特征相乘形成的 ...
- 机器学习入门-文本数据-构造词频词袋模型 1.re.sub(进行字符串的替换) 2.nltk.corpus.stopwords.words(获得停用词表) 3.nltk.WordPunctTokenizer(对字符串进行分词操作) 4.np.vectorize(对函数进行向量化) 5. CountVectorizer(构建词频的词袋模型)
函数说明: 1. re.sub(r'[^a-zA-Z0-9\s]', repl='', sting=string) 用于进行字符串的替换,这里我们用来去除标点符号 参数说明:r'[^a-zA-Z0- ...
- 机器学习入门-文本数据-构造Tf-idf词袋模型(词频和逆文档频率) 1.TfidfVectorizer(构造tf-idf词袋模型)
TF-idf模型:TF表示的是词频:即这个词在一篇文档中出现的频率 idf表示的是逆文档频率, 即log(文档的个数/1+出现该词的文档个数) 可以看出出现该词的文档个数越小,表示这个词越稀有,在这 ...
- 机器学习入门-数值特征-对数据进行log变化
对于一些标签和特征来说,分布不一定符合正态分布,而在实际的运算过程中则需要数据能够符合正态分布 因此我们需要对特征进行log变化,使得数据在一定程度上可以符合正态分布 进行log变化,就是对数据使用n ...
- 机器学习入门-数值特征-数据四分位特征 1.quantile(用于求给定分数位的数值) 2.plt.axvline(用于画出竖线) 3.pd.pcut(对特征进行分位数切分,生成新的特征)
函数说明: 1. .quantile(cut_list) 对DataFrame类型直接使用,用于求出给定列表中分数的数值,这里用来求出4分位出的数值 2. plt.axvline() # 用于画 ...
- 机器学习入门-数值特征-连续数据离散化(进行分段标记处理) 1.hist(Dataframe格式直接画直方图)
函数说明: 1. .hist 对于Dataframe格式的数据,我们可以使用.hist直接画出直方图 对于一些像年龄和工资一样的连续数据,我们可以对其进行分段标记处理,使得这些连续的数据变成离散化 就 ...
随机推荐
- 窗口事件onresize
在做自适应布局的时候,我们常常需要根据窗口不同的分辨率给出不同布局和样式,今天说的onresize便能帮我们实现这一效果. onresize事件在窗口或者框架的大小发生改变的时候会被调用,下面我们用一 ...
- springboot(整合事务和分布式事务)
springboot +mybatis 单数据源,事务 事务:简单理解指的是一组操作,里面包含许多个单一的逻辑,只要有一个逻辑没有执行成功 ,那么都算失败.所有的数据都回归到最初的状态(回滚) 代码实 ...
- 云中树莓派(3):通过 AWS IoT 控制树莓派上的 Led
云中树莓派(1):环境准备 云中树莓派(2):将传感器数据上传到AWS IoT 并利用Kibana进行展示 云中树莓派(3):通过 AWS IoT 控制树莓派上的Led 云中树莓派(4):利用声音传感 ...
- 关于微信小程序如何解决多层循环嵌套
http://www.jianshu.com/p/87cdf985b2b9 附加:小程序里面一些功能示例 http://blog.csdn.net/column/details/13721.html
- [UE4]射击起点、终点的计算方法
一.射击起点,这个简单,一般是以角色的相机位置为作为射击起点,而不是枪口的位置作为起点 二.射击终点,角色朝向 * 射击距离 + 射击起点 角色朝向:单位向量 角色朝向 * 射击距离:向量长度 向量长 ...
- [UE4]制作按钮小技巧
Normal和Pressed一样的图片和大小,Hovered也是一样的图片但是大小比Normal稍微大一点,这样点击按钮的时候就会产生按钮被按下去的感觉.
- 关于 MySQL LEFT JOIN 不可不知的事
你认为自己已对 MySQL 的 LEFT JOIN 理解深刻,这篇文章,我想让你能多学会点东西! ON 子句与 WHERE 子句的不同 一种更好地理解带有 WHERE ... IS NULL 子句的复 ...
- centos找不到vim命令
linux系统执行vim命令时,提示centos -bash : vim:command not found 这个时候需要检查vim编辑器是否安装: 输入rpm -qa|grep vim命令, ...
- delphi正则表达式学习笔记(二)
正则表达式大全 字符 描述 \ 将下一个字符标记为一个特殊字符.或一个原义字符.或一个向后引用.或一个八进制转义符.例如,"n"匹配字符"n"."\n ...
- SpringBoot关于系统之间的远程互相调用
1.SpringBoot关于系统之间的远程互相调用 可以采用RestTemplate方式发起Rest Http调用,提供有get.post等方式. 1.1远程工具类 此处使用Post方式,参考下面封装 ...