
机器学习入门-文本数据-构造Tf-idf词袋模型(词频和逆文档频率) 1.TfidfVectorizer(构造tf-idf词袋模型)
TF-idf模型:TF表示的是词频:即这个词在一篇文档中出现的频率
idf表示的是逆文档频率, 即log(文档的个数/1+出现该词的文档个数) 可以看出出现该词的文档个数越小,表示这个词越稀有,在这篇文档中也是越重要的
TF-idf: 表示TF*idf, 即词频*逆文档频率
词袋模型不仅考虑了一个词的词频,同时考虑了这个词在整个语料库中的重要性
代码:
第一步:使用DataFrame格式处理数据,同时数组化数据
第二步:定义函数,进行分词和停用词的去除,并使用‘ ’连接去除停用词后的列表
第三步:使用np.vectorizer向量化函数,同时调用函数进行分词和停用词的去除
第四步:使用TfidfVectorizer函数,构造TF-idf的词袋模型
import pandas as pd

import numpy as np

import re

import nltk #pip install nltk

corpus = ['The sky is blue and beautiful.',

          'Love this blue and beautiful sky!',

          'The quick brown fox jumps over the lazy dog.',

          'The brown fox is quick and the blue dog is lazy!',

          'The sky is very blue and the sky is very beautiful today',

          'The dog is lazy but the brown fox is quick!'

]

labels = ['weather', 'weather', 'animals', 'animals', 'weather', 'animals']

# 第一步:构建DataFrame格式数据

corpus = np.array(corpus)

corpus_df = pd.DataFrame({'Document': corpus, 'categoray': labels})

# 第二步:构建函数进行分词和停用词的去除

# 载入英文的停用词表

stopwords = nltk.corpus.stopwords.words('english')

# 建立词分割模型

cut_model = nltk.WordPunctTokenizer()

# 定义分词和停用词去除的函数

def Normalize_corpus(doc):

    # 去除字符串中结尾的标点符号

    doc = re.sub(r'[^a-zA-Z0-9\s]', '', string=doc)

    # 是字符串变小写格式

    doc = doc.lower()

    # 去除字符串两边的空格

    doc = doc.strip()

    # 进行分词操作

    tokens = cut_model.tokenize(doc)

    # 使用停止用词表去除停用词

    doc = [token for token in tokens if token not in stopwords]

    # 将去除停用词后的字符串使用' '连接,为了接下来的词袋模型做准备

    doc = ' '.join(doc)

    return doc

# 第三步:向量化函数和调用函数

# 向量化函数,当输入一个列表时,列表里的数将被一个一个输入,最后返回也是一个个列表的输出

Normalize_corpus = np.vectorize(Normalize_corpus)

# 调用函数进行分词和去除停用词

corpus_norm = Normalize_corpus(corpus)

# 第四步:使用TfidVectorizer进行TF-idf词袋模型的构建

from sklearn.feature_extraction.text import TfidfVectorizer

Tf = TfidfVectorizer(use_idf=True)

Tf.fit(corpus_norm)

vocs = Tf.get_feature_names()

corpus_array = Tf.transform(corpus_norm).toarray()

corpus_norm_df = pd.DataFrame(corpus_array, columns=vocs)

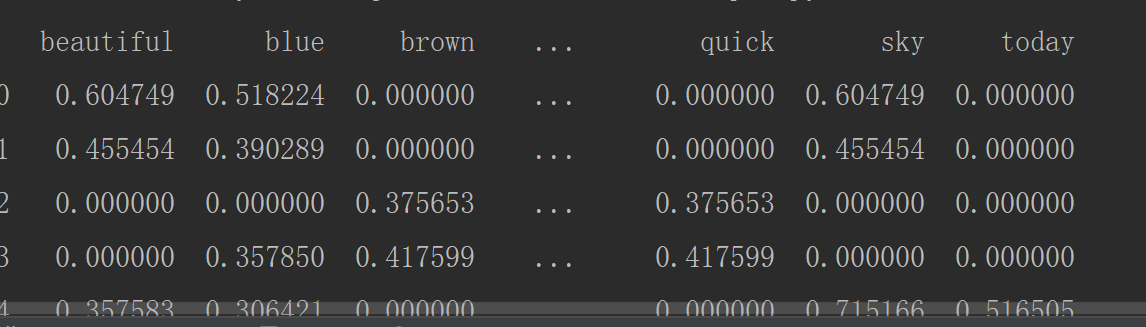
print(corpus_norm_df.head())
机器学习入门-文本数据-构造Tf-idf词袋模型(词频和逆文档频率) 1.TfidfVectorizer(构造tf-idf词袋模型)的更多相关文章
- 机器学习入门-文本数据-构造Ngram词袋模型 1.CountVectorizer(ngram_range) 构建Ngram词袋模型
函数说明: 1 CountVectorizer(ngram_range=(2, 2)) 进行字符串的前后组合,构造出新的词袋标签 参数说明:ngram_range=(2, 2) 表示选用2个词进行前后 ...
- 机器学习入门-文本数据-构造词频词袋模型 1.re.sub(进行字符串的替换) 2.nltk.corpus.stopwords.words(获得停用词表) 3.nltk.WordPunctTokenizer(对字符串进行分词操作) 4.np.vectorize(对函数进行向量化) 5. CountVectorizer(构建词频的词袋模型)
函数说明: 1. re.sub(r'[^a-zA-Z0-9\s]', repl='', sting=string) 用于进行字符串的替换,这里我们用来去除标点符号 参数说明:r'[^a-zA-Z0- ...
- 【Lucene3.6.2入门系列】第14节_SolrJ操作索引和搜索文档以及整合中文分词
package com.jadyer.solrj; import java.util.ArrayList; import java.util.List; import org.apache.solr. ...
- 请转发!简单2分钟制作无接触式小区进出微信登记表!全免费!数据安全!所有数据均存在创建人登录的QQ腾讯文档里!
全免费!数据安全!所有数据均存在创建人登录的QQ腾讯文档里! 阻击疫情到了最吃劲的关键期,大家能不出门就不出门,但免不了出去买个菜.取个快递啥的,每次出入的时候,社区同志都在认真拿着笔记录每个进出信息 ...
- 机器学习入门-文本特征-使用LDA主题模型构造标签 1.LatentDirichletAllocation(LDA用于构建主题模型) 2.LDA.components(输出各个词向量的权重值)
函数说明 1.LDA(n_topics, max_iters, random_state) 用于构建LDA主题模型,将文本分成不同的主题 参数说明:n_topics 表示分为多少个主题, max_i ...
- 机器学习入门-文本特征-word2vec词向量模型 1.word2vec(进行word2vec映射编码)2.model.wv['sky']输出这个词的向量映射 3.model.wv.index2vec(输出经过映射的词名称)
函数说明: 1. from gensim.model import word2vec 构建模型 word2vec(corpus_token, size=feature_size, min_count ...
- C#word(2007)操作类--新建文档、添加页眉页脚、设置格式、添加文本和超链接、添加图片、表格处理、文档格式转化
转:http://www.cnblogs.com/lantionzy/archive/2009/10/23/1588511.html 1.新建Word文档 #region 新建Word文档/// &l ...
- (大数据工程师学习路径)第二步 Vim编辑器----Vim文档编辑
一.vim重复命令 1.重复执行上次命令 在普通模式下.(小数点)表示重复上一次的命令操作 拷贝测试文件到本地目录 $ cp /etc/protocols . 打开文件进行编辑 $ vim proto ...
- 【机器学习】机器学习入门02 - 数据拆分与测试&算法评价与调整
0. 前情回顾 上一周的文章中,我们通过kNN算法了解了机器学习的一些基本概念.我们自己实现了简单的kNN算法,体会了其过程.这一周,让我们继续机器学习的探索. 1. 数据集的拆分 上次的kNN算法介 ...
随机推荐
- extend 与 append 的区别
>>> A = ['q', 'w', 'e', 'r'] >>> A.extend(['t', 'y']) >>> A ['q', 'w', 'e ...
- APP中https证书有效性验证引发安全问题(例Fiddler可抓https包)
原文: https://blog.csdn.net/woddle/article/details/71175140 在实际项目代码审计中发现,目前很多手机银行虽然使用了https通信方式,但是只是简单 ...
- [UE4]RetainerBox,控制UI更新频率,把渲染后的UI当成Texture
RetainerBox是一个容器,只会影响其容器内的UI,RetainerBox的作用: 一.控制UI更新频率(可能是为有优化性能) 1.在UserWidget中添加Retainer Box容器,并在 ...
- UML类关系:依赖、关联、聚合、组合
1,依赖关系(Dependency) 单向,表示一个类依赖于另一个类的定义,其中一个类的变化将影响另外一个类,是一种“use a”关系 如果A依赖于B,则B表现为A的局部变量,方法参数,静态方法调用等 ...
- Mysql 之权限体系
1,MySQL权限体系 MySQL 的权限体系大致分为5个层级: 全局层级: 全局权限适用于一个给定服务器中的所有数据库.这些权限存储在mysql.user表中.GRANT ALL ON .和REVO ...
- SAS数据集推送到sql server 数据库 实现代码段
libname fdsas ODBC datasrc=fdsas user=fdsas password=fdsas123 preserve_tab_names=yes connection=shar ...
- 第8章 传输层(7)_TCP连接管理
7. TCP连接管理 7.1 TCP的连接建立 (1)三次握手 ①三次握手过程 A.第1.2次握手,数据包的SYN均为1,表示用于同步.即第1次客户端发起请求,并将自己的连接参数(如接收窗口大小.MS ...
- TFTP(Trivial File Transfer Protocol,简单文件传输协议)
网络特性 通常使用UDP 69端口(据说可改成TCP) 与FTP区别 轻量级,适用于传输小文件,当然功能也少些,比如没有列出目录功能,不进行认证
- 深入理解Apache Flink
Apache Flink(下简称Flink)项目是大数据处理领域最近冉冉升起的一颗新星,其不同于其他大数据项目的诸多特性吸引了越来越多人的关注.本文将深入分析Flink的一些关键技术与特性,希望能够帮 ...
- Android 真机投影到PC端,真机投影工具;Vysor
Vysor可以把Android真机投影到PC端,也就是电脑上:手机端和PC端课同步操作: Vysor是Chrome浏览器的插件,我们想要添加这个插件需要FQ: 从这里可以直接下载:Vysor