
HDFS 读写数据流程
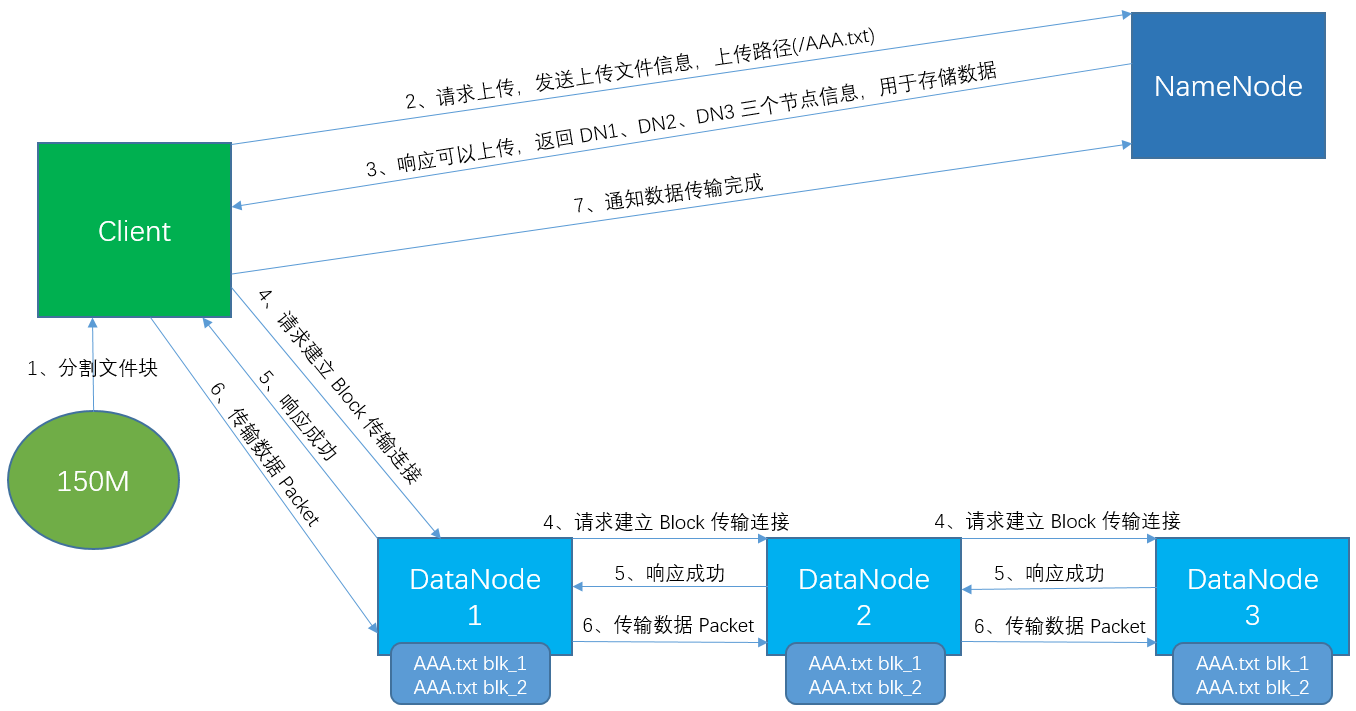
一、上传数据
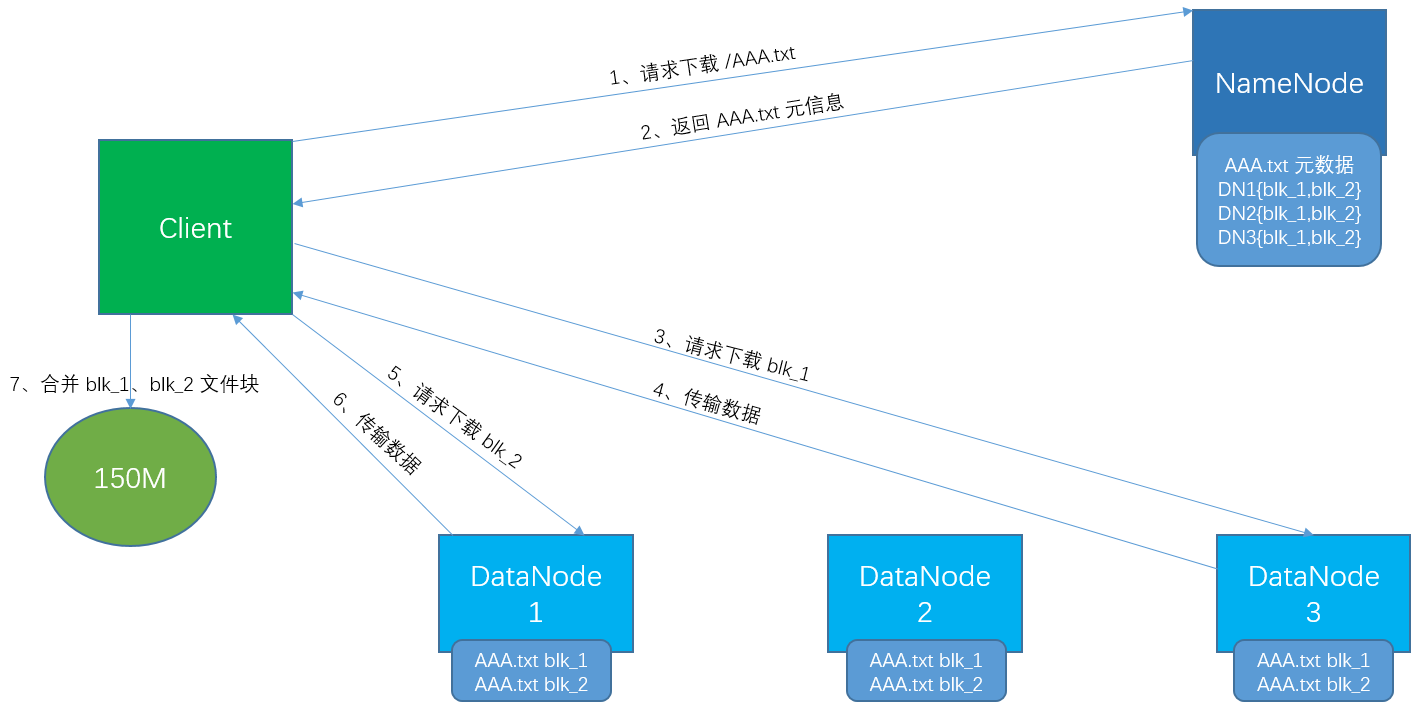
二、下载数据
三、读写时的节点位置选择
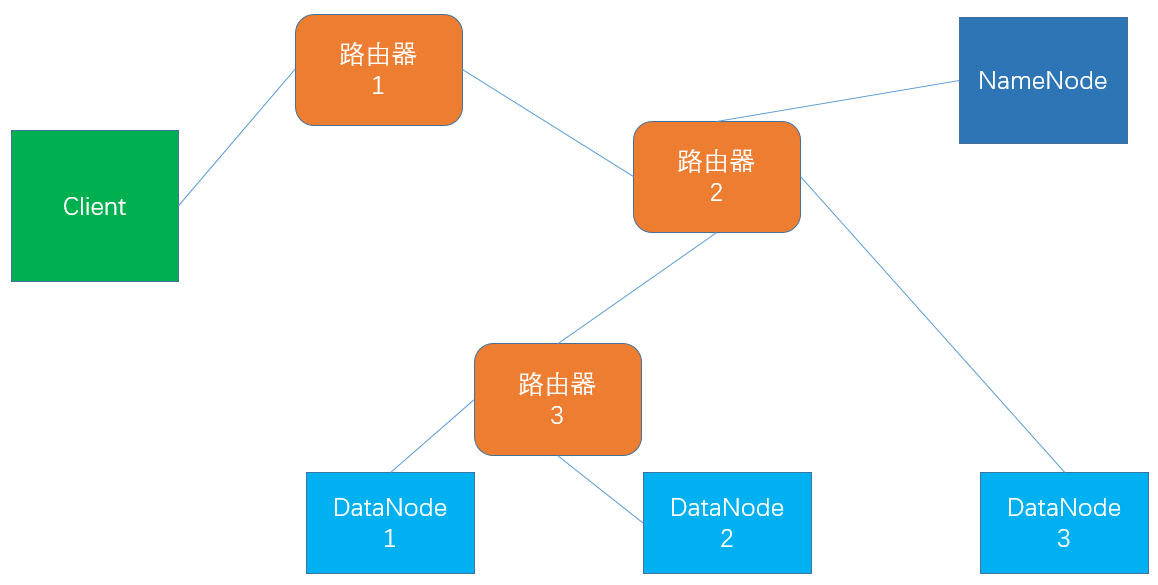
1.网络节点距离(机架感知)
下图中:

client 到 DN1 的距离为 4

client 到 NN 的距离为 3

DN1 到 DN2 的距离为 2
2.Block 的副本放置策略
NameNode 通过 Hadoop Rack Awareness 确定每个 DataNode 所属的机架 ID
简单但非最优的策略
将副本放在单独的机架上

这可以防止在整个机架出现故障时丢失数据,并允许在读取数据时使用来自多个机架的带宽。

此策略在群集中均匀分布副本,平衡组件故障的负载。

但是此策略会增加写入消耗,因为写入时会将块传输到多个机架。
常见情况策略(HDFS 采取的策略)
当复制因子为 3 时,HDFS 的放置策略是:

若客户端位于 datanode 上,则将一个副本放在本地计算机上,否则放在随机 datanode 上

在另一个(远程)机架上的节点上放置另一个副本,最后一个在同一个远程机架中的另一个节点上。

机架故障的可能性远小于节点故障的可能性。

此策略可以减少机架间写入流量,从而提高写入性能,而不会影响数据可靠性和可用性(读取性能)。

这样减少了读取数据时使用的聚合网络带宽,因为块只放在两个唯一的机架,而不是三个。
如果复制因子大于 3,则随机确定第 4 个及后续副本的放置,同时保持每个机架的副本数量低于上限(基本上是(副本 - 1)/机架+ 2)。
由于 NameNode 不允许 DataNode 具有同一块的多个副本,因此创建的最大副本数是此时DataNode的总数。
原文(Replica Placement: The First Baby Steps 章节): http://hadoop.apache.org/docs/current/hadoop-project-dist/hadoop-hdfs/HdfsDesign.html
3.下载时副本的选择
为了最大限度地减少全局带宽消耗和读取延迟,HDFS 会选择最接客户端的节点中的副本来响应读取请求。

如果客户端与 DataNode 节点在同一机架上,且存在所需的副本,则该副本会首读用来响应取请求。

如果 HDFS 群集跨越多个数据中心,则驻留在本地数据中心的副本优先于任何远程副本。
原文(Replica Selection 章节): http://hadoop.apache.org/docs/current/hadoop-project-dist/hadoop-hdfs/HdfsDesign.html
HDFS 读写数据流程的更多相关文章
- 大数据:Hadoop(HDFS 读写数据流程及优缺点)
一.HDFS 写数据流程 写的过程: CLIENT(客户端):用来发起读写请求,并拆分文件成多个 Block: NAMENODE:全局的协调和把控所有的请求,提供 Block 存放在 DataNode ...
- HDFS读写数据流程
HDFS的组成 1.NameNode:存储文件的元数据,如文件名,文件目录结构,文件属性(创建时间,文件权限,文件大小) 以及每个文件的块列表和块所在的DataNode等.类似于一本书的目录功能. 2 ...
- HDFS读写数据块--${dfs.data.dir}选择策略
最近工作需要,看了HDFS读写数据块这部分.不过可能跟网上大部分帖子不一样,本文主要写了${dfs.data.dir}的选择策略,也就是block在DataNode上的放置策略.我主要是从我们工作需要 ...
- Hadoop(8)-HDFS的读写数据流程以及机架感知
1. HDFS的写数据流程 1.客户端通过fs模块向NameNode申请文件上传,NameNode检查请求是否合法,如用户权限,目标文件是否已存在,父目录是否存在等等 2.NameNode返回是否可以 ...
- Hadoop -- HDFS 读写数据
一.HDFS读写文件过程 1.读取文件过程 1) 初始化FileSystem,然后客户端(client)用FileSystem的open()函数打开文件 2) FileSyst ...
- HDFS读写数据过程
一.文件的打开 1.1.客户端 HDFS打开一个文件,需要在客户端调用DistributedFileSystem.open(Path f, int bufferSize),其实现为: public F ...
- Hdfs读写数据出错
1.Hdfs读数据出错:若在读数据的过程中,客户端和DataNode的通信出现错误,则会尝试连接下一个 包含次文件块的DataNode.同时记录失败的DataNode,此后不再被连接. 2.Hdfs在 ...
- HDFS读写文件流程
读取: 写入:https://www.imooc.com/article/70527
- HDFS写数据和读数据流程
HDFS数据存储 HDFS client上传数据到HDFS时,首先,在本地缓存数据,当数据达到一个block大小时.请求NameNode分配一个block. NameNode会把block所在的Dat ...
随机推荐
- mysql 下载地址
新浪的镜像站 http://mirrors.sohu.com/mysql yum安装: 首先要到MySQL yum库的下载页面http://dev.mysql.com/downloads/repo/y ...
- JDK 与TOMCAT的安装详解
转自:http://www.jb51.net/article/51909.htm Tomcat7.0.22在Windows下详细配置过程 一.JDK1.7安装 1.下载jdk,下载地址:http:// ...
- bzoj 2131 : 免费的馅饼 (树状数组优化dp)
题目链接:https://www.lydsy.com/JudgeOnline/problem.php?id=2131 思路: 题目给出了每个馅饼的下落时间t,和位置p,以及价值v,我们可以得到如下状态 ...
- python学习日记(格式化输出,初始编码,运算符)
格式化输出 顾名思义,按照个人意愿定制想输出的格式. name = input('请输入姓名:') age = int(input('请输入年龄:')) job = input('请输入工作:') h ...
- android json 解析简单实例
Android JSON解析跟JAVA 的JSON解析原理是一样的. Android自带的JSON方式跟方便,不需要导包啥的.不深究原理了,直接上代码: public class JsonActivi ...
- 【HDU1846】Brave Game(博弈论)
题面 HDU 题解 \(Bash\ Game\)模板题 #include<iostream> using namespace std; int T,n,m; int main() { io ...
- [SDOI2011]消防
某个国家有n个城市,这n个城市中任意两个都连通且有唯一一条路径,每条连通两个城市的道路的长度为zi(zi<=1000). 这个国家的人对火焰有超越宇宙的热情,所以这个国家最兴旺的行业是消防业.由 ...
- CodeForces - 589A(字符串处理)
题目链接:http://codeforces.com/problemset/problem/589/A 题目大意:给定n个邮件地址,任何电子邮件地址都将显示为“login @ domain”,其中: ...
- bootstrap 栅栏系统
媒体查询 /* 超小屏幕(手机,小于 768px) */ /* 没有任何媒体查询相关的代码,因为这在 Bootstrap 中是默认的(还记得 Bootstrap 是移动设备优先的吗?) */ /* 小 ...
- java 不定长参数
一,不定长参数的规定 一个方法只能有一个不定长参数,并且这个不定长参数必须是该方法的最后一个参数. 示例: public class VariArgs { public static void mai ...